CSV a Parquet con pandas, Polars y DuckDB
¿Qué motor usas para pasar un CSV a Parquet? Con 5 millones de filas, Polars tarda medio segundo y DuckDB deja el fichero más pequeño. Código incluido.
Tengo un CSV de 5 millones de filas y 381 MB. Leerlo entero con pandas funciona, pero cada consulta vuelve a analizar texto, inferir los tipos y recorrer columnas que no necesito. En Parquet, el mismo contenido ocupa 63–75 MB, se lee por columnas y lleva estadísticas para saltarse bloques que no hacen falta.
Este post es una guía práctica para convertir CSV a Parquet con pandas, Polars y DuckDB, con código que puedes copiar, un benchmark real y las trampas que aparecen cuando el esquema importa. Está inspirado en el artículo de Mark Needham sobre el mismo problema, pero con mediciones propias y versiones actuales.
Si aún no tienes claro qué es Parquet, empieza por Formato Parquet: 369 MB de CSV en 61 MB. Aquí voy directo a la conversión.
1. Por qué cambiar de CSV a Parquet
CSV es texto:
- Cada fila se analiza entera, aunque solo quieras una columna.
- Los tipos se infieren en cada lectura.
- No hay compresión ni estadísticas.
- Los nulos y las fechas se representan como texto.
- Un
SELECTsobre 10 columnas lee las 10.
Parquet es columnar:
- Solo lee las columnas que pides.
- Guarda tipos y metadatos.
- Comprime por columna con Snappy, ZSTD, Gzip o Brotli.
- Guarda mínimos, máximos y nulos por row group.
- Permite predicados y lectura paralela.
El cambio no es «de CSV a un formato binario raro»: es pasar de un fichero de intercambio a un formato de análisis.
2. El artículo de Mark Needham
Mark Needham convirtió un CSV de 12 millones de filas y 270 MB (rankings de tenis) a Parquet con tres herramientas y un contenedor limitado a 100 MB de RAM:
- pandas: funcionaba con 1 GB, pero el contenedor moría por OOM con 100 MB.
- Polars:
scan_csv+sink_parquet, unos 25 MB de Parquet. - DuckDB:
COPYconmemory_limit, unos 51 MB.
Su conclusión: pandas está bien si el fichero cabe en memoria; Polars y DuckDB aguantan ficheros más grandes. Este post actualiza la idea con un dataset distinto, versiones de 2026 y una comparación más detallada de esquema, compresión y row groups. DuckDB sirve además para consultar con SQL otros datos, como el historial de git.
Mark también grabó la conversión en vídeo para su canal, Learn Data with Mark. Lo tienes al final del post, junto a otro que explica qué cambia por dentro entre CSV y Parquet.
3. Benchmark: 5 millones de filas y 381 MB de CSV
El CSV sintético tiene:
| Dato | Valor |
|---|---|
| Filas | 5.000.000 |
| Columnas | 10 |
| Tamaño | 381 MB |
| Fechas | 1.000 días |
| Usuarios | 500.000 |
| Países | 10 |
| Dispositivos | 3 |
Nulos en notes | 10 % |
Columnas: event_date, user_id, session_id, country, device, page, revenue, quantity, is_active y notes.
El entorno:
- 16 vCPU, 27 GB de RAM.
- Python 3.12.13.
- pandas 3.1.0, PyArrow 26.0.0, Polars 2.1.0, DuckDB 2.0.0.
- Ficheros en
/tmp(tmpfs), sin cuello de botella en el disco. - Mediana de 3 ejecuciones por motor, con la caché caliente.
- Mismo
compression='zstd'yrow_group_size=100_000en todos. - pandas con motor C; además pruebo pandas con motor PyArrow.
- DuckDB con 4 hilos y
memory_limit='2GB'. - PyArrow directo como cuarto control.
No es un benchmark universal: es una foto de esta máquina y este dataset. Sirve para comparar órdenes de magnitud y para ver qué API te resulta más cómoda.
4. pandas: la vía directa
El código mínimo, con la documentación de to_parquet a mano:
1
2
3
4
5
6
7
8
9
10
11
12
13
import pandas as pd

csv = "events.csv"
out = "events.parquet"

df = pd.read_csv(csv, parse_dates=["event_date"])
df.to_parquet(
    out,
    engine="pyarrow",
    compression="zstd",
    row_group_size=100_000,
    index=False,
)
Resultado en mi prueba:
- 2,42 s de mediana.
- 74,3 MB de Parquet.
- 969 MB de RSS máximo.
event_dateacaba como TIMESTAMP, no como DATE.
Ventajas: una línea, APIs conocidas, ecosistema enorme. Desventajas: carga todo en memoria y el esquema lo decide pandas.
5. Motor PyArrow en pandas: 1,61 s y más memoria
Si el CSV es grande pero cabe en RAM, pandas puede usar el motor PyArrow y tipos Arrow:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
import pandas as pd

df = pd.read_csv(
    "events.csv",
    engine="pyarrow",
    dtype_backend="pyarrow",
    parse_dates=["event_date"],
)

df.to_parquet(
    "events.parquet",
    engine="pyarrow",
    compression="zstd",
    row_group_size=100_000,
    index=False,
)
Resultado:
- 1,61 s de mediana.
- 75,0 MB.
- 1.142 MB de RSS.
Es más rápido que el motor C en esta prueba, pero consume más memoria. Y sigue escribiendo la fecha como timestamp. Úsalo si ya estás en pandas y quieres acelerar la lectura, no si vas justo de RAM.
6. Polars en streaming: scan_csv y sink_parquet
Polars separa «leer» de «materializar», como explica su guía de sources y sinks:
1
2
3
4
5
6
7
8
9
10
import polars as pl

(
    pl.scan_csv("events.csv", try_parse_dates=True)
      .sink_parquet(
          "events.parquet",
          compression="zstd",
          row_group_size=100_000,
      )
)
Resultado:
- 0,49 s de mediana.
- 65,6 MB.
- 969 MB de RSS máximo.
event_datecomo DATE.
scan_csv no carga todo: construye un plan. sink_parquet ejecuta ese plan en streaming y escribe por lotes. La documentación de Polars lo describe como la forma de volcar resultados más grandes que la RAM.
En este dataset fue el más rápido. No siempre será así: con muchas columnas de texto, agregaciones o joins, el resultado cambia.
7. DuckDB: SQL + COPY
DuckDB convierte el CSV en una consulta SQL, con la sintaxis de COPY:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
import duckdb

con = duckdb.connect()
con.execute("SET threads=4")
con.execute("SET memory_limit='2GB'")
con.execute("SET temp_directory='/tmp/duckdb-spill'")

con.execute("""
COPY (
    SELECT *
    FROM read_csv_auto('events.csv', HEADER=TRUE)
)
TO 'events.parquet'
(FORMAT PARQUET, CODEC 'ZSTD', ROW_GROUP_SIZE 100000);
""")
Resultado:
- 1,09 s de mediana.
- 63,4 MB: el más pequeño.
- 921 MB de RSS.
event_datecomo DATE.
La sintaxis COPY permite leer el CSV en streaming, aplicar filtros o columnas calculadas y escribir el Parquet sin pasar por un DataFrame. Si ya piensas en SQL, es la opción más natural.
El memory_limit y el temp_directory importan: sin ellos, DuckDB puede intentar usar más memoria de la que le das y dejar ficheros incompletos en casos extremos.
8. PyArrow directo: control total del esquema
PyArrow es la capa que hay debajo de pandas y Parquet; su documentación de Parquet cubre compresión y encoding:
1
2
3
4
5
6
7
8
9
10
import pyarrow.csv as pv
import pyarrow.parquet as pq

table = pv.read_csv("events.csv")
pq.write_table(
    table,
    "events.parquet",
    compression="zstd",
    row_group_size=100_000,
)
Resultado:
- 2,07 s.
- 74,2 MB.
- 1.133 MB de RSS.
No es la opción más rápida, pero da control total sobre el esquema, las opciones de lectura y los metadatos. Es la que usaría si necesito un tipo exacto o escribir un dataset con un schema fijo.
9. ¿Quién gana? Polars en tiempo y DuckDB en tamaño
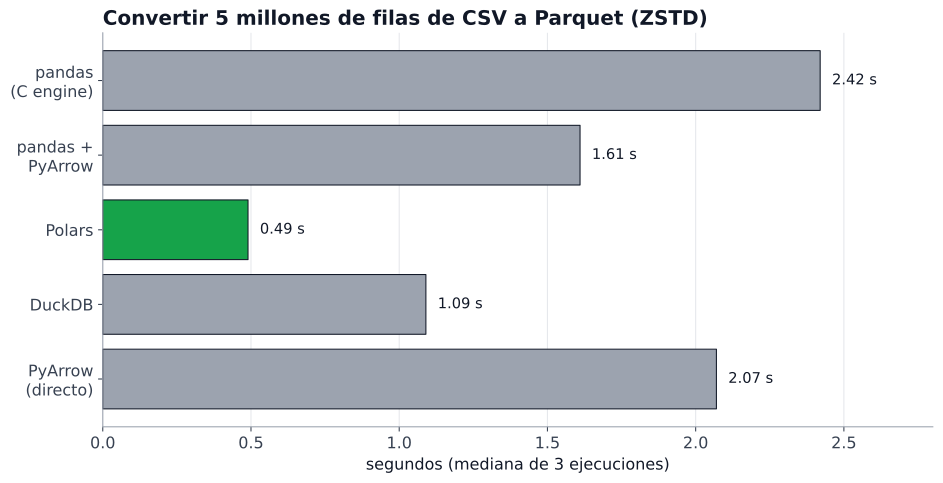
Mediana de 3 ejecuciones; mismo CSV, ZSTD y row group de 100.000.
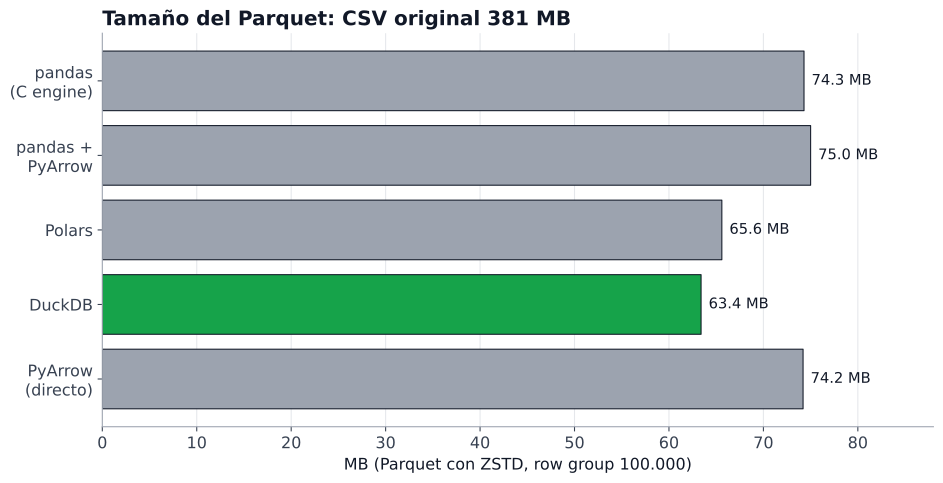
El CSV original pesa 381 MB; el Parquet, entre 63 y 75 MB.
Resumen:
| Motor | Tiempo | Tamaño | RSS máximo | Fecha |
|---|---|---|---|---|
| pandas (C) | 2,42 s | 74,3 MB | 969 MB | TIMESTAMP |
| pandas + PyArrow | 1,61 s | 75,0 MB | 1.142 MB | TIMESTAMP |
| Polars | 0,49 s | 65,6 MB | 969 MB | DATE |
| DuckDB | 1,09 s | 63,4 MB | 921 MB | DATE |
| PyArrow | 2,07 s | 74,2 MB | 1.133 MB | DATE |
Tres conclusiones:
- Polars es el más rápido en esta prueba, con diferencia.
- DuckDB genera el fichero más pequeño y el que mejor schema tiene por defecto.
- pandas no es lento, pero paga el coste de cargar todo y de un esquema menos preciso.
El RSS máximo incluye imports, páginas mapeadas y buffers del proceso; no es una medida pura de heap. Para comparar memoria real, usa cgroups o memory.max en un contenedor.
9.1 Lo que no mide este benchmark
Este benchmark mide una conversión completa en una máquina concreta. No mide:
- Consultas posteriores: ahí Parquet es mucho más rápido que CSV, pero depende de filtros y row groups.
- Ficheros con muchas columnas de texto o JSON anidado.
- Lectura desde S3, NFS o un disco lento.
- Concurrencia de varios procesos.
- Compresión distinta de ZSTD.
La caché del sistema está caliente: el CSV se generó y se leyó varias veces antes. En frío, la primera ejecución sería más lenta para todos. La conclusión útil no es «Polars es 5 veces más rápido siempre», sino «Polars y DuckDB tienen una API de streaming que evita cargar todo y, en este caso, además son más rápidos».
Si quieres repetirlo, el benchmark de liiink-it y el de henrikalbihn usan métodos parecidos con datasets distintos.
10. Compresión: ZSTD frente a Snappy y Gzip
El CSV son 381 MB. Los Parquet con ZSTD quedan entre 63 y 75 MB: 5–6 veces menos.
Compresiones habituales:
| Códec | Velocidad | Tamaño | Cuándo |
|---|---|---|---|
| Snappy | Muy rápida | Mayor | Compatibilidad y velocidad de escritura |
| ZSTD | Equilibrada | Menor | Recomendado por defecto |
| Gzip | Lenta | Similar o menor | Legado, no lo elegiría hoy |
| Brotli | Lenta | Muy competitivo | Cuando el tamaño importa más que la CPU |
En pandas:
1
df.to_parquet(out, compression="zstd", compression_level=3)
En Polars:
1
sink_parquet(out, compression="zstd", compression_level=3)
En DuckDB:
1
COPY (...) TO 'out.parquet' (FORMAT PARQUET, CODEC 'ZSTD');
ZSTD es un buen equilibrio: comprime más que Snappy y descomprime rápido. Si necesitas que un lector antiguo abra el fichero, Snappy es la apuesta segura.
10.1 Prueba de códecs con DuckDB
Mismo CSV y mismo row_group_size, cambiando solo el códec:
| Códec | Tiempo | Tamaño |
|---|---|---|
| Snappy | 0,83 s | 120,2 MB |
| ZSTD | 0,88 s | 63,3 MB |
| GZIP | 2,59 s | 69,7 MB |
En este caso ZSTD comprime casi el doble que Snappy con un coste de tiempo mínimo. GZIP tarda tres veces más y ni siquiera gana en tamaño. Por eso ZSTD es mi opción por defecto.
11. TIMESTAMP no es DATE
Este es el detalle que más me sorprendió:
- pandas con
parse_datesescribeevent_datecomo TIMESTAMP. - Polars, DuckDB y PyArrow la escriben como DATE.
No es un fallo: pandas representa fechas como datetime64[ns] y Parquet lo guarda como timestamp. Si tu consumidor espera DATE, el esquema no coincide.
Cómo evitarlo:
- Convertir a fecha antes de escribir:
df["event_date"] = df["event_date"].dt.date. - Usar un esquema PyArrow explícito con
pa.date32(). - O dejar que DuckDB lea el CSV y haga
event_date::DATEen elSELECT.
En un pipeline de producción, define el esquema una vez y verifícalo con DESCRIBE o parquet_metadata. No dejes que cada motor invente el suyo.
12. Verificar el Parquet: filas, columnas y metadatos
No basta con que el fichero exista. Comprueba filas, columnas y una agregación:
1
2
3
4
5
6
7
8
9
10
import duckdb

con = duckdb.connect()
print(con.sql("SELECT count(*) FROM 'events.parquet'").fetchone())
print(con.sql("""
    SELECT country, count(*) AS n, round(avg(revenue), 2) AS avg_revenue
    FROM 'events.parquet'
    GROUP BY country
    ORDER BY n DESC
""").fetchdf())
También puedes mirar los metadatos:
1
2
3
4
5
6
import pyarrow.parquet as pq

pf = pq.ParquetFile("events.parquet")
print(pf.metadata.num_rows)
print(pf.metadata.num_row_groups)
print(pf.schema_arrow)
En mi caso: 5.000.000 filas, 50 row groups y 10 columnas. Si el número de filas no cuadra, el problema casi siempre es el CSV (comillas, saltos de línea, encoding) o una inferencia de tipos que ha partido una columna.
13. Row groups y particiones
Un row group es un bloque de filas que Parquet lee por separado. Afecta a memoria, paralelismo y poda de predicados.
- 100.000 filas es un buen punto de partida para analítica.
- DuckDB usa 122.880 por defecto.
- La guía de Parquet recomienda grupos grandes (512 MB–1 GB) para escaneos secuenciales; para consultas selectivas, grupos más pequeños permiten saltar mejor.
- Como regla: al menos tantos row groups como hilos de consulta.
Particionar es otra cosa: crear carpetas por country, year o event_date. Útil si casi siempre filtras por esa columna; peligroso si generas miles de ficheros pequeños.
En pandas:
1
df.to_parquet("events/", partition_cols=["country"])
En DuckDB:
1
2
3
COPY (SELECT * FROM 'events.parquet')
TO 'events/'
(FORMAT PARQUET, PARTITION_BY (country));
En Polars, sink_parquet acepta PartitionBy. No partitions por defecto: mide primero.
13.1 Un ejemplo de partición
Si casi todas tus consultas filtran por country, particionar por país puede tener sentido:
1
2
3
COPY (SELECT * FROM 'events.parquet')
TO 'events_by_country/'
(FORMAT PARQUET, PARTITION_BY (country), CODEC 'ZSTD');
Genera una carpeta por país (country=ES/, country=US/…) y ficheros dentro. DuckDB, Polars y Spark leen ese directorio como un dataset y pueden saltarse particiones enteras.
Pero no lo hagas por user_id con 500.000 valores: acabarías con 500.000 carpetas y sus metadatos que gestionar. Para alta cardinalidad, mejor ordenar por esa columna y usar row groups con estadísticas, o un bucket hash. La guía de tips de DuckDB explica el equilibrio entre row groups, estadísticas y pruning.
14. Memoria y ficheros más grandes que la RAM
Pandas necesita el CSV entero en memoria. Si no cabe:
- Polars:
scan_csv+sink_parquet. - DuckDB:
COPYconmemory_limitytemp_directory. - pandas por chunks: escribe varios Parquet y luego únelos o consulta el directorio como dataset.
Ejemplo de pandas por chunks:
1
2
3
4
import pandas as pd

for i, chunk in enumerate(pd.read_csv("events.csv", chunksize=1_000_000)):
    chunk.to_parquet(f"events/part-{i:03d}.parquet", compression="zstd", index=False)
Esto no convierte el CSV «en un solo fichero», pero deja un dataset particionado que DuckDB, Polars o Spark pueden leer. Es la vía cuando la memoria es el límite y no quieres cambiar de herramienta.
15. Cuándo usar cada motor
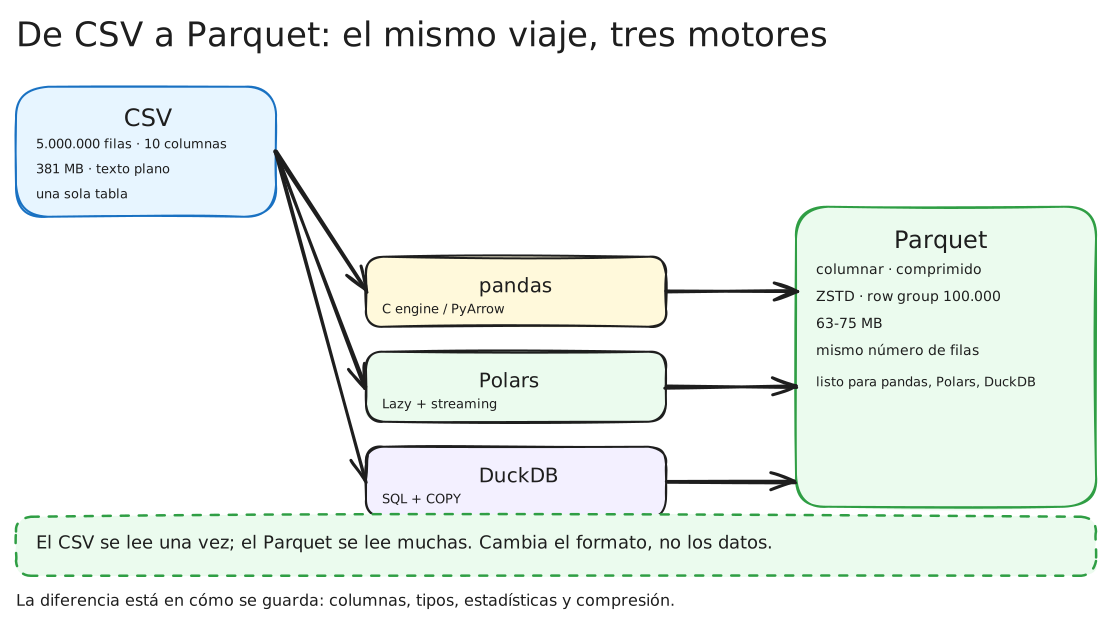
La misma conversión con tres motores. Cambia la API y el consumo, no los datos.
| Situación | Elección |
|---|---|
| CSV pequeño o mediano, ya usas pandas | pandas |
| Quieres la conversión más rápida | Polars |
| Quieres SQL, filtros o columnas calculadas | DuckDB |
| Necesitas control exacto del esquema | PyArrow |
| Fichero más grande que la RAM | Polars o DuckDB |
| Vas a leer con Spark | Parquet + clúster de Spark |
Mi elección por defecto: DuckDB si hay SQL de por medio, Polars si solo quiero convertir rápido, pandas si estoy explorando y el fichero cabe.
15.1 Cómo lo haría en producción
Para un pipeline repetible:
- Deja el CSV en una carpeta
raw/con fecha o versión. - Valida el esquema con una muestra y un contrato (
event_dateDATE,revenueDOUBLE, etc.). - Convierte con DuckDB o Polars a un fichero temporal.
- Comprueba filas, columnas y una agregación contra el CSV.
- Renombra el temporal al nombre final solo si todo cuadra.
- Publica el Parquet con una tabla de metadatos: origen, fecha, versión de la biblioteca y row groups.
- Lee el resultado con otro motor para detectar incompatibilidades de esquema.
Ese «renombrar al final» evita que un fallo a mitad de escritura deje un Parquet corrupto con nombre definitivo. Y la comprobación con otro motor evita sorpresas como la fecha TIMESTAMP de pandas.
16. Lo que se rompe al convertir
Inferencia de tipos distinta en cada motor. Revisa DESCRIBE y fija el esquema si vas a compartir el fichero.
Fechas como timestamp. Si necesitas DATE, conviértelo explícitamente.
CSV con comillas o saltos de línea. Prueba quotechar, escapechar y lineterminator; si el fichero está mal, ningún motor lo arregla.
Encoding. UTF-8 por defecto; si ves caracteres raros, prueba encoding="latin-1" y revisa los datos.
Nulos. NA, NULL, cadena vacía y NaN no son lo mismo. Define na_values y comprueba el resultado.
Decimales. Para dinero, float64 puede perder precisión. Usa Decimal/decimal128 si el consumidor lo necesita.
Índice de pandas. index=False evita una columna extra; si no, el índice se escribe como columna.
Muchos ficheros pequeños. Particionar por una columna con 10.000 valores genera demasiados ficheros y metadatos. Piensa en el patrón de consulta.
Benchmarks sin método. Una sola ejecución, caché fría, disco lento o distinto número de hilos cambia el resultado. Mide tu caso.
17. Doce comprobaciones antes de migrar a Parquet
- Define el esquema antes de convertir.
- Comprueba filas y columnas al terminar.
- Usa
ZSTDsalvo que necesites compatibilidad con Snappy. - Fija
row_group_sizesegún tus consultas. - No particiones sin medir el número de ficheros.
- Comprueba fechas, nulos y decimales.
- Lee el Parquet con otro motor para validar.
- Mide tiempo, tamaño y memoria en tu hardware.
- Guarda el script y la versión de las bibliotecas.
- Si el CSV no cabe, usa streaming o chunks.
- Documenta el esquema y el códec.
- Prueba una consulta real, no solo
count(*).
18. Enlaces y vídeos de interés
18.1 Artículos
- Parquet: file format — especificación y visión general.
- DuckDB: Parquet overview — lectura, escritura y metadatos.
- pandas: IO tools — CSV, Parquet y motores.
- Apache Arrow Python — la base de PyArrow.
18.2 Vídeos
Vídeo en inglés: Mark Needham hace la conversión del CSV de rankings de tenis con pandas, Polars y DuckDB, contenedor de 100 MB incluido. Es el vídeo del artículo que inspira este post.
Vídeo en inglés: qué cambia por dentro al pasar de CSV a Parquet — ventajas, inconvenientes y en qué casos cada formato sigue teniendo sentido.