Graphify desde cero: un grafo de tu código para Claude Code
Le hice 84 preguntas a Claude Code sobre datasette, con y sin un grafo del código: acierta más en arquitectura y gasta un 13 % más de tokens.
Cloné datasette en un contenedor, le construí un grafo del código y le hice catorce preguntas a Claude Code. Las repetí tres veces, con el grafo y sin él, hasta sumar 84 sesiones con el mismo modelo y el mismo repositorio.
Antes de seguir, qué es datasette. Es una herramienta para publicar datos: coge una base de datos SQLite y la convierte en un sitio web que puedes recorrer con el navegador, con sus tablas, un buscador y filtros por columna, y en una API JSON, con esa misma información en un formato que un programa puede leer. Un sistema de plugins añade vistas nuevas, formatos de exportación y reglas de permisos. La mantiene Simon Willison y es un proyecto de tamaño medio. En el paquete datasette/, el código que se ejecuta cuando usas la herramienta, hay unas 34.000 líneas en Python. En tests/, la carpeta con la suite que comprueba que todo sigue funcionando, hay 54.000: casi 1,6 veces más código de pruebas que de aplicación. La proporción tiene una explicación práctica: una herramienta que tiene que funcionar contra varias versiones de SQLite, con plugins de terceros y reglas de permisos que se combinan entre sí, se rompe de formas que solo se ven probando.
Lo elegí por tres motivos. Es un proyecto real que usa gente, no una demo preparada para que la herramienta quede bien. Es del tamaño justo para que un agente no pueda leerse el código entero de una sentada, y no llega a ser un monstruo de un millón de líneas. Y su sistema de permisos carga los plugins por nombre en tiempo de ejecución, que es justo el tipo de código que un análisis estático no ve: si el grafo falla, falla ahí, y quiero que se vea.
El resultado no es el que esperaba. En las preguntas de arquitectura, el grafo acertó el 96 % de los hechos que había fijado de antemano; sin él, el 72 %. Y sin embargo, el grafo gastó más tokens, un 13 % más de mediana. Las dos cosas son ciertas a la vez, y entender por qué es la mitad de este artículo.
La otra mitad es el recorrido completo: qué es un grafo de conocimiento del código, cómo se construye sin gastar un token, cómo se enchufa a Claude Code y a OpenCode, y qué pasa cuando lo usas para resolver un issue real del repositorio. La herramienta se llama Graphify y esto es lo que aprendí midiéndola.
Resumen en 30 segundos: Graphify convierte un repositorio en un grafo de símbolos y relaciones que tu agente consulta en lugar de abrir ficheros a ciegas. El código se analiza en local con tree-sitter y cuesta cero tokens. En mi prueba acierta más en preguntas de arquitectura e impacto, no ahorra contexto en un repositorio de tamaño medio y es la mejor herramienta que he probado para planificar un cambio antes de tocarlo.
1. El agente lee a ciegas y tú pagas la factura
Cuando le pides algo a un agente de código, lo primero que hace es buscar. Escribe un grep, mira qué ficheros aparecen y empieza a leerlos. En datasette, el fichero central, datasette/app.py, tiene 3.832 líneas y 146 KB. Cada vez que el agente necesita una función de ahí dentro, se traga el fichero o un trozo grande, y esos bytes se pagan como tokens de entrada.
El problema no está en el tamaño. Buscar texto y entender estructura son dos tareas diferentes. El análisis estático del que habla este post consiste justo en eso: leer la estructura sin ejecutar el programa. Piensa en un callejero y en el plano de un metro. El callejero tiene todas las calles, con su nombre y su número, y sirve para encontrar una dirección. El plano del metro no tiene calles: tiene estaciones y líneas, y sirve para responder «¿cómo llego de aquí a allí?» y «¿qué pasa si cierro esta estación?».
Un grep es el callejero. Encuentra la palabra cobrar en los ficheros donde aparece escrita, pero no sabe quién la llama desde otro fichero si allí se llama pagar o si la llamada está dentro de un getattr. El plano del metro es el grafo: no guarda el texto, guarda las conexiones.
Callejero (grep y lectura de ficheros) | Plano del metro (grafo del código) | |
|---|---|---|
| Qué guarda | Líneas de texto y su ubicación | Símbolos y las relaciones entre ellos |
| Para qué sirve | Encontrar una cadena exacta | Ver quién llama a qué y qué depende de qué |
| Qué se le escapa | Una llamada cuyo nombre no comparte palabras con el original | Código generado, despacho dinámico y plugins cargados por nombre |
| Coste de consultarlo | Bytes leídos del disco, que acaban en el contexto | Una consulta al grafo, que devuelve solo el entorno relevante |
Esa última fila es la promesa de Graphify y la que hay que poner a prueba, porque no siempre se cumple. Veremos que en un repositorio mediano el grafo devuelve un subgrafo más pequeño que el fichero, pero añade su propio contexto al principio de la sesión, y la cuenta sale diferente según lo que preguntes.
Los editores llevan años teniendo algo parecido: el servidor de lenguaje, o LSP, que responde «ir a la definición» y «buscar referencias» con precisión de compilador. La diferencia es que el LSP trabaja dentro del editor, responde una consulta cada vez, normalmente de un solo lenguaje, y no le deja el resultado a un agente para que lo recorra. Y hay un precedente directo de esta idea en los agentes: el mapa de repositorio de Aider, que manda al modelo un resumen de los símbolos importantes y lo recorta por relevancia.
2. Qué guarda de verdad un grafo del código
Un grafo es dos listas. La primera dice qué hay: los nodos, que aquí son símbolos (una clase, una función, un fichero) y también piezas de otro tipo, como una nota de diseño o un concepto sacado de la documentación. La segunda dice cómo se conectan: las aristas, cada una con un verbo (calls, imports, contains, inherits, uses) y una etiqueta que explica de dónde sale.
Para sacar los nodos del código no hace falta un modelo de lenguaje. Basta con partir cada fichero en su árbol de sintaxis abstracta (AST), que es la estructura del programa sin la decoración del formato. Esta línea de Python:
1
cobrar(p)
Se convierte en este árbol, tal como lo devuelve el módulo ast de la biblioteca estándar:
1
2
3
4
5
6
Module(
  body=[
    Expr(
      value=Call(
        func=Name(id='cobrar', ctx=Load()),
        args=[Name(id='p', ctx=Load())])))])
Del árbol se lee lo que interesa: hay una llamada, se llama cobrar y recibe un argumento. Repite eso por cada fichero y ya tienes nodos y aristas sin haber llamado a ningún modelo. Quien hace ese trabajo es tree-sitter, una biblioteca de análisis sintáctico que entiende unos cuarenta lenguajes, tolera errores de sintaxis y puede repasar un fichero entero en milisegundos.
Antes de meterme con un repositorio grande, lo probé con tres ficheros y cinco funciones, para ver qué sale:
1
2
3
4
5
6
7
8
9
NODO   crear()     code   pedidos.py L5
NODO   cobrar()    code   pagos.py L5
NODO   registrar() code   pagos.py L1
NODO   avisar()    code   correo.py L5
NODO   enviar()    code   correo.py L1
ARISTA crear()   calls  cobrar()    EXTRACTED  pedidos.py:L6
ARISTA crear()   calls  avisar()    EXTRACTED  pedidos.py:L7
ARISTA cobrar()  calls  registrar() EXTRACTED  pagos.py:L6
ARISTA avisar()  calls  enviar()    EXTRACTED  correo.py:L6
Y ya se puede preguntar:
1
2
3
4
$ graphify path "crear()" "registrar()"
Shortest path (2 hops):
  crear() --calls [EXTRACTED]--> cobrar() --calls [EXTRACTED]--> registrar()
Path confidence: EXTRACTED (weakest hop 1: calls)
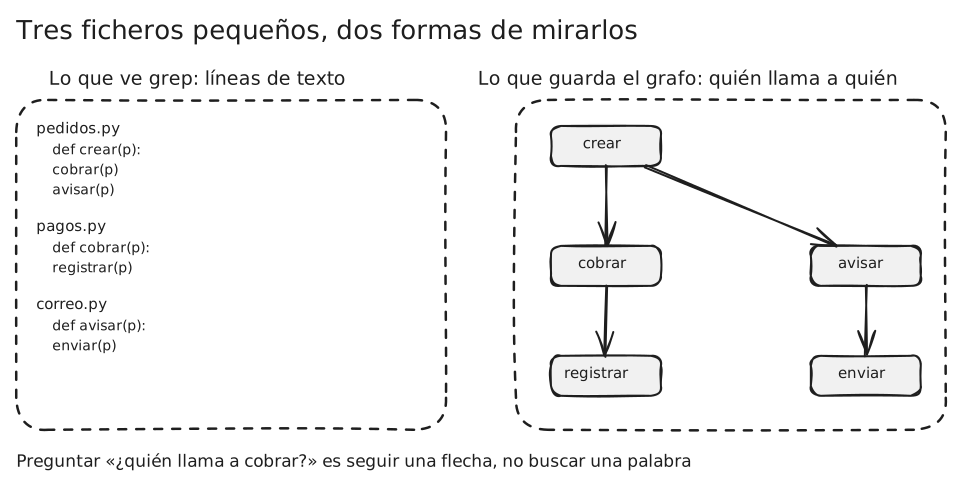
Cada arista lleva una etiqueta de confianza, y esa etiqueta es la parte más útil del diseño. EXTRACTED significa que la relación está escrita en el código y se leyó tal cual. INFERRED significa que la dedujo el resolutor, el paso que cruza ficheros para emparejar nombres, y lleva una nota de 0,55 a 0,95. Hay una tercera, AMBIGUOUS, para lo que no está claro y conviene revisar a mano. En datasette, de 18.676 aristas, el 87 % son EXTRACTED y el 13 % INFERRED; de estas últimas, casi todas llevan 0,85, y las de 0,95 son las que el resolutor considera casi seguras.
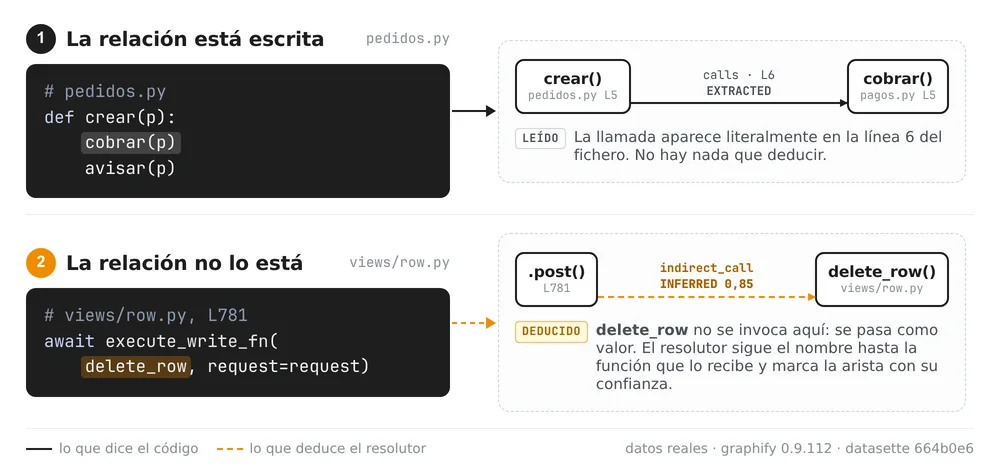
La distinción importa porque un agente puede confundir una deducción con un hecho. Cuando el grafo dice que Datasette «usa» RowView con una arista inferida, no está afirmando que el código lo llame: está diciendo que el resolutor encontró una referencia plausible en app.py. La documentación de procedencia insiste en lo mismo, y conviene tenerlo presente cada vez que una respuesta suene demasiado buena.
Merece la pena saber dónde encaja esto frente a las alternativas, porque no compiten por el mismo trabajo:
| Enfoque | En qué es bueno | Responde «¿qué se rompe si cambio esto?» |
|---|---|---|
| Grafo del código | Cómo se conecta el código entre ficheros | Sí, siguiendo aristas |
| Búsqueda vectorial | Encontrar texto parecido a tu pregunta | No directamente |
| Documentación escrita a mano | Onboarding y visión general | Solo si alguien lo escribió |
| Servidor de lenguaje (LSP) | Precisión mientras editas un proyecto | En parte, una consulta cada vez |
La búsqueda vectorial, la que usan casi todos los agentes con «memoria», compara trozos de texto por parecido semántico. Sirve para encontrar la documentación de un concepto; falla cuando dos funciones que se llaman no se parecen en nada por su nombre ni por su prosa. GraphRAG resuelve ese hueco en el mundo de los documentos, y la idea de fondo es la misma que aquí: guardar las relaciones explícitas en vez de confiar en que un vector las adivine.
3. Tres pasadas: lo que no cuesta tokens y lo que sí
Graphify no trata igual todos los ficheros, y aquí se mezclan dos preguntas que conviene separar: ¿interviene un modelo? y ¿sale algo de tu máquina? Son cosas diferentes, porque un modelo también puede ejecutarse en local.
Con el código no interviene ninguno: tree-sitter lo analiza en tu máquina y el resultado es siempre el mismo. El audio y el vídeo sí pasan por un modelo, Whisper, pero se ejecuta en tu máquina y tampoco manda nada fuera. Solo los documentos, los PDF y las imágenes necesitan un modelo de lenguaje, y ahí eliges dónde: el de tu agente, una API con clave o uno local como Ollama.
| Qué analiza | ¿Modelo? | ¿Sale de tu máquina? | Coste |
|---|---|---|---|
| Código | No, tree-sitter | No | 0 |
| Audio y vídeo | Sí, Whisper | No | 0 |
| Documentos, PDF, imágenes | Sí, modelo de lenguaje | Depende del que elijas | Tokens |
Si no quieres que salga nada, --code-only se salta la tercera fila y el grafo se construye sin conexión.
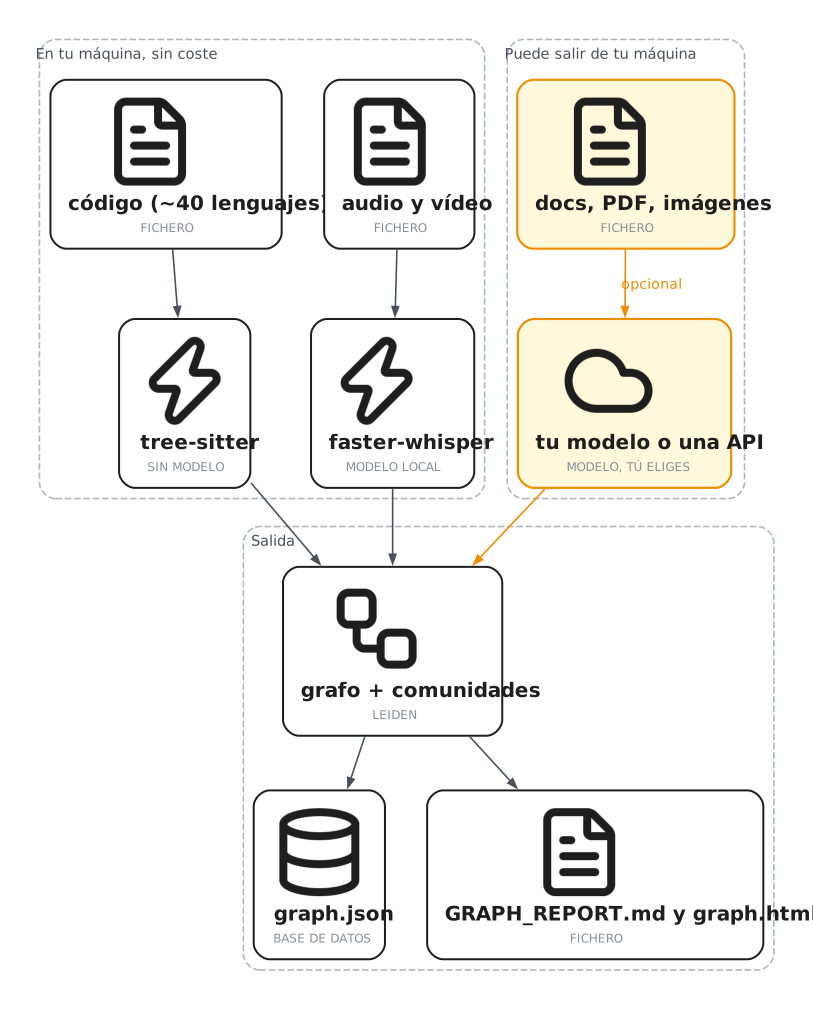
La primera pasada es la del código, y es la que hace el trabajo pesado: tree-sitter, cero llamadas de red, cero tokens. La segunda transcribe audio y vídeo con faster-whisper, que es un modelo pero se ejecuta en tu máquina: la primera vez descarga los pesos y luego trabaja sin conexión. La tercera es la única que puede enviar datos a un proveedor, y también la única que factura tokens; por eso se puede desactivar sin tocar las otras dos.
3.1 Lo que no es código también acaba en el grafo
Aquí está la parte que casi ningún tutorial cuenta: la tercera pasada no convierte documentos en texto indexado, los convierte en nodos con el mismo formato que el código. Un PDF sobre el diseño de un sistema entra como nodo de tipo paper; una página de la documentación, como document; los comentarios # NOTE: y # WHY:, y las decisiones de arquitectura citadas en el código, como rationale. Los vídeos pasan antes por Whisper y se incorporan como transcripción.
Para qué sirve de verdad: el código dice qué hace una función; los documentos dicen por qué se hizo así y cómo se configura. Si el agente puede recorrer los dos, contesta «¿por qué este hook devuelve
None?» mirando la nota del autor, no adivinando. También hay un comando pensado para eso:graphify section "Configurar permisos"imprime esa sección de la documentación sin abrir el fichero entero.
Merece la pena por tres casos concretos. Repositorios con buena documentación, donde media respuesta está en docs/ y no en el código. Proyectos con decisiones registradas, donde un ADR explica algo que el código ya no deja ver. Y corpus mixtos, como el que usa el propio proyecto para medir: código, cinco artículos y cuatro imágenes, donde el grafo reduce el contexto 71,5 veces frente a leerlo todo, según sus propias medidas.
La lista de formatos que entiende, con los extras que hay que instalar para cada uno, está en la documentación de entradas admitidas. Y para añadir material suelto hay una orden aparte: graphify add <url> descarga un artículo o un vídeo, lo transcribe si hace falta y lo engancha al grafo.
En este post no hice esa prueba, y conviene decirlo: mi prueba fue --code-only de principio a fin, así que todo lo que cuento sale de la mitad del código. datasette dejó fuera 116 documentos y 7 imágenes, que es justo el material que habría necesitado esa pasada.
Después de extraer, toca agrupar. Las comunidades son los subsistemas que aparecen solos al mirar qué nodos se conectan más entre sí que con el resto: el motor de plantillas, el sistema de permisos, las pruebas de una vista. Para eso usa el algoritmo de Leiden, un método de detección de comunidades que garantiza que cada grupo salga bien conectado por dentro; si le falta la dependencia opcional, cae en el método de Louvain de NetworkX, que es más antiguo y no da esa garantía. Ese cambio de algoritmo no avisa, y lo cuento entre los límites, más adelante.
El resumen técnico del proyecto añade dos detalles que explican su velocidad en repositorios grandes: cada fichero se guarda con su hash SHA-256 para no reanalizar lo que no cambió, y la extracción del código se reparte entre procesos en paralelo, esquivando el bloqueo del intérprete de Python.
La consecuencia práctica de esa separación: con --code-only no hay ninguna ruta que salga de la máquina, y el grafo se construye igual. Lo comprobé sin querer: el contenedor donde hice las pruebas no tenía clave de ningún proveedor, y el grafo salió completo.
4. Instalarlo desde el código fuente, en un contenedor aparte
Hay dos formas de instalar Graphify: desde PyPI con uv tool install graphifyy, como cuento en la guía de uv, o desde el código fuente. Elegí la segunda porque quería leer el código y ejecutar exactamente la misma versión que estaba leyendo, la 0.9.112.
El nombre del paquete lleva dos «y»:
graphifyy. El comando sigue siendographify. En PyPI hay otros paquetes con nombres parecidos que no tienen relación con el proyecto, y el README lo advierte porque ya ha habido confusión.
Y antes de instalar nada, una decisión: dónde. Yo no quería que la prueba tocara mi Claude Code, ni mi OpenCode, ni mi configuración global. Lo hice en un contenedor de Podman al que solo le monto un directorio de trabajo, con un HOME dentro del propio contenedor. Así, cuando el instalador escribe en ~/.claude o en ~/.config/opencode, escribe en una carpeta que se borra al terminar.
| Pieza | En mi máquina, sin tocar | En la prueba |
|---|---|---|
| Claude Code | Instalación global del sistema | npm install --prefix dentro del contenedor |
| Ajustes y sesiones | ~/.claude y ~/.claude.json | /lab/home/.claude, dentro del contenedor |
| Graphify | No instalado | uv tool install desde el código fuente |
| OpenCode | 2.2.7 del sistema | 2.3.0 del repositorio de Arch, dentro del contenedor |
| Repositorio de prueba | — | /lab/work/datasette, montado como volumen |
Empecé con Distrobox, que es lo natural en Arch, y lo descarté al comprobarlo: monta tu HOME real y hereda tu PATH, así que claude y which encontraban los binarios de fuera del contenedor. Un distrobox enter no te separa de tu sistema: es una caja con ventanas. Con Podman y un HOME propio, sí.
Para quedarme tranquilo hice inventario antes y después: un hash SHA-256 de 118.948 ficheros de ~/.claude, ~/.config/opencode, ~/.npm-global y las herramientas de uv. Al terminar, la diferencia entre las dos listas era de cero líneas.
Grabación real: clonar el código, instalarlo con los extras mcp, leiden y watch, clonar datasette y construir el grafo. Casi ocho segundos para 241 ficheros.
Los extras merecen una línea. mcp instala el servidor que expone el grafo por el protocolo de herramientas; leiden trae el algoritmo de comunidades correcto; y watch permite reconstruir el grafo al guardar un fichero. Se pueden añadir después; yo los puse de entrada para no repetir la instalación.
Si
graphifyno aparece después de instalarlo, ejecutauv tool update-shello abre una terminal nueva.uvdeja los binarios en~/.local/biny esa ruta no siempre está en elPATHde la sesión en la que instalaste.
5. Primer grafo de datasette: 7.845 nodos en ocho segundos
Cloné datasette en el commit 664b0e62, el mismo día que empecé la prueba, y lo analicé sin documentos, solo código:
1
2
3
git clone https://github.com/simonw/datasette.git
cd datasette
graphify extract . --code-only
La salida cuenta lo que ha hecho y lo que ha dejado fuera:
1
2
3
4
5
[graphify extract] found 241 code, 0 docs, 0 papers, 0 images
[graphify extract] 22 file(s) not classified (no supported extension or shebang), skipped
[graphify extract] 1 file(s) skipped as potentially sensitive: create_token.html
[graphify] Deduplicated 6 node(s) (3 exact, 3 fuzzy).
[graphify extract] wrote graphify-out/graph.json: 7845 nodes, 18676 edges, 324 communities
Siete segundos y medio después tenía un grafo de 7.845 nodos y 18.676 aristas. El graph.json ocupa 7,3 MB y el directorio entero, contando la caché, 19 MB. Ese es el coste en disco para un repositorio de 241 ficheros de código y unas 88.000 líneas en Python entre el paquete y las pruebas: 19 MB y ocho segundos.
Con eso ya se puede trabajar: graph.json es lo que leen query, path y explain, y no hace falta nada más. Lo que falta es la parte que lee una persona, y esa la escribe un segundo comando:
1
graphify cluster-only . --backend=claude-cli
Ese comando hace dos cosas. La primera es escribir el informe y el visor, GRAPH_REPORT.md (63 KB) y graph.html (488 KB). La segunda es poner nombre a cada comunidad: el algoritmo las encuentra y las numera, pero no sabe qué representan, así que sin modelo el informe habla de «Community 17» y con él de «Permission Enforcement». Ese nombre es lo que hace navegable la lista de la sección 6; un número no dice nada.
Por eso este es el único paso que llama a un modelo en una ejecución solo de código, y el único que cuesta. Tardó 39 segundos y anotó 115.659 tokens de entrada y 7.253 de salida, un coste que se paga una vez por reconstrucción y no por consulta.
Veamos qué se paga exactamente, porque es el único paso que gasta tokens sin analizar código. El algoritmo agrupa los 7.845 nodos en 324 comunidades, pero solo sabe numerarlas. Estas son las tres primeras del informe de datasette, tal como salen sin modelo y con él:
| Sin nombres | Con nombres |
|---|---|
| Community 0 · 117 nodos | Datasette Core Application · 117 nodos |
| Community 1 · 127 nodos | Saved Query Management · 127 nodos |
| Community 2 · 88 nodos | CodeMirror Editor Bundle · 88 nodos |
El modelo no vuelve a analizar el código para escribir esa etiqueta: recibe la lista de símbolos y ficheros de cada grupo y devuelve un nombre corto. Y ese nombre no se queda en el informe. Viaja pegado a cada nodo que devuelve una consulta, así que lo lee el agente, no solo tú:
1
2
3
NODE .allowed() [src=datasette/app.py loc=L2126 community=Permission Enforcement]
NODE .allowed_many() [src=datasette/app.py loc=L2157 community=Permission Enforcement]
NODE test_plugin_can_replace_statistics_policy() [src=tests/... loc=L68 community=Allowed Resources Listing]
Eso responde a para qué sirve, y sirve a las dos partes. A ti, porque convierte 324 números en un índice que puedes recorrer antes de decidir por dónde entrar: el grupo 0 es el núcleo, el 1 son las consultas guardadas y el 2 es el editor minificado que sobraba en el apartado 5.1. Y al agente, porque cada nodo llega etiquetado con su subsistema y puede saber que veinte símbolos pertenecen al mismo rincón del código sin abrir ninguno. Ese dato no cuesta un token más por consulta: viaja en la misma línea que el nodo.
Si no quieres pagarlo, --no-label deja los nombres genéricos y no llama a nadie: el grafo sigue siendo el mismo y las consultas funcionan igual. Lo único que pierdes es la etiqueta, en el informe y en cada nodo.
5.1 Un fichero que llena el grafo de ruido
La primera cifra que me hizo desconfiar fue el reparto de nodos. De los 7.845, 1.537 venían de un solo fichero: datasette/static/cm-editor-6.0.1.bundle.js, el CodeMirror compilado y minificado en un solo fichero que datasette sirve para su editor SQL. El grafo lo partió en símbolos de dos letras (ad(), an(), Ba()) y hasta le dedicó una comunidad llamada «Minified Editor Utilities».
Ese fichero también ponía ruido en las aristas: 89 de las 2.393 inferidas salían de ahí. Lo excluí con un .graphifyignore, el mismo formato que un .gitignore:
1
datasette/static/cm-editor-*.bundle.js
El grafo bajó a 6.311 nodos y 15.867 aristas, y la construcción a 5,84 segundos. Los diez nodos más conectados no se movieron ni una posición, que es la señal de que el bundle no aportaba estructura: solo volumen.
5.2 Cuánto tarda en repositorios más grandes
Dos pruebas más, para saber si los ocho segundos escalan. httpx, una biblioteca de 60 ficheros y 17.753 líneas, tardó 2,1 segundos y produjo 1.884 nodos: casi los mismos que la documentación del proyecto da como ejemplo, 1.883. Y Django, con 2.943 ficheros y 532.051 líneas de Python en el commit 102c3c3, tardó 53 segundos y produjo 54.882 nodos y 132.667 aristas.
| Repositorio | Ficheros .py | Líneas | Tiempo | Nodos | Aristas |
|---|---|---|---|---|---|
| httpx | 60 | 17.753 | 2,1 s | 1.884 | 3.969 |
| datasette | 187 | 88.932 | 7,9 s | 7.845 | 18.676 |
| datasette sin el bundle | 186 | 41.734 | 5,8 s | 6.311 | 15.867 |
| Django | 2.943 | 532.051 | 53,1 s | 54.882 | 132.667 |
Cincuenta y tres segundos para medio millón de líneas, en un contenedor, sin gastar un token. Esa es la parte de la herramienta que funciona mejor de lo que promete el marketing, y conviene decirla antes de entrar en lo que no.
6. Leer el mapa: comunidades, nodos centrales y ruido
El grafo se puede mirar de dos formas. La primera es GRAPH_REPORT.md, un documento de 1.278 líneas que empieza por un resumen y sigue por los nodos más conectados, las conexiones sorprendentes, los ciclos de importación y las preguntas que el propio grafo sugiere. La segunda es graph.html, un visor que se abre sin servidor y que dibuja la red con vis-network. Hay además otros formatos de exportación —GraphML, SVG, Obsidian y Cypher—, si prefieres mirarlo en otra herramienta.
En datasette, el HTML hace algo que hay que entender antes de juzgarlo: como el grafo pasa de 5.000 nodos, no dibuja los 7.845, sino una vista agregada en la que cada bola es una comunidad entera.
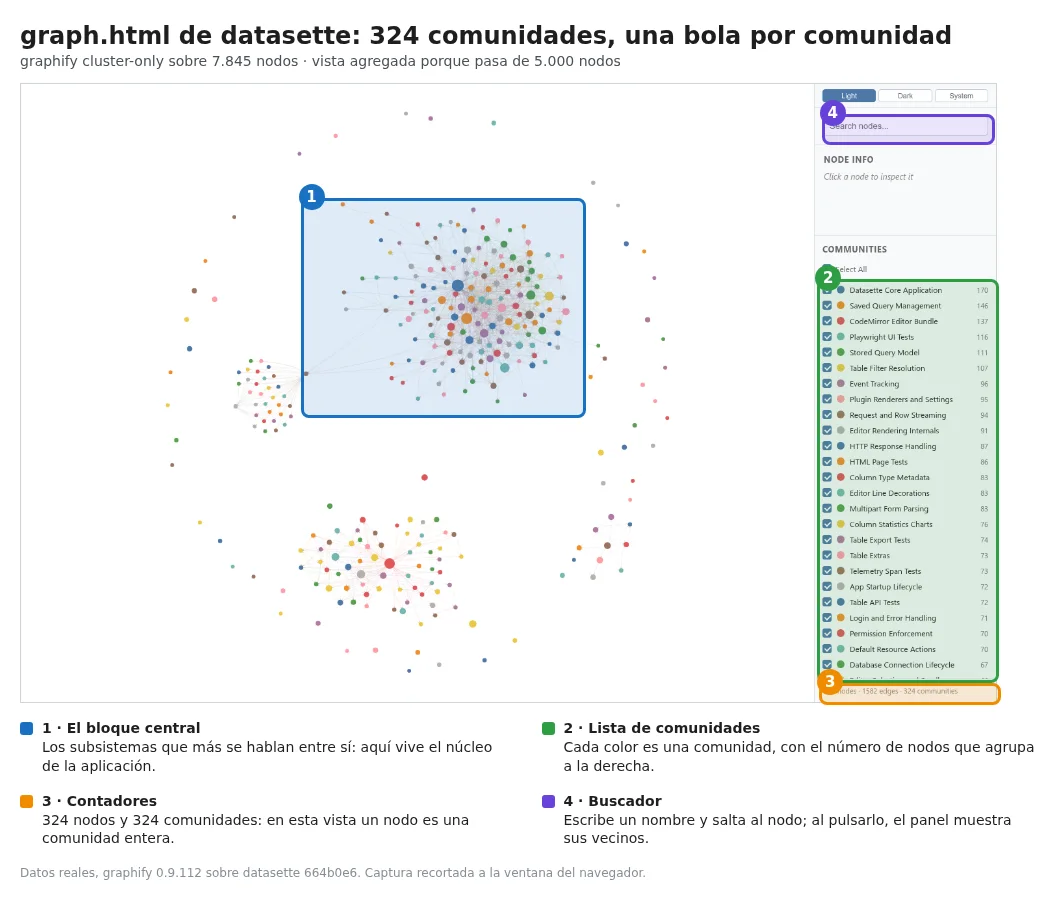
La lista de comunidades de la derecha es, en la práctica, un índice de subsistemas con nombres que salieron del propio código: «Datasette Core Application», «Saved Query Management», «Table Filter Resolution», «Permission Enforcement», «Telemetry Span Tests». Ese último es una pista útil: el detector no distingue código de pruebas, y en datasette las pruebas pesan más que la aplicación, como vimos al principio. Por eso medio grafo son funciones test_* y helpers como fixture() y make_ds(), que aparecen entre los diez nodos más conectados sin ser código de la aplicación. Las pruebas usan la introspección de SQLite para comprobar esquemas.
Los nodos centrales del informe confirman lo que cualquier lector del código sospecharía, y ahí está su valor: no hace falta leer 3.832 líneas para saber dónde mirar.
| Puesto | Nodo | Aristas | Qué es |
|---|---|---|---|
| 1 | Datasette | 744 | La clase que reúne configuración, bases de datos y plugins |
| 2 | TableResource | 143 | El recurso «tabla» del sistema de permisos |
| 3 | Response | 134 | La respuesta ASGI que devuelven las vistas |
| 4 | Request | 114 | La petición ASGI |
| 5 | PermissionSQL | 114 | El fragmento de SQL con el que se resuelven los permisos |
| 6 | Database | 108 | La conexión SQLite y su hilo de escritura |
Que Datasette salga con 744 aristas no es una sorpresa. Que PermissionSQL empate con Request sí es un dato: dice que el sistema de permisos de datasette no es un adorno, es una de las dos columnas vertebrales del proyecto. Y explica por qué las preguntas de permisos son las que mejor se contestan con el grafo, como veremos.
El informe también encuentra cosas que un humano tarda en ver. En datasette detectó seis ciclos de importación, entre ellos datasette/database.py → datasette/utils/sql_analysis.py → datasette/utils/__init__.py → datasette/database.py. Un ciclo no es un error, pero sí una señal: alguien importó algo de un módulo que a su vez importa del primero, y eso ata las dos piezas para siempre.
6.1 Bajar a un subsistema concreto
El visor agregado y la lista de comunidades sirven para ver la forma del repositorio entero. Para entender una pieza hay que aislarla, y eso es lo que hice con el sistema de permisos: quedarme solo con sus símbolos y sus vecinos inmediatos, y mirarlo aparte.
Lo elegí por dos motivos. Es una de las dos columnas del proyecto, como acaba de mostrar la tabla de nodos centrales, donde PermissionSQL empata con Request. Y es el que necesito entender para el cambio de la sección 10, así que no era un ejercicio de estilo.
Graphify no trae un comando del tipo «exporta esto y sus vecinos», así que lo monté con un script corto: cargar graph.json, quedarme con once símbolos del sistema de permisos y con sus vecinas directas del paquete datasette/, y guardar ese trozo como un grafo aparte.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
import json

g = json.load(open("graphify-out/graph.json"))
nodos = {n["id"]: n for n in g["nodes"]}

def en_datasette(i):
    return (nodos[i].get("source_file") or "").startswith("datasette/")

semilla = {i for i, n in nodos.items() if n["label"] in (
    ".allowed()", ".allowed_many()", "._allowed_many()", ".ensure_permission()",
    ".check_visibility()", "check_permissions_for_actions()",
    "gather_permission_sql_from_hooks()", "resolve_permissions_from_catalog()",
    "resolve_permissions_with_candidates()", "permission_resources_sql()",
    "PermissionSQL",
) and en_datasette(i)}

keep = set(semilla)
for e in g["links"]:
    if e["source"] in semilla and en_datasette(e["target"]):
        keep.add(e["target"])
    if e["target"] in semilla and en_datasette(e["source"]):
        keep.add(e["source"])

sub = {**g,
       "nodes": [nodos[i] for i in keep],
       "links": [e for e in g["links"] if e["source"] in keep and e["target"] in keep]}
json.dump(sub, open("sub/graph.json", "w"))
Con ese sub/graph.json la exportación es el comando normal. Le paso las etiquetas del grafo grande para que el subgrafo conserve los nombres de las comunidades:
1
2
graphify export html --graph sub/graph.json \
  --labels graphify-out/.graphify_labels.json
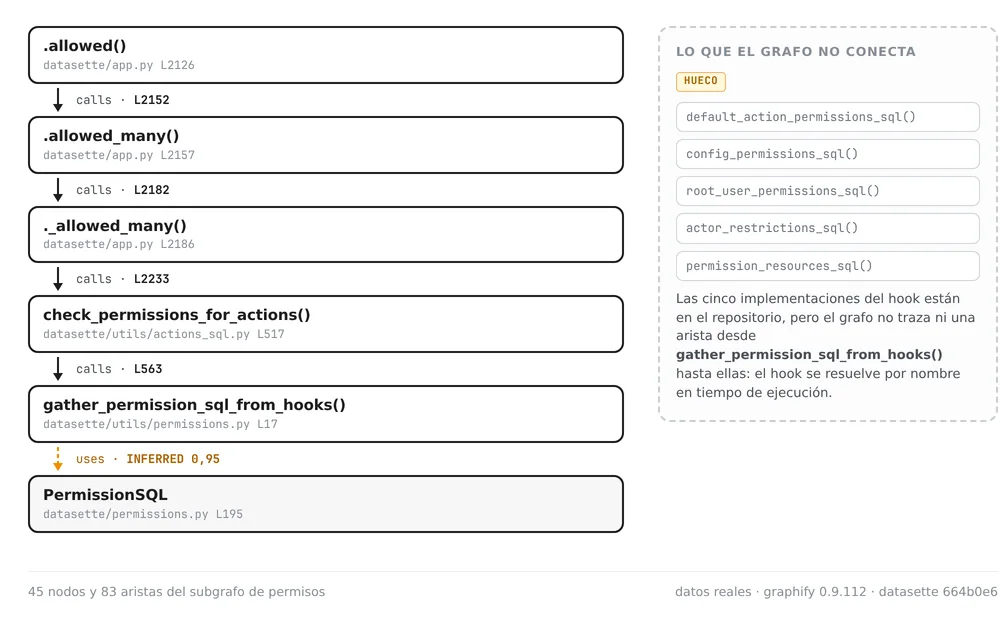
Salieron 45 nodos y 83 aristas. De todos ellos, la figura siguiente dibuja lo que de verdad se quería saber: en qué orden viaja una decisión de permisos, con la línea exacta de cada salto, y el punto donde el grafo deja de alcanzar.
7. Preguntarle sin abrir ficheros: query, path, explain y affected
La interfaz de consulta son cuatro órdenes. god-nodes lista los nodos más conectados; explain describe un nodo y sus vecinos; path traza la ruta más corta entre dos; affected recorre las aristas al revés para decir qué depende de algo. Y query hace una búsqueda por palabras clave y recorre el entorno de dos formas: primero los vecinos directos y después los vecinos de esos vecinos, o siguiendo una sola rama hasta el fondo. La guía de consultas llama a la primera bfs, por breadth-first search, y a la segunda dfs, por búsqueda en profundidad.
1
2
3
4
5
6
7
8
9
10
$ graphify explain ".allowed()"
Node: .allowed()
  Source:    datasette/app.py L2126
  Community: Permission Enforcement
  Degree:    54

Connections (54):
  --> Resource [references] [EXTRACTED] datasette/app.py:L2126
  --> .allowed_many() [calls] [EXTRACTED] datasette/app.py:L2152
  <-- test_plugin_restriction_intersection_and_dependencies() [calls] [INFERRED 0.85]
Con path se ve la cadena completa de una decisión de permisos, toda ella leída del código:
1
2
3
4
5
$ graphify path ".allowed()" "gather_permission_sql_from_hooks()"
Shortest path (4 hops):
  .allowed() --calls--> .allowed_many() --calls--> ._allowed_many()
  --calls--> check_permissions_for_actions() --calls--> gather_permission_sql_from_hooks()
Path confidence: EXTRACTED (weakest hop 1: calls)
Y con affected, el movimiento que de verdad ahorra tiempo cuando planeas un cambio:
1
2
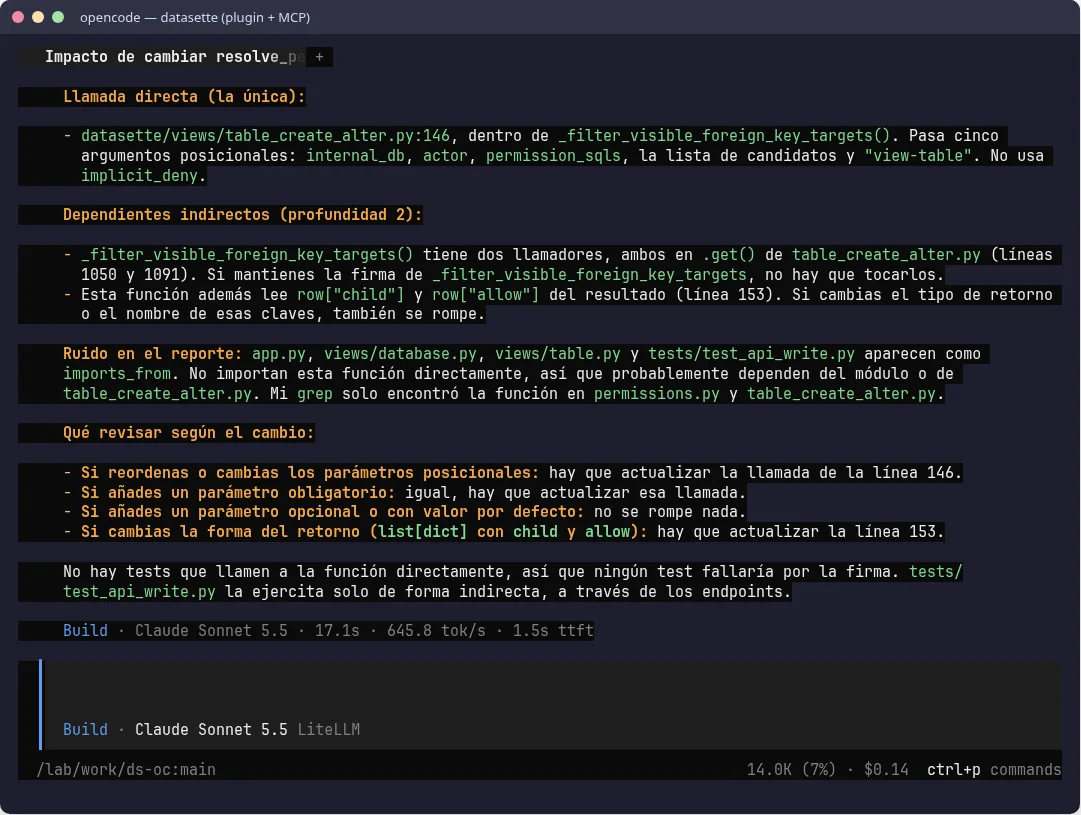
$ graphify affected "resolve_permissions_with_candidates()" --depth 1
- _filter_visible_foreign_key_targets() [calls] datasette/views/table_create_alter.py:L146
Una sola llamada de producción. Eso es exactamente lo que un agente necesita saber antes de tocar una firma, y lo que un grep tarda más en separar del ruido de las pruebas.
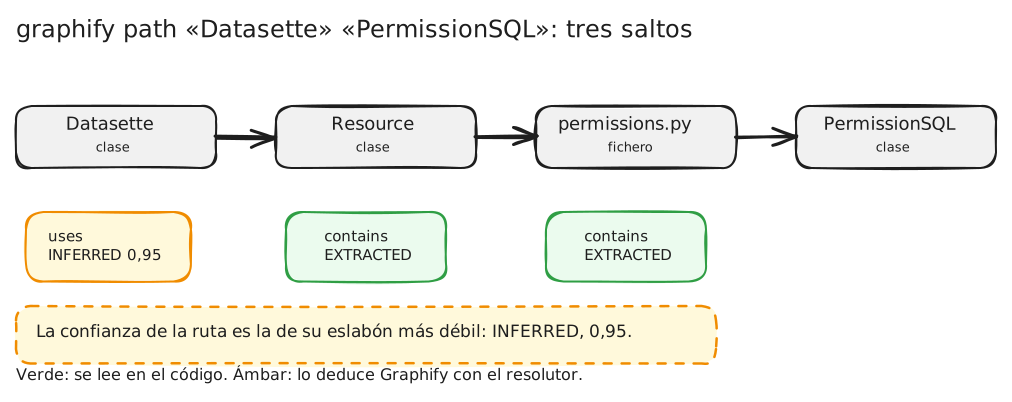
Ese diagrama muestra una trampa. La ruta más corta entre Datasette y PermissionSQL tiene tres saltos, pero pasa por un nodo de fichero: Datasette referencia Resource, el fichero permissions.py contiene a los dos. Es correcta y es casi inútil, porque no dice que uno llame al otro. La ruta de cuatro saltos de arriba, en cambio, es la que cuenta la historia. Cuando un agente te dé una ruta, mira los verbos: calls e imports describen comportamiento; contains solo describe en qué fichero está algo.
7.1 El tamaño de cada respuesta
Aquí está la comparación que importa para el contexto. Analicé la salida de cada comando sobre datasette y la puse al lado de la alternativa de buscar y leer:
| Consulta | Salida | Bytes |
|---|---|---|
graphify path | 3 líneas | 257 |
graphify god-nodes --top 10 | 11 líneas | 312 |
grep de una función en todo el repo | 16 líneas | 1.449 |
graphify affected --depth 1 | 17 líneas | 1.496 |
graphify explain de una función | 42 líneas | 2.963 |
graphify query por defecto | 63 líneas | 6.517 |
GRAPH_REPORT.md completo | 1.278 líneas | 66.091 |
datasette/app.py | 3.832 líneas | 146.015 |
graph.json | — | 7.891.369 |
La lección es doble. Por un lado, path y god-nodes son casi gratis: trescientas veces menos que abrir app.py. Por otro, query en lenguaje natural devuelve más que un grep porque no sabe qué quieres: en mi primera prueba, la pregunta «¿cómo decide datasette si un actor puede ver una tabla?» arrancó en check(), actor() y Datasette, encontró 2.223 nodos y se detuvo al llegar al límite de tokens que tenía puesto, recomendándome subirlo a 81.726 para verlo todo.
La solución está documentada y es la que usa un agente cuando se porta bien: fijar el punto de partida y filtrar por tipo de arista. Comparado con ripgrep, que devuelve coincidencias exactas al instante, el grafo cambia precisión por estructura.
1
graphify query "permission check" --seed ".allowed()" --context call --budget 800
Así la consulta devuelve 93 nodos en lugar de 2.223, y con 700 tokens se ve lo esencial. El comando query no busca en todo el repositorio: empieza por unas pocas palabras, salta de nodo en nodo y se para al agotar el límite, así que hay que darle una pista.
Sobre el tiempo, para que nadie se haga ilusiones: las consultas tardan entre 0,32 y 0,57 segundos de mediana en esta máquina, frente a 0,01 segundos de grep. El grafo no compite en velocidad; compite en la forma de lo que devuelve.
Grabación real: los nodos más conectados, una función con su fichero y su línea, una ruta entre dos piezas y el impacto de cambiar una firma. Cuatro consultas, ninguna lectura de código.
8. Enchufarlo a Claude Code: el aviso llega antes de leer
Aquí está lo que hace a Graphify diferente de una CLI con buena documentación. Graphify no se queda en la terminal: se instala dentro del agente. En Claude Code:
1
graphify claude install --project
Escribe tres cosas. Una skill en .claude/skills/graphify/SKILL.md con su carpeta de referencias, que añade el comando /graphify. Una sección ## graphify en el AGENTS.md del proyecto, el fichero de instrucciones abierto que Claude Code lee como memoria del repositorio. Y un .claude/settings.json con hooks:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
{
  "hooks": {
    "PreToolUse": [
      { "matcher": "Bash|Grep", "hooks": [
        { "type": "command", "command": "graphify hook-guard search", "timeout": 10 }] },
      { "matcher": "Read|Glob", "hooks": [
        { "type": "command", "command": "graphify hook-guard read", "timeout": 10 }] }
    ],
    "SessionStart": [
      { "matcher": "compact", "hooks": [
        { "type": "command", "command": "graphify hook-guard compact", "timeout": 10 }] }
    ]
  }
}
Los hooks de Claude Code se ejecutan antes de cada llamada a una herramienta y pueden devolver contexto o negarla; el instalador del proyecto es quien escribe ese JSON. Eso es lo que convierte un consejo en una regla. Lo probé simulando la llamada, y esto es lo que devuelve el hook cuando el agente intenta leer app.py:
1
2
3
4
5
6
7
8
graphify: this project has a knowledge graph at graphify-out/graph.json.
`graphify query "<question>"`, `graphify explain "<concept>"` and
`graphify path "<A>" "<B>"` show which files and lines matter.
Start with: `graphify explain "app.py"`
What the graph already has for this call:
- _DatasetteClientContext (datasette/app.py L181)
- PermissionCheck (datasette/app.py L194)
- .__enter__() (datasette/app.py L184)
El detalle que lo hace útil es el final: no solo dice «usa el grafo», sino que adelanta los símbolos que hay en la zona del fichero que se iba a leer. Un agente que vea eso puede decidir que no necesita abrir el fichero entero.
8.1 El modo estricto
El modo normal avisa. Hay un nivel más, que se activa al instalar con --strict. En ese modo, la primera lectura de un fichero indexado de la sesión se deniega, y solo se permite después de que el agente haya consultado el grafo.
1
2
3
graphify strict mode: this project has a fresh knowledge graph that covers this
file. Run `graphify query "<your question>"` (or `graphify explain` /
`graphify path`) FIRST to orient yourself, then re-issue this call.
Lo probé borrando el registro de la última consulta. En el primer intento de leer un fichero indexado, el hook responde deny; si el agente vuelve a intentarlo, ya solo le llega el aviso, así que no puede quedarse atascado. Y en cuanto ejecuta una consulta, la lectura se permite. El bloqueo queda desactivado durante los 30 minutos siguientes a cada consulta, y ese plazo se cambia con una variable de entorno.
El bloqueo es una vez por sesión y solo afecta a
Ready alGrepdedicado. Las búsquedas porBash,Globy los subagentes reciben un aviso, no una negación. Si esperas un muro impenetrable, no lo es: es una guía que el agente no puede ignorar la primera vez que va a leer un fichero.
9. La misma prueba en OpenCode: un aviso o un servidor
OpenCode es el otro agente que uso, y su integración es diferente porque su modelo de extensiones también lo es: plugins con hooks sobre las herramientas y servidores MCP declarados en el opencode.json. El instalador de Graphify escribe la skill en .opencode/skills/, la sección en AGENTS.md y un plugin en .opencode/plugins/graphify.js.
1
graphify opencode install --project
El plugin es corto y conviene leerlo entero, porque define el alcance de lo que hace:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
const REMINDER =
  'echo "[graphify] knowledge graph at graphify-out/. For focused questions, run '
  + 'graphify query with your question (scoped subgraph, usually much smaller than '
  + 'GRAPH_REPORT.md) instead of grepping raw files." ; ';

export default {
  id: `graphify-${location.toString(16)}`,
  async setup(ctx) {
    await ctx.tool.hook("execute.before", (event) => {
      if (event.tool !== "shell" || typeof event.input?.command !== "string") return;
      if (reminded.has(event.sessionID)) return;
      if (!hasGraph(ctx.location.directory)) return;
      event.input = { ...event.input, command: REMINDER + event.input.command };
      reminded.add(event.sessionID);
    });
  },
};
Traducido: el primer comando de shell de cada sesión sale con un echo delante que recuerda que hay un grafo. Ni bloquea ni redirige. Lo verifiqué en una sesión real de OpenCode, y el aviso aparece literalmente en la salida:
1
2
3
[graphify] knowledge graph at graphify-out/. For focused questions, run graphify
query with your question (scoped subgraph, usually much smaller than
GRAPH_REPORT.md) instead of grepping raw files.
La otra vía es un servidor del Model Context Protocol, y esa sí expone herramientas de verdad. graphify-mcp lee el graph.json y publica diez, con los parámetros de cada una en la referencia de herramientas: query_graph, get_node, get_neighbors, get_community, god_nodes, graph_stats, shortest_path y algunas más. Se registra en el opencode.json del proyecto:
1
2
3
4
5
6
7
8
9
10
{
  "mcp": {
    "servers": {
      "graphify": {
        "type": "local",
        "command": ["graphify-mcp", "/ruta/al/repo/graphify-out/graph.json"]
      }
    }
  }
}
Con la configuración de OpenCode 2, que es la que usa mi instalación, la clave es mcp.servers; en versiones anteriores los servidores colgaban directamente de mcp. Comprobado con opencode mcp list:
1
✓ graphify  connected
Y una vez conectado, el agente lo usa sin que se lo pidas. En una sesión real le pedí los cinco nodos más conectados y la ruta entre dos símbolos, y OpenCode llamó a las herramientas del servidor:
1
2
const g = await tools.graphify.god_nodes({ top_n: 5 });
return await tools.graphify.shortest_path({ source: "Datasette", target: "PermissionSQL" });
La diferencia entre las dos integraciones se ve mejor en una tabla:
| Claude Code | OpenCode | |
|---|---|---|
Skill con /graphify | Sí | Sí |
Instrucciones en AGENTS.md | Sí | Sí |
| Aviso antes de buscar | Hook PreToolUse con símbolos de la zona | echo delante del primer comando de shell |
| Puede negar una lectura | Sí, con --strict, una vez por sesión | No |
| Herramientas consultables | Vía graphify-mcp | Vía graphify-mcp |
| Qué recomiendo | Instalación con hooks; --strict si el equipo quiere disciplina | El servidor MCP y olvidarse del plugin |
Si tuviera que quedarme con una sola, elegiría el servidor MCP en los dos casos: es lo único que convierte el grafo en algo que el agente puede llamar por su cuenta, sin depender del hook que se lo recuerda. Lo que el hook de Claude Code añade por encima es la negación, y eso solo compensa si el equipo quiere que no haya forma de saltarse el paso previo. Los agentes que hablan MCP ya están contados en otro post, donde conté cuánto contexto cuesta cada herramienta que le das.
10. Un cambio real: el issue 2994 de datasette
Hasta aquí, preguntas. La prueba de verdad es un cambio de código con tests, y encontré el caso perfecto en el repositorio: un issue abierto que describe un fallo de una línea.
En datasette/filters.py, cuando llega un parámetro que empieza por _search pero no es ninguno de los tres válidos, el código parte la clave por el separador _search_ y se queda con el segundo trozo:
1
search_col = key.split("_search_", 1)[1]
Si el parámetro es ?_searchfoo=bobcat, no hay segundo trozo, y eso lanza un IndexError que acaba en un error 500, el caso que una API no debería devolver nunca. Lo reproduje antes de tocar nada: 500 en la tabla con índice de búsqueda, y 200 en una tabla sin él, que es el efecto lateral que el propio issue advertía.
Le pasé el issue a Claude Code con una instrucción explícita: usar el grafo antes de tocar código. Esto es lo que hizo, en orden:
graphify query "SearchFilters in datasette/filters.py: who uses it and which tests cover it".graphify explain "search_filters()"ygraphify path "search_filters()" "Filters".graphify explain "_table_filters()"ygraphify explain "TableResource".- Dos lecturas de fichero:
datasette/filters.pyytests/test_filters.py.
Con eso delante propuso un plan de cuatro pasos y me pidió elegir entre dos fixes: ignorar el parámetro desconocido o devolver un 400. Elegí el 400, que es lo que pide el issue, y lo implementó al revés de como suele hacerse: primero el test que falla, después el fix.
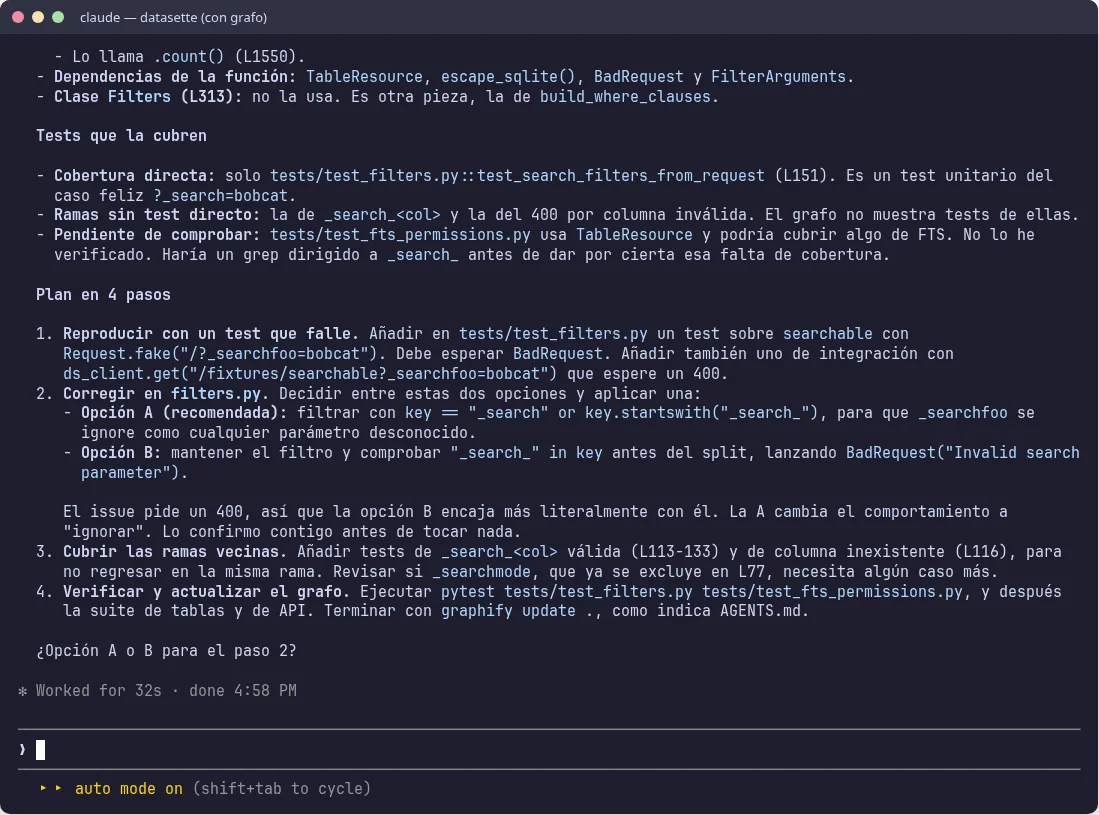
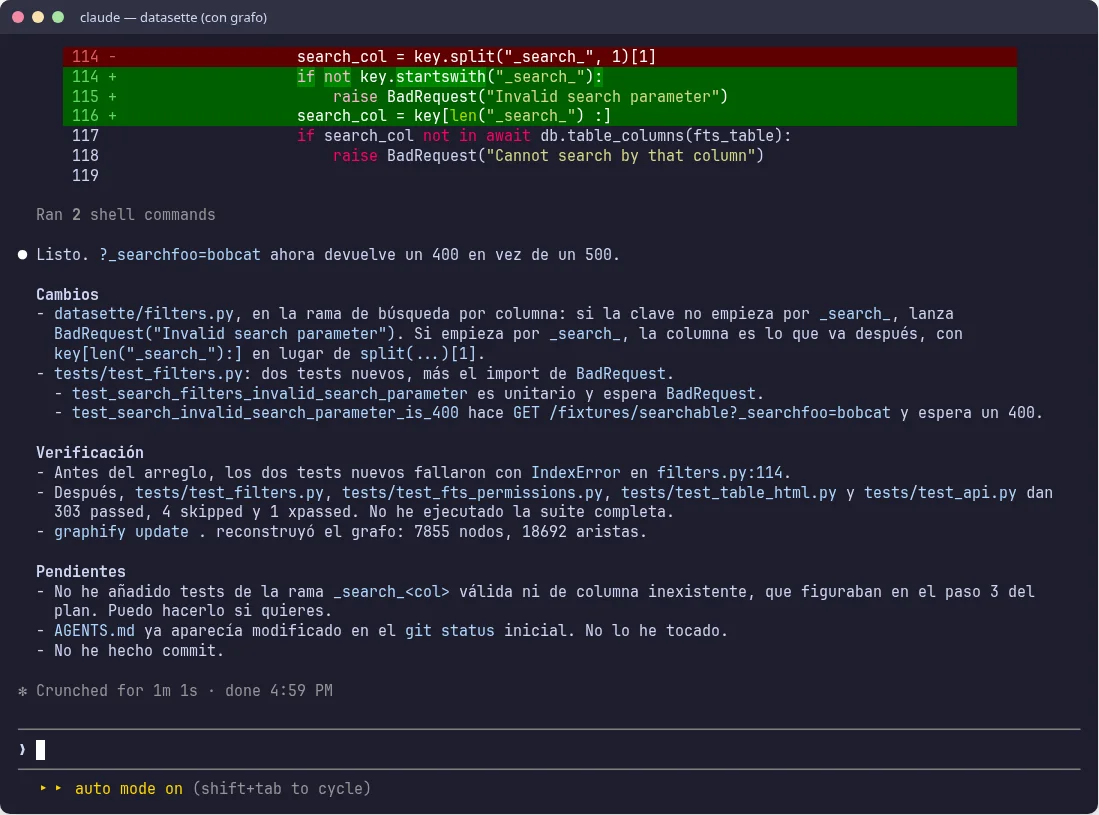
El cambio final son cuatro líneas:
1
2
3
4
5
6
7
8
9
10
11
12
--- a/datasette/filters.py
+++ b/datasette/filters.py
@@ -111,7 +111,9 @@ def search_filters(request, database, table, datasette):
             else:
                 # More complex: search against specific columns
                 for i, (key, search_text) in enumerate(search_args.items()):
-                    search_col = key.split("_search_", 1)[1]
+                    if not key.startswith("_search_"):
+                        raise BadRequest("Invalid search parameter")
+                    search_col = key[len("_search_") :]
                     if search_col not in await db.table_columns(fts_table):
                         raise BadRequest("Cannot search by that column")
Lo comprobé yo después, con la suite del proyecto:
1
2
3
4
$ .venv/bin/python -m pytest tests/_probe.py -s
PROBE /fixtures/searchable.json?_searchfoo=bobcat 400
PROBE /fixtures/facetable.json?_searchfoo=bobcat 200
PROBE /fixtures/searchable.json?_search=bobcat&_total=1 200
El 500 pasó a 400, la tabla sin índice sigue devolviendo 200 y la búsqueda correcta no falló. El agente cerró su informe reconociendo dos cosas: que no había añadido los tests de los casos cercanos que él mismo había propuesto, y que no había hecho commit.
Grabación real de la sesión completa: el plan, la decisión, el test que falla, el fix, los 303 tests y la reconstrucción del grafo. Casi dos minutos, a velocidad real.
¿Qué aportó el grafo aquí? No el fix, que es obvio una vez visto el split. Aportó el mapa: search_filters() tiene 88 líneas, la llama _table_filters(), y el nodo que las conecta con el resto del sistema es TableResource. Ese contexto es el que permitió proponer dónde poner los tests sin buscar a ciegas en una carpeta con 200 ficheros.
11. Ochenta y cuatro sesiones, mismo modelo y mismo repositorio
Esta es la parte que no encontré en ningún sitio, así que la hice. Monté dos copias del mismo repositorio: ds-plain, sin nada, y ds-graph, con el grafo, la skill y los hooks. Cada pregunta se lanzó a las dos, tres veces, con el mismo modelo y el mismo modo de permisos.
- Agente: Claude Code 2.1.326, en modo no interactivo (
claude -p), dentro del contenedor. - Modelo: Claude Sonnet 5.5, a través de una pasarela LiteLLM compatible con la API de Anthropic.
- Repositorio: datasette en
664b0e62, 241 ficheros de código. - Preguntas: 14, de tres tipos. «Quién llama a X» e inventarios de ficheros; «qué rompe si cambio X»; y preguntas de arquitectura abiertas.
- Corrección: cada respuesta se puntúa contra una lista de hechos que fijé antes de lanzar las sesiones, comprobados con búsquedas en el código; no contra una impresión.
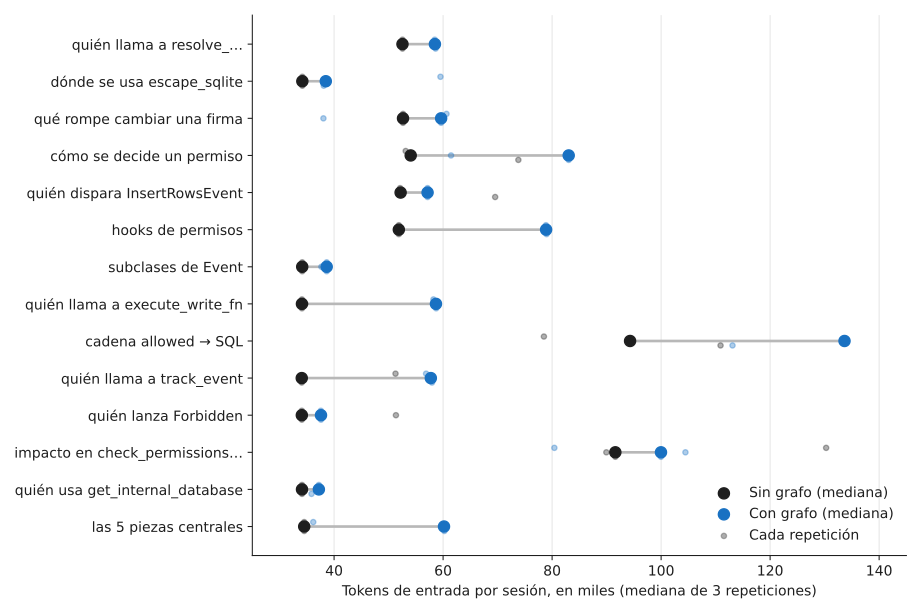
Y aquí está el resumen, que conviene leer entero antes de sacar conclusiones:
| Sin grafo | Con grafo | |
|---|---|---|
| Sesiones | 42 | 42 |
| Tokens de entrada, mediana | 51.613 | 58.483 |
| Tokens de entrada, media | 51.779 | 64.479 |
| Acierto medio de hechos | 95,4 % | 99,4 % |
| Respuestas con todos los hechos | 37 de 42 | 41 de 42 |
| Coste de las 42 sesiones | 1,63 | 1,83 |
| Duración mediana | 10,9 s | 12,7 s |
El grafo cuesta un 13 % más de mediana y un 24 % más de media, y acierta más. Pero la mejora no está repartida: se concentra en un tipo de pregunta.
| Tipo de pregunta | Preguntas | Sin grafo | Con grafo |
|---|---|---|---|
| Llamadas («quién llama a X») | 2 | 100 % | 100 % |
| Inventarios («qué ficheros usan X») | 6 | 100 % | 100 % |
| Impacto («qué rompe si cambio X») | 3 | 100 % | 100 % |
| Cadena de llamadas completa | 1 | 92 % | 100 % |
| Arquitectura («cuáles son las piezas centrales») | 2 | 72 % | 96 % |
En diez de las catorce preguntas, el agente acierta lo mismo con grafo y sin él. Para un inventario, un grep con -l es difícil de mejorar, y el agente lo sabe hacer. Donde el grafo cambia el resultado es en las preguntas que no se contestan buscando texto: cuáles son las cinco piezas centrales, cómo se encadena una decisión de permisos, de dónde cuelga un cambio.
11.1 Por qué no ahorra tokens
La explicación tiene tres partes, y la primera pasa por entender cómo se factura el contexto: el proveedor cobra la entrada nueva, pero guarda en caché el prefijo que se repite entre llamadas. La segunda es el tamaño del repositorio: datasette cabe en el contexto de un modelo moderno, así que leer dos ficheros enteros no arruina la sesión. El grafo también ocupa sitio: el bloque de instrucciones que el instalador deja en AGENTS.md, el contexto que devuelve el hook y la salida de la consulta se suman al arranque de cada sesión. Lo aislé comparando sesiones con el mismo número de turnos: con dos turnos, la mediana pasa de 34.215 a 37.521 tokens; con tres, de 52.203 a 56.253.
La tercera parte es la más incómoda: el agente sigue leyendo ficheros. El grafo le dice dónde mirar, no le evita mirar. En una sesión típica con grafo, el agente hace una consulta, dos o tres lecturas y escribe la respuesta. Con grep, hace una búsqueda y una lectura. El grafo añade un paso y ahorra otro, y en un repositorio pequeño el intercambio sale empatado o en contra.
No traslades la cifra de «209 veces menos tokens» a tu factura. Esa cifra, que el propio CLI imprime con
graphify benchmark, compara el corpus entero (523.000 tokens) con el tamaño medio de un subgrafo (2.497). Es cierta, pero habla de otra cosa: cuánto contexto evitarías si la alternativa fuera meter todo el repositorio en la ventana. La cuenta de este post, que compara sesiones reales de un agente, da un 13 % más.
11.2 La estadística, sin adornos
Con 42 sesiones por condición, la diferencia entre 37 y 41 respuestas perfectas no es concluyente: una prueba exacta de Fisher da un valor p de 0,20. Y si quito la pregunta de arquitectura con el resultado más extremo, la diferencia desaparece del todo. Lo que puedo defender con estos datos es más estrecho que un titular: el grafo mejora las respuestas a preguntas de arquitectura en un repositorio que el agente no conoce, y no ahorra contexto en ese tamaño de repositorio.
Para el resto de la historia hacen falta más repositorios y preguntas más difíciles. La prueba está montada y los datos son públicos; lo que falta es tiempo de cálculo, no método.
12. Mantenerlo al día y lo que no aguanta
Un grafo que se queda viejo es peor que no tener grafo, porque el agente confía en él. Graphify trae tres mecanismos para que no pase.
El primero es graphify update ., que reanaliza solo lo que cambió. Cronometrado en el contenedor: sin cambios, 8,57 segundos; después de tocar un fichero, 5,33 segundos. El segundo es graphify hook install, que escribe hooks de git para post-commit, post-checkout, post-merge y post-rewrite, y registra un merge driver para que dos ramas no se peleen por el graph.json. Lo probé con un commit real: 0,05 segundos, porque la reconstrucción va en segundo plano, y el grafo quedó marcado con el commit nuevo. El tercero es graphify watch ., que reconstruye al guardar; con la caché caliente reanalizó 28 de 241 ficheros y dejó el resto intacto.
El grafo anota el commit del que sale.
GRAPH_REPORT.mdlleva una sección con el hash, ygraph.jsonguarda el mismo dato. Si el agente te da una respuesta rara, compara ese hash congit rev-parse HEADantes de culpar a la herramienta.
12.1 Los límites que encontré
Ninguna herramienta es gratis, y estos son los costes que vi con mis propios ojos:
- El HTML se resume por comunidades a partir de 5.000 nodos. Con 7.845, cada bola es una comunidad. Para ver símbolos hay que pedir un subgrafo, con
--node-limito filtrando antes. - Leiden se sustituye por Louvain sin avisar si falta el extra. Cambia el reparto de comunidades, y con él los nombres del informe. Si te importa la reproducibilidad, instala el extra.
- Las extensiones ambiguas se adivinan.
.hpuede ser C o C++,.mObjective-C o MATLAB,.incPHP o Pascal. El proyecto lo resuelve con un.graphifyrc, y si no lo declaras el fichero se analiza como el lenguaje equivocado sin dar error. - Algunos ficheros se marcan como sensibles por error. En datasette,
create_token.htmlfue excluido por su nombre. Se renombra o se mueve, pero conviene saberlo antes de preguntarse por qué falta. - El despacho dinámico es invisible. Lo comprobé con el sistema de plugins de datasette, que usa pluggy:
gather_permission_sql_from_hooks()llama al hookpermission_resources_sql, y el grafo no tiene ni una arista hacia las cinco implementaciones que hay en el repositorio. Sabe que existe el hook, no quién lo implementa. Es el límite de un análisis estático, y conviene tenerlo presente. - En repositorios enormes, el ruido gana. En Django, los cinco nodos más conectados son
override_settings,SimpleTestCase,TestCase,reverse()yskipUnlessDBFeature(): utilidades de pruebas, no arquitectura. El grafo es correcto y la respuesta es inútil. - El registro de consultas es opcional, aunque el README diga otra cosa. El código lo deja apagado salvo que pongas
GRAPHIFY_QUERY_LOG_ENABLE=1, y el comentario explica por qué: registrar preguntas sobre código propietario contradice su postura de no telemetría. La documentación del README se quedó atrás, y el issue que lo cambió explica el motivo. - La instalación global escribe en tus agentes. Si usas Ansible o dotfiles para gestionar
~/.config/opencode, una instalación global se peleará con tu configuración. Usa--project: escribe dentro del repositorio, se versiona con él y se va con él.
Con eso sobre la mesa, la decisión se puede tomar sin fe:
| Tu situación | Qué haría |
|---|---|
| Repositorio pequeño que el agente ya maneja | Nada; el grafo no te va a ahorrar nada |
| Repositorio mediano que el agente no conoce | Grafo con --code-only, y consultas con --seed |
| Monorepo o código heredado de cientos de miles de líneas | Grafo, .graphifyignore para el código de terceros y el servidor MCP |
| Antes de cambiar una firma o mover un módulo | graphify affected, siempre |
| Equipo que quiere disciplina | --project con hooks, y --strict si el orden importa |
| Código con requisitos de confidencialidad | --code-only; nada sale de la máquina |
Si tu agente ya acierta con un grep, un grafo no le hace mejor: le hace más lento. Si falla en las preguntas de arquitectura, de impacto o de «por dónde empiezo», un grafo del código es la pieza que le faltaba, y merece la pena pagar el 13 %.
13. Enlaces y vídeos de interés
13.1 Artículos
- Graphify: guía de inicio del CLI — el recorrido oficial, útil para contrastar con el mío.
- Cómo se diferencian Graphify y el resto — la comparación oficial con búsqueda vectorial, documentación escrita y servidores de lenguaje.
- From Local to Global: A Graph RAG Approach — el artículo de Microsoft que puso nombre a GraphRAG y explica por qué las relaciones explícitas ganan en consultas globales.
- Flujos de trabajo en equipo — qué cambia cuando el grafo se comparte y se revisa en cada pull request.
- Graphify: resolución de problemas — los fallos de instalación y de análisis que la documentación recoge, y que yo no tuve que usar.
13.2 Vídeos
Recorrido por Graphify con Claude Code sobre un repositorio grande, con el visor de grafo en pantalla. En inglés.
Visión general de la herramienta y de la idea de consultar el grafo en lugar de buscar texto; útil como contraste con las cifras de este post. En inglés.
Charla de GitHub Universe sobre tree-sitter, el analizador que hace posible la pasada gratuita de Graphify. Explica por qué un parser tolerante a errores cambia lo que se puede hacer con código ajeno. En inglés.