Linux 3.18: bpf(), OverlayFS y la regresión que no se fue
Linux 3.18 lleva OverlayFS a mainline, estrena el syscall bpf() y DCTCP, y sale con una regresión de bloqueo que sigue abierta.
Linux 3.18 se ha publicado hoy, 7 de diciembre de 2014, con OverlayFS en mainline, el syscall bpf() y DCTCP para redes de centro de datos. Llega tras siete release candidates y con una regresión de bloqueo que no retrasó la release. Se llama «Diseased Newt» y abre la merge window de 3.19, la última release de la serie 3.x.
Linux 3.18 se publicó el domingo 7 de diciembre de 2014, nueve semanas después de 3.17 y con la Navidad de por medio. La merge window había durado tres semanas en lugar de dos porque Torvalds estaba de viaje, y la rc1 no llegó hasta el 20 de octubre.
Siete release candidates después, el ciclo cerraba con una cifra más baja de lo habitual: 11.186 changesets sin merges y 1.428 desarrolladores hasta la rc6. Es la release más pequeña del año, unas 1.000 changesets por debajo de 3.16 y 3.17.
En el anuncio hay una frase que resume el ciclo: «I’d love to say that we’ve figured out the problem that plagues 3.17 for a couple of people, but we haven’t», escribió Torvalds en el correo de release. El problema era un bloqueo que Dave Jones llevaba semanas bisecando, que también afectaba a 3.17 y que solo golpeaba a unos pocos equipos. Torvalds decidió publicar igual: retrasar 3.18 habría metido la merge window de 3.19 en plenas Navidades.
Hay tres claves. La primera es el almacenamiento: OverlayFS sale de staging y entra en fs/, la pieza que necesitan los contenedores para apilar capas sin copiar. La segunda es la programación: bpf() abre el kernel a programas que se cargan desde espacio de usuario, con verificador y JIT. La tercera es la red: DCTCP, Geneve, Foo-over-UDP y el envío por lotes cambian cómo se mueven los paquetes en un centro de datos.
Y un contrapeso: la regresión sigue ahí. Quien tenga el lockup no lo arregla con esta release, y el diagnóstico seguirá abierto en 3.19.
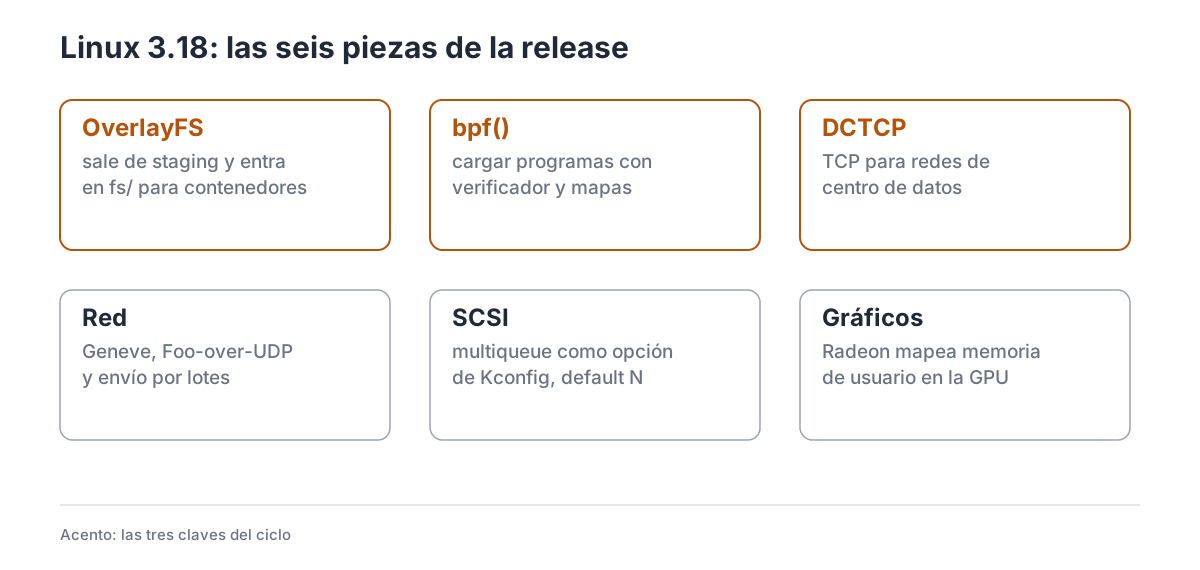
Las seis piezas del ciclo. En ámbar, las tres que cambian algo para quien administra o programa sobre Linux.
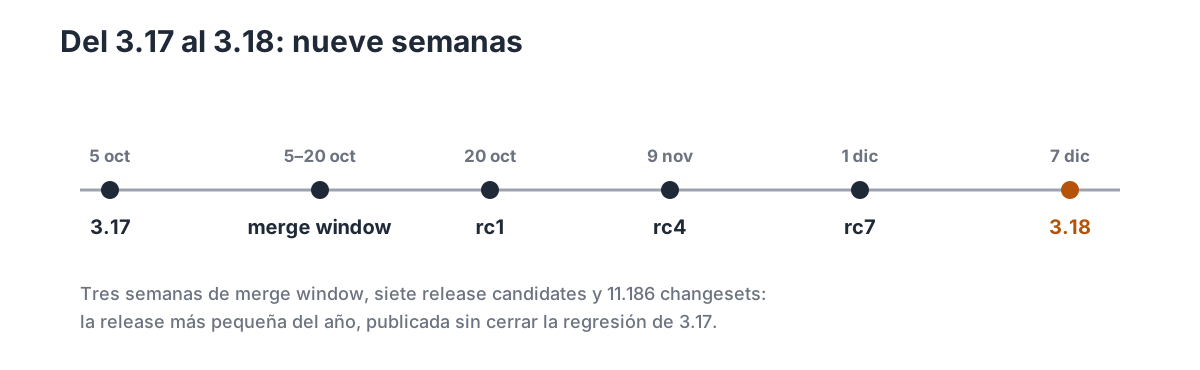
Del 3.17 al 3.18: tres semanas de merge window por los viajes de Torvalds, siete release candidates y un diciembre con la regresión aún abierta.
1. Las cifras de la release más pequeña del año
| Dato | Valor |
|---|---|
| Fecha de release | 7 de diciembre de 2014 |
| Versión anterior | 3.17 (5 de octubre de 2014) |
| Merge window | 5 al 20 de octubre de 2014 |
| Release candidates | 7 (rc1 el 20 de octubre, rc7 el 1 de diciembre) |
| Ciclo | 63 días |
| Changesets sin merges | 11.186 (hasta la rc6) |
| Desarrolladores | 1.428 |
| Nombre en clave | «Diseased Newt» |
| Regresión abierta | Un lockup que afecta a pocos equipos desde 3.17 |
Los números son de la tabla que LWN publicó el 25 de noviembre, contando hasta la rc6. La release se cerró dos semanas después, así que el recuento final es algo mayor; lo que no cambia es la comparación: 3.18 es la release más pequeña del año en changesets, y la tercera consecutiva que pierde fuelle. El recorte no viene de que falte trabajo, sino de la limpieza: el ciclo sigue borrando drivers de staging y código sin maintainer.
El reparto por autor lo confirma. H Hartley Sweeten vuelve a encabezar la lista con 237 changesets (2,1 %), casi todos en comedi; le siguen Mauro Carvalho Chehab con 179 (1,6 %), Ian Abbott con 162 (1,4 %) y Geert Uytterhoeven con 121 (1,1 %). Son nombres de mantenimiento y limpieza, no de feature nueva: el trabajo grande del ciclo lo firman otros con menos parches y más líneas.
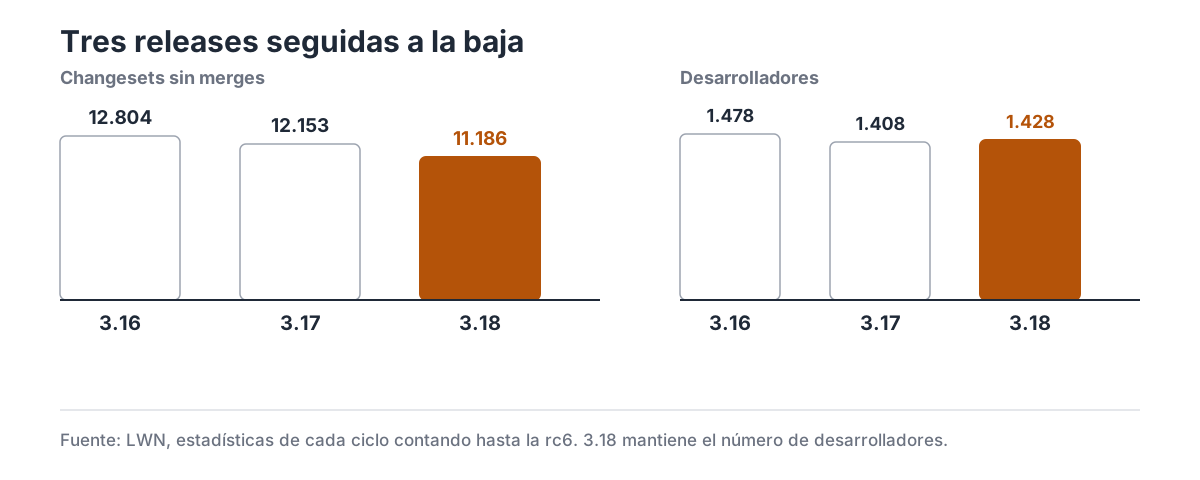
Tres releases seguidas a la baja. 3.18 es la más pequeña del año, con 1.428 desarrolladores.
2. OverlayFS: el sistema de ficheros de los contenedores
OverlayFS lleva desde 3.5 en staging y en 3.18 entra en fs/ con el commit de Miklos Szeredi. La idea es fácil de explicar y difícil de implementar: dos sistemas de ficheros, uno de solo lectura abajo y otro escribible arriba, se presentan como uno solo. Las lecturas van al de abajo; las escrituras, al de arriba. Si un fichero se modifica, se copia primero y luego se escribe, y si se borra, se deja una marca en la capa superior.
OverlayFS se distingue de otras uniones en lo que ocurre después de abrir un fichero: las operaciones van directas al sistema de ficheros de debajo, sin pasar por la capa de unión. Eso simplifica el código y devuelve el rendimiento nativo en lectura, que es la operación dominante. Los detalles están en la documentación que entró con el merge.
Hay límites que conviene conocer. La capa superior tiene que ser escribible, admitir los atributos extendidos trusted.* y devolver d_type válido en readdir(); por eso NFS no sirve como capa superior. La capa inferior puede ser cualquier sistema de ficheros de Linux y no necesita ser escribible, y puede ser a su vez otro OverlayFS. Para un contenedor, eso significa que la imagen de solo lectura se comparte entre instancias y cada una escribe solo lo que cambia.
Para el usuario no hay cambios inmediatos: los contenedores que ya usaban overlayfs con el módulo de staging siguen igual, solo que ahora el código está en mainline y se mantiene como el resto. Para el administrador, es una pieza menos que compilar aparte. Y para el resto de la serie, es el principio de una historia que sigue en Linux 5.11, donde OverlayFS aprendería a montarse sin privilegios.
3. bpf(): el kernel estrena su máquina virtual
bpf() es una llamada al sistema que hace de multiplexor: recibe un comando y un conjunto de atributos, y sirve para cargar programas, crear mapas, consultarlos o adjuntarlos a un evento. El programa es bytecode de eBPF, una versión extendida del filtro de paquetes de Berkeley que añade llamadas a funciones del kernel y acceso a estructuras compartidas.
Lo que hace seguro todo esto es el verificador. El kernel analiza el programa antes de ejecutarlo y comprueba que termina, que no accede a memoria fuera de lo permitido y que los tipos cuadran; si algo no encaja, lo rechaza. Los programas se ejecutan hasta el final sin bloquear, y se pueden interpretar o compilar a instrucciones nativas con el JIT. Cuando el proceso que los cargó muere, se descargan solos.
En 3.18 los programas se pueden adjuntar a sockets y a tracepoints. Es el comienzo de lo que después sería media infraestructura del kernel: filtrado de paquetes, observabilidad, seguridad y redes programables. El commit principal es 99c55f7d47c0, de Alexei Starovoitov, y el merge con la documentación es b4fc1a460f30. LWN lo explicó en The BPF system call API, version 14.
Como en toda primera versión, hay límites: pocos tipos de programa, los mapas son básicos y no existe todavía la posibilidad de adjuntar eBPF a un tc o a un kprobe con la flexibilidad que llegaría después. Quien programe hoy con bpf() en 3.18 tiene que ceñirse a sockets y tracepoints.
4. DCTCP: TCP para el centro de datos
DCTCP, por Data Center TCP, es un algoritmo de congestión pensado para redes donde todos los enlaces son cortos, el ancho de banda es alto y las colas de los switches se llenan en milisegundos. En lugar de reaccionar solo cuando se pierde un paquete, usa el marcado ECN: el switch marca los paquetes cuando la cola supera un umbral, y el receptor devuelve esa marca al emisor, que reduce la ventana en proporción a cuántos paquetes venían marcados.
El resultado es menos latencia y más tolerancia a las ráfagas, que es lo que pide una red de servidores. El algoritmo entra en 3.18 con el commit de Daniel Borkmann y se activa por socket, con TCP_CONGESTION, o como algoritmo por defecto del sistema. La descripción original está en la página de DCTCP de Stanford.
El límite es de despliegue, no de código: DCTCP necesita que los switches marquen ECN y que los dos extremos lo entiendan. En una red donde el marcado no está configurado, el algoritmo se comporta como cualquier otro y no da la mejora. Para quien administre una red de centro de datos, la release pone la parte del kernel; configurar la red corre de su cuenta.
5. Red: Geneve, Foo-over-UDP y el envío por lotes
Tres cambios de red cuentan el resto del ciclo. El primero es Geneve, un protocolo de encapsulación que mete tramas de capa 2 dentro de UDP y añade opciones en formato TLV, de modo que cada fabricante puede definir metadatos sin cambiar el protocolo base. El commit es 0b5e8b8eeae4, de Andy Zhou, y el borrador está en la IETF. Open vSwitch lo usa para túneles entre hosts.
El segundo es Foo-over-UDP, que permite encapsular cualquier protocolo IP sobre UDP, incluidos los túneles IPIP, GRE y SIT. La razón es práctica: el hardware y las optimizaciones de UDP —ECMP, RSS, offloads— se pueden reutilizar para esos túneles. LWN lo contó en Foo over UDP.
El tercero es el envío por lotes, y es el que más se aprecia en las cifras. La tarjeta de red recibía un paquete por llamada y pagaba el coste de la puerta de entrada en cada uno; con el flag xmit_more, el kernel puede decirle al driver que quedan más paquetes y que no cierre la puerta todavía. El resultado que documentó el ciclo es 10 Gbit/s de wirespeed con el paquete más pequeño en un solo núcleo, 14,8 millones de paquetes por segundo. Los commits base son 5772e9a3463b y 4567dc109342, y LWN lo explicó en Bulk network packet transmission.
6. SCSI: la opción que faltaba
En 3.17 la capa SCSI estrenó su ruta por blk-mq, pero había que activarla a mano con scsi_mod.use_blk_mq=1. En 3.18 llega la pieza que faltaba: 24c20f105836, de Christoph Hellwig, añade CONFIG_SCSI_MQ_DEFAULT, una opción de Kconfig que compila el kernel con la ruta activada por defecto.
La opción trae N por defecto y el propio Kconfig recomienda dejarla así si no se sabe: activarla cambia el camino de E/S de todos los discos SCSI, y los drivers que no la admiten declaran disable_blk_mq. Una distribución puede activarla sin parchear, que era el objetivo; el usuario que compila su kernel decide. Para quien administre servidores con SCSI, 3.18 es la release en la que probarlo deja de requerir un parámetro de arranque.
7. Gráficos: Radeon mapea memoria de usuario
Intel estrenó en 3.16 la capacidad de mapear direcciones de usuario en la memoria de vídeo; en 3.18 le llega el turno a Radeon con el commit de Christian König. El resultado es que un buffer de la aplicación se puede usar como textura o como destino de render sin copiarlo antes a la GPU.
Se usa en aplicaciones que mezclan CPU y GPU: rasterizadores por software como el de Chromium, lectura de vuelta en Firefox y buffers de píxeles en OpenGL o blobs de OpenCL. Con userptr, la copia desaparece y el pipeline deja de esperar. El límite es el de siempre: la GPU tiene que poder acceder a esa memoria, y las páginas del proceso tienen que quedar fijadas mientras el dispositivo las usa, lo que puede afectar al rendimiento de la CPU si el buffer es grande.
8. El salseo: «Please don’t do back-merges»
No hubo cambio de maintainer ni reversión, pero sí una bronca que explica el tono de la época. El 12 de octubre de 2014, en plena merge window, Torvalds contestó al pull request del subsistema de seguridad de James Morris con un mensaje sobre los back-merges: merges de v3.16 dentro de las ramas de los maintainers, con mensajes como «Merge commit ‘v3.16’ into next».
El reproche se divide en tres partes: el merge no arreglaba ningún conflicto, el mensaje no explicaba nada y el asunto del correo no llevaba «git pull», así que su filtro no lo encontraba. «Please don’t do back-merges. What was the reason for that v3.16 merge?», empieza el mensaje. Torvalds pidió que, si había una razón, se documentara, y recordó que ya había escrito sobre lo mismo muchas veces; Morris respondió que esperaba algo «menos subjetivo». La discusión no cambió el código, pero muestra cómo se gestionaba el tree antes del código de conducta que llegaría años después.
9. Por subsistemas
9.1 Sistemas de ficheros
NFS 4.2 implementa SEEK (1c6dcbe5ceff, de Anna Schumaker), así que lseek() con SEEK_HOLE y SEEK_DATA funciona en servidores que lo admiten. F2FS añade escrituras atómicas (88b88a667971, de Jaegeuk Kim)) y FITRIM; ext4 permite congelar sistemas ext2 sin journal y publica en sysfs si el sistema tiene errores; SMB gana enlaces simbólicos (mfsymlinks) y mknod en SMB2 y SMB3.
9.2 Red
nftables estrena el masquerading de IPv4 (8dd33cc93ec9, de Arturo Borrero) y de IPv6, y puede filtrar desde pre-routing y post-routing. El timestamping y las colas de TCP siguen afinándose, UDPv6 gana GRO y el bridge añade default_pvid por sysfs. En Wi-Fi, el ciclo recupera el anuncio de cambio de canal para los drivers que lo admiten.
9.3 Seguridad y core
Smack añade un modo permisivo por etiqueta (d166c8024d62, de Casey Schaufler), útil para depurar políticas sin bloquear el sistema. prctl() estrena PR_SET_MM_MAP (f606b77f1a9e, de Cyrill Gorcunov), que permite a CRIU restaurar de una vez todas las propiedades de memoria de un proceso. Y el kernel ya compila con gcc 5 (71458cfc782e, de Sasha Levin).
9.4 Virtualización y bloque
Xen estrena el backend y el frontend de PVSCSI (d9d660f6e562, de Juergen Gross), que dan a los invitados acceso a dispositivos SCSI sin emular el hardware. En bloque, dm-raid añade discard en RAID 1, 4, 5, 6 y 10, y zram informa de la memoria máxima usada (461a8eee6af3, de Minchan Kim).
9.5 kbuild y módulos
make modules_install puede comprimir los módulos al instalarlos (beb50df39e91, de Bertrand Jacquin), viene bien en sistemas con poco espacio y en imágenes de contenedor. Es una opción de kbuild, no un cambio de formato: el kernel sigue cargando módulos comprimidos igual que antes.
10. Lo que no llega
- El lockup sigue abierto. Torvalds lo dijo en el anuncio: el problema que afecta a unos pocos usuarios de 3.17 no estaba resuelto, y Dave Jones seguía bisecando. Quien lo sufra no arregla nada actualizando a 3.18. Phoronix lo tituló «no arregla esa extraña regresión».
- SCSI multiqueue sigue siendo una decisión de compilación. La opción existe, pero su valor por defecto es
Ny el propio Kconfig recomienda no tocarla si no se sabe; la definición en el tree de 3.18 lo deja claro. - DCTCP necesita ECN en la red. El algoritmo está en el kernel, pero sin switches que marquen paquetes no hay mejora que medir; el artículo original de SIGCOMM describe el diseño y sus condiciones.
- OverlayFS no vale con cualquier capa superior. Necesita atributos
trusted.*yd_type; NFS queda fuera, como recuerda la documentación del kernel.
11. Cambios menores
Una selección de lo que no cabe en las claves, con su enlace y su consecuencia.
Core
- slab merge — reutilizar cachés de tamaño parecido en vez de crear otras.
- BUG al pisar la pila — opción para abortar cuando el final de la pila se sobrescribe.
- sin madvise ni fadvise — compilarlas fuera en sistemas que no las usan.
- más LRU de buffer-head por CPU — menos contiendas en cargas con mucho metadata.
Almacenamiento y ficheros
- FITRIM en f2fs — descartar bloques libres con
fstrim. - ext2 congelado en ext4 — las instantáneas de LVM funcionan también sin journal.
- errores de ext4 en sysfs — saber si el sistema de ficheros detectó corrupción.
- FIBMAP en NTFS — el ioctl que usan algunas herramientas de imágenes.
Networking
- GUE en ip_tunnel — el túnel UDP con el formato de Google.
- default_pvid en el bridge — VLAN por defecto configurable por sysfs.
- GRO para UDPv6 — agregar paquetes antes de entregarlos al socket.
Virtualización
- PVSCSI en Xen — frontend para invitados con discos SCSI.
- RAM mapeada en Xen — menos copias al arrancar dom0.
Tracing y perf
- perf-with-kcore — guardar el núcleo junto al perfil para symbolizar después.
- ancho de columna en perf top — ajustar la salida a pantallas estrechas.
12. Qué viene después
La merge window de 3.19 se abrió el 8 de diciembre y duró dos semanas: Torvalds quería cerrarla antes de Navidad. Linux 3.19 llegaría el 8 de febrero de 2015, con eBPF en sockets, Btrfs RAID 5/6 y execveat(), y sería la última release de la serie 3.x: en abril, el siguiente kernel se llamaría Linux 4.0.
Para quien administre sistemas, 3.18 es la release de OverlayFS y de la opción de SCSI: dos cambios que se activan al compilar o al montar, no al arrancar. Para quien programe, es la release en la que bpf() deja de ser una idea y se convierte en una API con la que experimentar. Y para quien siga la serie, es la release que demuestra que un kernel puede salir con una regresión abierta si el calendario aprieta.
La rama 3.18 duraría años: en marzo de 2015 su mantenimiento pasó a Sasha Levin y la última entrega fue 3.18.140, en mayo de 2019. La serie 3.x sigue en la página de la serie y el índice del kernel reúne las demás. La entrega anterior es Linux 3.17.