Linux 3.19: eBPF en sockets y el último kernel 3.x
Linux 3.19 cierra la serie 3.x con eBPF en sockets, execveat() y Btrfs RAID 5/6, y con el binder de Android ya fuera de staging.
Linux 3.19 se ha publicado hoy, 8 de febrero de 2015, con eBPF en sockets, execveat(), Btrfs RAID 5/6 y el binder de Android fuera de staging. Cierra la serie 3.x: dos semanas después, la siguiente release llegaría ya numerada como 4.0. Torvalds lo resumió diciendo que no había pasado nada especialmente emocionante.
Linux 3.19 se publicó el domingo 8 de febrero de 2015, 63 días después de Linux 3.18 y sin sobresaltos. Torvalds estuvo tentado de hacer una rc8, pero no encontró motivo: «while I was tempted a couple of times to do an rc8, there really wasn’t any reason for it», escribió en el anuncio. Es el tercer ciclo seguido de 63 días, y el último de la serie 3.x.
Las cifras confirman el ritmo. El ciclo metió 12.461 changesets de 1.422 desarrolladores y más de 200 empresas. Es algo más grande que 3.18 y mantiene la tendencia al alza en número de cambios. Intel aporta el 12 % del trabajo, Red Hat el 8,3 %, SUSE el 3,5 % y Samsung el 3,4 %; el autor con más parches vuelve a ser H Hartley Sweeten, con 463 changesets (3,7 %), casi todos en los drivers comedi de staging.
Hay tres claves. La primera es la red programable: eBPF deja de ser una llamada suelta y se puede adjuntar a un socket, que es el uso que la haría crecer. La segunda es la interfaz: execveat() añade una forma de ejecutar un fichero por descriptor, y Btrfs cierra dos huecos históricos en RAID 5 y 6. La tercera es el hardware: llegan el soporte de MPX, HSA y Coresight, y una arquitectura nueva, Nios II.
Y un contrapeso: el número no cambia aquí. 3.19 cierra la serie con el mismo esquema de numeración que 3.0; el cambio a 4.0 llegaría dos semanas después, cuando Torvalds anunciara que la siguiente release se llamaría así.
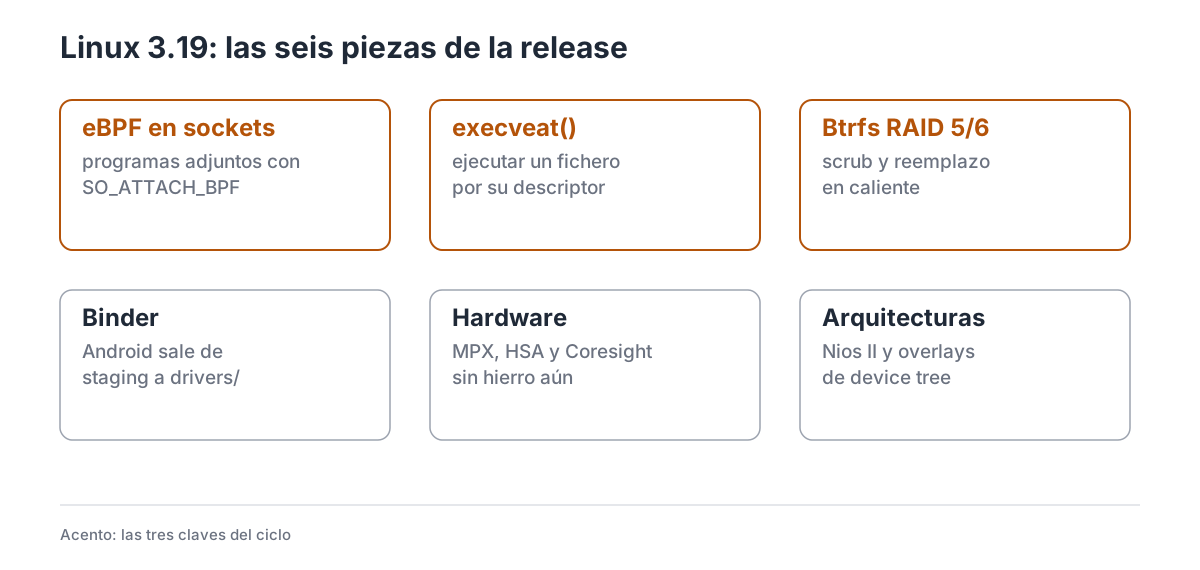
Las seis piezas del ciclo. En ámbar, las tres que cambian algo para quien administra o programa sobre Linux.
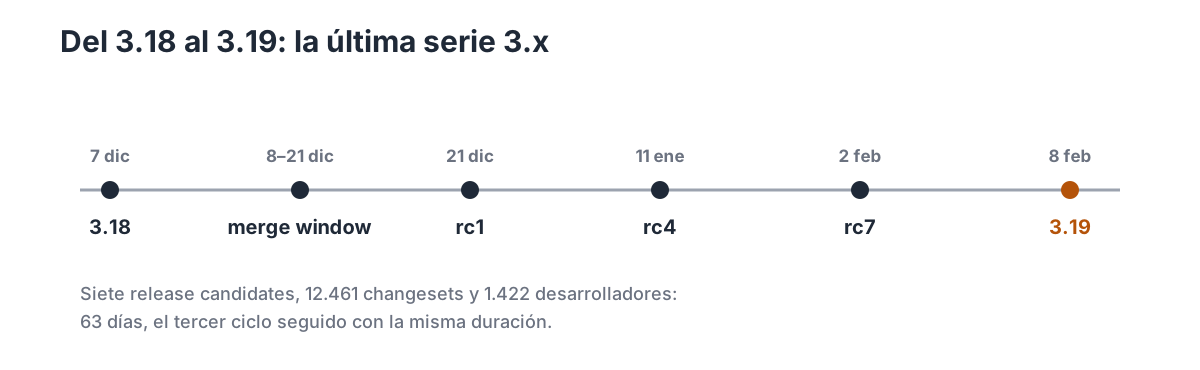
Del 3.18 al 3.19: una merge window de dos semanas antes de Navidad, siete release candidates y el cierre de la serie 3.x.
1. Las cifras del último 3.x
| Dato | Valor |
|---|---|
| Fecha de release | 8 de febrero de 2015 |
| Versión anterior | 3.18 (7 de diciembre de 2014) |
| Merge window | 8 al 21 de diciembre de 2014 |
| Release candidates | 7 (rc1 el 21 de diciembre, rc7 el 2 de febrero) |
| Ciclo | 63 días |
| Changesets | 12.461 |
| Desarrolladores | 1.422 |
| Empresas | más de 200 |
| Empresa con más cambios | Intel (12,0 %) |
| Autor con más changesets | H Hartley Sweeten (463) |
Los números son los de LWN, que publicó el reparto el 4 de febrero, con la rc7 ya fuera. 3.19 corta la bajada de 3.17 y 3.18: sube en changesets y mantiene el número de desarrolladores, con más de 200 empresas detrás. Intel lidera con 1.490 changesets (12,0 %), seguida de Red Hat con 1.029 (8,3 %), SUSE con 437 (3,5 %), Samsung con 420 (3,4 %) y Linaro con 362 (2,9 %). AMD, con 205, aparece por el trabajo de amdkfd y Radeon.
En cuanto a líneas, Malcolm Priestley encabeza la lista con 31.115 líneas (4,5 %), casi todas en el driver vt6655 de staging; le siguen Jeff Kirsher con 26.025 (3,7 %), por la retirada del driver bcm, y Hans Verkuil con 22.602 (3,3 %), en Video4Linux. Son nombres de limpieza, como en las dos releases anteriores: el kernel sigue borrando más líneas de las que añaden algunos ciclos.
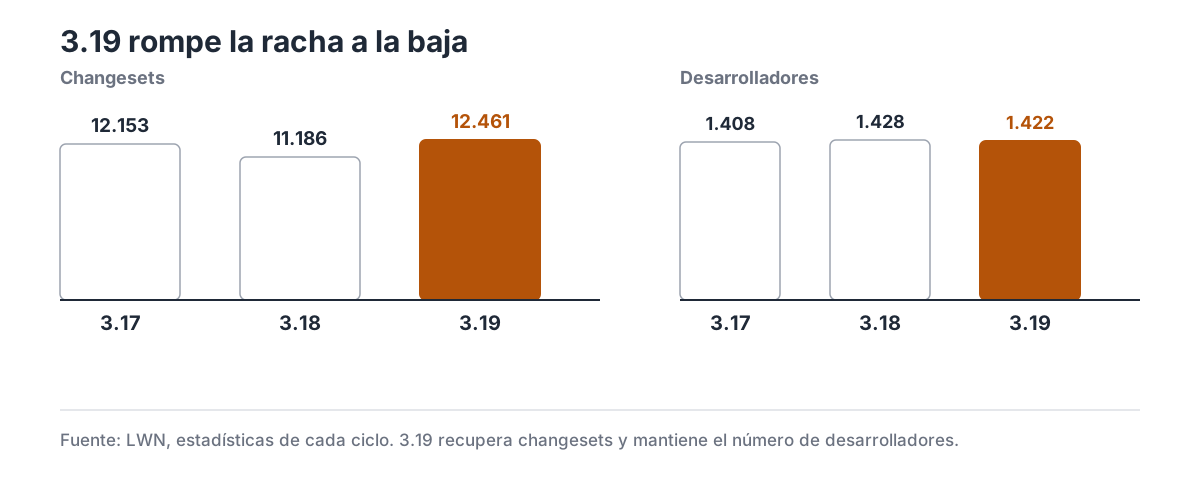
Tres releases, tres ciclos de 63 días. 3.19 recupera changesets y cierra la serie 3.x.
2. eBPF aprende a mirar los sockets
3.18 estrenó el syscall bpf() para cargar programas y crear mapas. 3.19 completa la pieza que faltaba: adjuntar un programa eBPF a un socket. El commit es 89aa075832b0, de Alexei Starovoitov, y hoy el uso parece obvio: se carga el programa con bpf(), se obtiene un descriptor y se engancha al socket con setsockopt(SO_ATTACH_BPF).
La diferencia con el filtro clásico de Berkeley está en lo que el programa puede hacer. Un filtro clásico solo compara campos del paquete y devuelve un tamaño; uno de eBPF puede llamar a funciones del kernel, consultar mapas compartidos y actualizarlos, y el verificador garantiza que no se sale de lo permitido. Para el usuario, eso significa filtros que llevan estado, cuentan paquetes por flujo o deciden con información que antes había que sacar a espacio de usuario.
El ciclo también reduce la memoria que consume el verificador (9c3997601d51), un detalle que importa cuando se cargan muchos programas pequeños. LWN explicó el cambio en Attaching eBPF programs to sockets.
El alcance, eso sí, es corto: en 3.19 los programas se adjuntan a sockets, no a tc, kprobes ni tracepoints, y las herramientas que los usan empiezan a escribirse. La infraestructura ya está; el ecosistema llegará después.
3. execveat(): ejecutar un fichero por su descriptor
execve() necesita una ruta. Eso obliga a abrir un fichero, comprobar que es el que se quiere y volver a pasar la ruta al kernel, con la ventana entre la comprobación y la ejecución que eso deja abierta. execveat() cambia el punto de partida: recibe un descriptor de directorio y una ruta relativa, o un descriptor de fichero con AT_EMPTY_PATH, y ejecuta lo que hay ahí.
El commit es 51f39a1f0cea, de David Drysdale, y completa la familia que empezó con openat(): la misma idea de que todo parte de un descriptor, aplicada a la ejecución. Para un contenedor o un gestor de servicios, permite ejecutar un binario que ya está abierto sin depender de que la ruta siga siendo la misma; para una herramienta de construcción, evita comprobar y volver a abrir.
Como toda llamada nueva, tiene su límite: la libc tarda en exponerla y las herramientas tienen que usar syscall() mientras tanto. Y no resuelve el problema de los binarios que se modifican después de abrirlos: para eso está el resto del sistema de ficheros.
4. Btrfs cierra dos huecos en RAID 5 y 6
Btrfs podía reemplazar un disco en caliente desde 3.8, pero no en sistemas con RAID 5 o 6, y tampoco podía hacer scrub en esos perfiles. Las dos limitaciones desaparecen en 3.19. El scrub llega con el commit de Miao Xie y el reemplazo en caliente con el de Zhao Lei.
Para quien administre un NAS con Btrfs en RAID 5 o 6, el cambio es práctico: btrfs scrub verifica las sumas de comprobación de todos los bloques y repara lo que pueda con la paridad, y btrfs replace cambia un disco sin desmontar ni reconstruir el volumen a mano. Antes había que añadir el disco nuevo y quitar el viejo en dos pasos, con el riesgo de quedarse sin redundancia por el camino.
El límite es el de RAID 5 y 6 en Btrfs en general: el write hole sigue ahí. Un corte de corriente en mitad de una escritura puede dejar la paridad y los datos incoherentes, y el scrub no siempre puede distinguir cuál de las dos copias es la buena. Para datos importantes, el consejo de la documentación sigue siendo RAID 1 o 10.
5. El salseo: el binder sale de staging
El binder de Android llevaba años en drivers/staging. En 3.19 se muda a drivers/android/ con el commit de Greg Kroah-Hartman, y el propio Greg lo señaló en el pull de staging para la rc1: «the ‘contentious’ thing here is the movement of the Android binder code out of staging into the ‘real’ part of the kernel», escribió en el hilo.
Su argumento se resume en tres frases: el código lleva años estable, corre en decenas de millones de dispositivos y la API no va a cambiar por motivos heredados. Admite que el código es horrible y que la interfaz de usuario deja mucho que desear, pero sostiene que no hay marcha atrás. La decisión se había hablado en el Linux Plumbers de ese año, y Torvalds la aceptó sin pelea: no hubo reversión ni cambio de maintainer. El episodio deja una conclusión: el kernel acepta código feo cuando el coste de no tenerlo es mayor, y el binder es la interfaz que usan las aplicaciones de Android y que el kernel tendrá que mantener de todos modos.
6. MPX, HSA y Coresight: hardware que llega antes que el software
Tres entradas de hardware comparten la misma historia: el soporte llega antes de que el hardware esté en el mercado. La primera es Intel MPX, las extensiones de protección de memoria que añaden registros y comprobaciones de límites para detectar desbordamientos en tiempo de ejecución. El kernel añade el soporte de contexto y de señales (95290cf13e56, de Dave Hansen), pero no hay CPUs con MPX en el mercado: llegarían con Skylake y Goldmont. LWN lo explicó en Supporting Intel MPX in Linux.
La segunda es HSA, la arquitectura heterogénea de AMD que comparte memoria entre CPU y GPU. El driver amdkfd entra en el tree y ofrece la API que usa la biblioteca HSA de AMD, pensada para las APU Kaveri. Es la primera pieza de un modelo en el que la GPU ejecuta tareas con colas accesibles desde espacio de usuario, y depende de firmware y de hardware concreto.
La tercera es Coresight, el sistema de trazado de ARM. El kernel añade el framework que registra las fuentes, los enlaces y los destinos de traza, y monta la topología a partir del device tree; los drivers están en drivers/coresight/ y la documentación en Documentation/trace/coresight.txt. Para quien depure un SoC ARM, permite ver el flujo de ejecución en vez de adivinarlo.
7. Nios II y los overlays de device tree
Dos cambios de arquitectura y plataforma. El primero es Nios II, el procesador de 32 bits para FPGA de Altera, que entra como arquitectura nueva en arch/nios2 con el merge de Torvalds. Es un destino para sistemas embebidos que antes necesitaban parches fuera del tree, y llega con su propio maintainer y sus herramientas.
El segundo son los overlays de device tree: la posibilidad de modificar en caliente una parte del árbol de dispositivos para describir hardware que se conecta después del arranque. El commit es 7518b5890d8a, de Pantelis Antoniou, y el caso de uso está en las placas de desarrollo: un BeagleBone con una cape o una Raspberry Pi con un HAT pueden cargar su descripción sin recompilar el árbol base. LWN lo contó en Device tree overlays.
Para el usuario de placas, la condición es que el firmware y las herramientas sepan aplicar el overlay; el kernel ofrece el mecanismo; la política depende de las herramientas. Para el resto, es una pieza más de un modelo que ya usan todas las placas ARM.
8. Red: switchdev, GUE e ipvlan
El cambio de red con más impacto es switchdev, la infraestructura para descargar el reenvío a chips de switch. La idea es que el kernel pueda decirle a un ASIC qué hacer con una tabla FDB o una VLAN, en lugar de reenviar todo por software; el primer driver que la usa es rocker, un switch emulado en QEMU. El notificador entra con el commit de Jiri Pirko y KernelNewbies recoge la lista completa de piezas.
En túneles, GUE gana la descarga de checksum remota: el emisor no calcula el checksum interno del paquete encapsulado, y el receptor lo deduce con la información del header. El merge es 1d76c1d02897. Y en virtualización de red, ipvlan estrena un driver que multiplexa por dirección L3 en lugar de por MAC, con la ventaja de que todas las interfaces comparten la capa 2 y el switch de fuera no ve nada raro.
Hay más: SO_INCOMING_CPU permite saber en qué CPU se recibió un paquete, el GRO gana un temporizador de vaciado por dispositivo y la tabla de rutas puede marcar ECN. Son piezas pequeñas que, juntas, explican por qué el networking del kernel aguanta el ritmo de los centros de datos.
9. Por subsistemas
9.1 Sistemas de ficheros
NFS 4.2 añade ALLOCATE y el punch de huecos (f4ac1674f5da, de Anna Schumaker), así que fallocate() funciona en red. F2FS estrena el montaje fastboot (d5053a34a9cc) y guarda las entradas de directorio dentro de la página del inodo con inline_dentry. SquashFS añade compresión LZ4 (9c06a46f1524, de Phillip Lougher)), ext4 permite desactivar el checksum del journal y Ceph admite datos en línea.
9.2 Bloque
dm-thin acelera el descarte: un volumen de 100 GB completamente aprovisionado pasa de 860 a 95 segundos (7a7e97ca580b), y dm-cache mejora el suyo. El ciclo también retira el tope artificial de max_hw_sectors (34b48db66e08), que limitaba las peticiones grandes en algunos drivers.
9.3 Virtualización
virtio_scsi admite varias colas de hardware sobre blk-mq (ccbedf117f0d), la pieza que faltaba para que el disco de una máquina virtual aproveche varias colas del host. KVM retira el soporte de ia64 (003f7de62589), una arquitectura que ya no se usa, y Hyper-V añade la retirada en caliente de la tarjeta de red virtual.
9.4 Seguridad y trazado
IMA permite cargar un certificado X.509 desde el kernel y exige la evaluación por firma, y añade ima_template_fmt para definir el formato del registro. En perf, -I captura el estado de los registros en la interrupción (6a21c0b5c2ab) y un script exporta los datos a PostgreSQL (2987e32f75dc).
9.5 Red y wireless
Bluetooth 4.2 estrena LE Secure Connections (b5f185f33d04), 802.15.4 recibe el framework netlink nl802154, y Open vSwitch añade MPLS (25cd9ba0abc0). En Wi-Fi, el ciclo añade 802.11p OCB, control de admisión WMM y escaneo con MAC aleatoria.
9.6 Criptografía
El kernel estrena una interfaz de espacio de usuario para AEAD (af8e80731a94), ARM64 suma un módulo de CRC-32 acelerado por hardware y CAAM aprende AES-GCM para IPsec.
10. Lo que no llega
- MPX sin CPUs. El soporte está en el kernel, pero no hay procesadores con MPX en el mercado: llegan con Skylake y Goldmont, y solo si el compilador y las bibliotecas lo aprovechan (Wikipedia).
- kdbus sigue fuera. El bus de mensajes que systemd quería llevar al kernel no entra en 3.19 y tampoco lo hará después; su discusión sigue en 2015 (LWN).
- RAID 5/6 en Btrfs conserva el write hole. El scrub y el reemplazo ya funcionan, pero un corte en mitad de una escritura puede dejar datos y paridad incoherentes; la documentación de Btrfs mantiene la recomendación de RAID 1 o 10 para datos importantes.
- HSA depende del hardware.
amdkfdfunciona en las APU Kaveri con el firmware adecuado; en el resto de equipos AMD no hay nada que activar.
11. Cambios menores
Una selección de lo que no cabe en las claves, con su enlace y su consecuencia.
Core
- i_mmap_mutex como rwsem — lectores concurrentes en páginas mapeadas de ficheros.
- FDT en
/sys/firmware/fdt— el device tree que arrancó, accesible desde espacio de usuario. - plataforma en
/sys/devices/platform— los dispositivos de plataforma dejan de colgar de/sys/devices.
Almacenamiento y ficheros
- ext4 sin checksum de journal —
nojournal_checksumpara quien ya tienemetadata_csum. - AFFS con O_DIRECT — E/S directa en el sistema de ficheros de Amiga.
- Ceph CREATE — crear objetos en el OSD sin pasar por el cliente.
- dirsync en f2fs — sincronizar también las operaciones de directorio.
Networking
- temporizador de GRO por dispositivo — vaciar la cola de agregación cuando convenga.
- proxy ARP en el bridge — el AP mantiene el mapa MAC-IP de los móviles.
- cgroup en nft_meta — filtrar por el cgroup del paquete.
- TIPC por netlink — configurar TIPC sin ioctls.
Virtualización
- Hyper-V sin vNIC en caliente — quitar la tarjeta virtual sin apagar.
- herramientas de Hyper-V sin demonio —
-npara ejecutar una orden y salir.
Tracing y perf
- perf annotate con líneas de fuente — ver el código fuente junto al ensamblador.
- perf con
--buildid-dir— elegir dónde se guardan las cachés de símbolos.
12. Qué viene después
La merge window de la siguiente release se abrió el 9 de febrero, y el 22 la rc1 apareció ya como Linux 4.0. «The people have spoken», escribió Torvalds en el anuncio de la rc1, y avisó de que comprobaría cuánto se rompe por el número. La release llegó el 12 de abril con live patching y DAX; el análisis está en Linux 4.0.
Para quien administre sistemas, 3.19 es una release de transición con dos cosas útiles: btrfs scrub y btrfs replace en RAID 5/6, y el binder fuera de staging para quien empaquete Android. Para quien programe, es la release en la que eBPF empieza a engancharse a los sockets y execveat() abre la puerta a ejecutar por descriptor. Y para la serie, es el final: 3.20 no existió.
La serie 3.x sigue en la página de la serie y el índice del kernel reúne las demás. La entrega anterior es Linux 3.18, y la siguiente serie empieza en Linux 4.0.