Linux 4.20: PSI, dos CPUs chinas y el adiós a la serie 4.x
Linux 4.20 estrena PSI para medir la presión de CPU, memoria y disco, suma C-SKY e Hygon y cierra la serie 4.x antes de Linux 5.0.
Linux 4.20 salió el domingo 23 de diciembre de 2018 y cierra la serie 4.x: 13.884 changesets de 1.743 desarrolladores y 223 empresas, PSI para medir la presión real del sistema, XArray en la caché de páginas, la arquitectura C-SKY y los procesadores Hygon Dhyana. Llega tras siete release candidates, deja WireGuard y FreeSync para más adelante y es el primer ciclo de Torvalds después de su retirada. Spectre, eso sí, se sigue pagando.
Linux 4.20 se publicó el domingo 23 de diciembre de 2018, nueve semanas después de 4.19 y con la merge window de Navidad ya abierta. El tag 8fe28cb5 cierra un ciclo de siete release candidates: la rc1 llegó el 4 de noviembre y la rc7 el 16 de diciembre. Torvalds no esperó una semana más, aunque el último tramo trajo más parches de los que le habrían gustado, y lo dijo en el anuncio.
Las cifras están en la media de 2018. El ChangeLog suma 14.995 entradas, de las que 1.111 son merges: 13.884 changesets sin merges. LWN contó 1.743 desarrolladores y 283 novatos antes del cierre, y 223 empresas financiando el trabajo, con Intel y Red Hat a la cabeza. Es el ciclo más cargado desde 4.15, pero por poco.
Hay tres claves. La primera es la medida: PSI cuantifica el tiempo que las tareas pasan esperando CPU, memoria o disco, que es lo que la carga media no cuenta. La segunda es la estructura: XArray sustituye el radix tree en la caché de páginas. La tercera es el hardware: entran la arquitectura C-SKY y los x86 Hygon Dhyana, dos apuestas chinas en el mismo ciclo.
Y un contrapeso: Spectre sigue mandando. STIBP, la mitigación cruzada entre hilos del mismo núcleo, se activa por defecto durante la merge window, hunde varios benchmarks y obliga a rehacer el control antes de la release. Al final, la solución es un interruptor por proceso.
Esta es la última release 4.x. En la rc1, Torvalds bromeó con el número siguiente: si todos ayudaban, se podía contar hasta 20, pero 5.0 llegaría al año siguiente, cuando se quedara sin dedos. Llegó el 3 de marzo de 2019, con Energy Aware Scheduling y FreeSync.
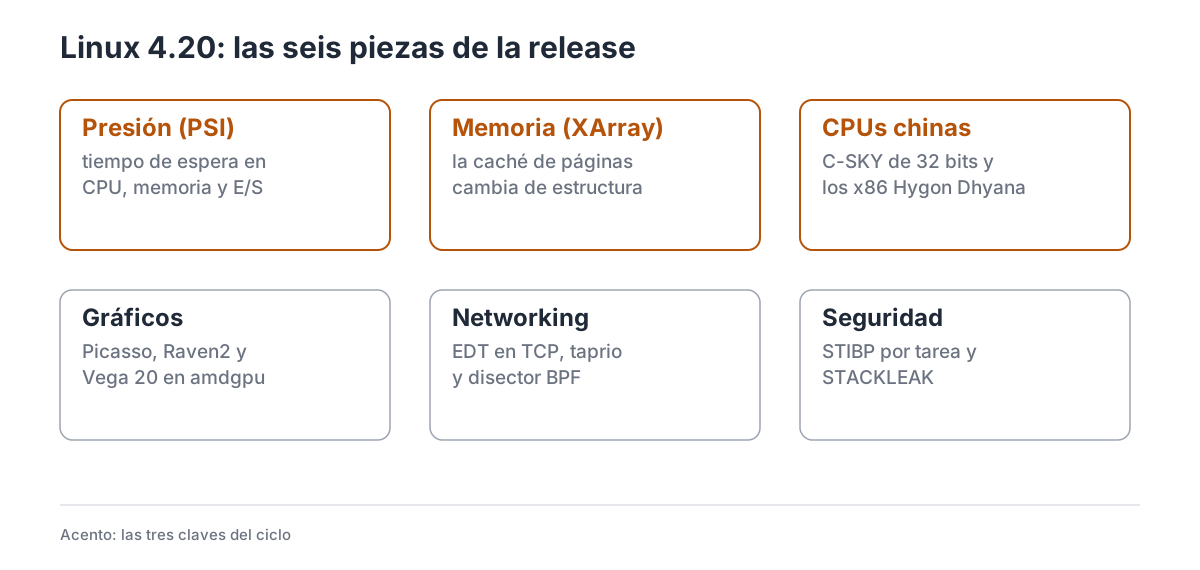
Las seis piezas del ciclo. En ámbar, las tres que cambian algo para quien administra o programa sobre Linux.
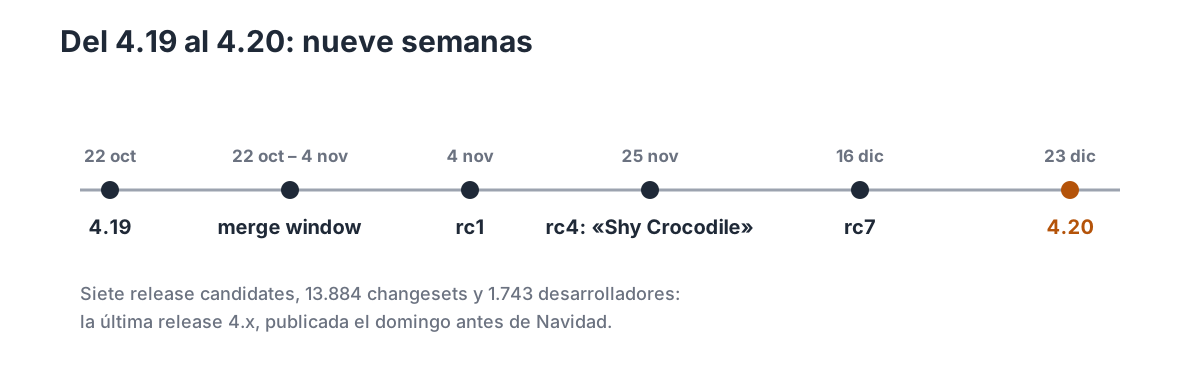
Del 4.19 al 4.20: merge window de dos semanas, siete release candidates y una Navidad de por medio.
1. Las cifras del último 4.x
| Dato | Valor |
|---|---|
| Fecha de release | 23 de diciembre de 2018 |
| Versión anterior | 4.19 (22 de octubre de 2018) |
| Merge window | 22 de octubre al 4 de noviembre de 2018 |
| Release candidates | 7 |
| Changesets sin merges | 13.884 |
| Desarrolladores | 1.743 |
| Novatos | 283 |
| Empresas | 223 |
Commits con Tested-by | 953 (7 %) |
Commits con Reviewed-by | 4.198 (30 %) |
| Líneas netas añadidas | ~350.000 |
El tag de 4.19 lo publicó Greg Kroah-Hartman el 22 de octubre, mientras Torvalds estaba apartado; 4.20 es el primer ciclo que vuelve a cerrar él. La diferencia se nota en el volumen: la merge window mete unas 350.000 líneas nuevas, según Phoronix, y el tree termina con más de 13.800 cambios efectivos.
El reparto por autor tiene nombres conocidos. Lorenzo Bianconi encabeza la lista con 198 changesets, casi todos en el driver mt76 de Wi-Fi; le siguen Christoph Hellwig (145, bloque y DMA), Laurent Pinchart (142, gráficos) y Matthew Wilcox (129, XArray). Por líneas modificadas ganan los drivers de AMD: Feifei Xu suma 62.965 líneas en cabeceras de amdgpu, y Spencer Olson otras 34.216 en los drivers comedi de staging.
Por empresas, Intel aporta el 9,6 % de los cambios y Red Hat el 8,4 %. Linaro y AMD empatan al 4,7 %, IBM queda en el 4,5 % y Huawei y Google superan el 3 %. La revisión también se mide: el 30 % de los commits lleva Reviewed-by, y el 7 % Tested-by, con Andrew Bowers (Intel) y Rob Herring a la cabeza en cada columna.
Las estadísticas completas están en LWN, que las publicó el 21 de diciembre, dos días antes de la release.
2. PSI: saber si el servidor va ahogado
Un servidor puede tener la CPU al 100 % y responder bien, o ir al 40 % y arrastrarse porque todo el mundo espera al disco. La carga media no distingue esos dos casos: cuenta procesos en cola, no el tiempo que pierden esperando. PSI, por pressure stall information, mide justo eso: el porcentaje de tiempo de pared en el que al menos una tarea está parada por falta de CPU, memoria o E/S.
El mecanismo lo añade Johannes Weiner en un commit que crea el directorio /proc/pressure/. Dentro hay tres ficheros —cpu, memory e io—. some cuenta el tiempo en el que alguna tarea está bloqueada; full, el tiempo en el que todas las tareas que no están inactivas lo están, y solo se publica para memoria y E/S: en CPU no existe. Las cifras se calculan en ventanas de 10, 60 y 300 segundos, más un total acumulado en microsegundos.
Esta es la lectura de cpu.pressure que publicó LWN al presentar el parche:
1
some avg10=2.04 avg60=0.75 avg300=0.40 total=157656722
Un avg10 de 2,04 significa que, en los últimos diez segundos, los procesos han perdido un 2,04 % del tiempo esperando CPU. Si el número sube y se queda alto, el sistema está sobrecargado aunque la carga media parezca razonable; si el total acumulado pega saltos, hay picos de latencia que los promedios esconden.
El mismo ciclo añade soporte por cgroup: en cgroup v2, cada grupo tiene cpu.pressure, memory.pressure e io.pressure, de modo que se puede saber qué contenedor sufre y cuál no. Para un servidor con varios servicios, esa es la forma de separar el problema por grupo.
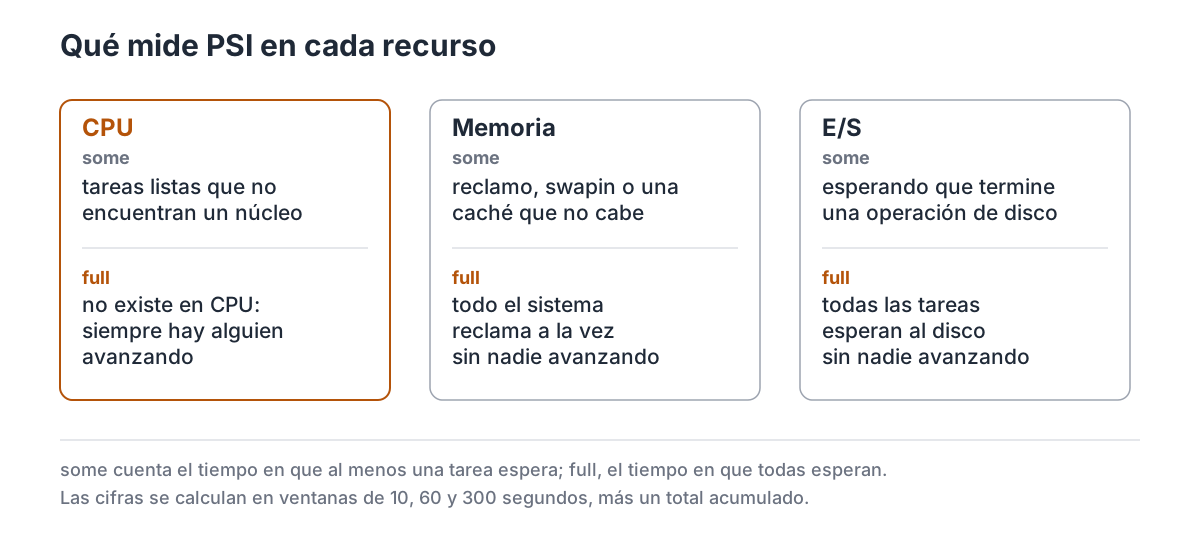
PSI separa «hay una tarea esperando» de «todo el mundo espera». La segunda cifra es la que delata un bloqueo.
Los límites son claros. PSI mide presión, no causas: dice que el disco va lento, no qué proceso lo satura. En 4.20 no hay disparadores ni umbrales configurables, así que hace falta un monitor que lea los ficheros y actúe; los triggers llegarían más adelante. Y el núcleo tiene que compilarse con CONFIG_PSI (se puede desactivar con psi=0). La documentación está en docs.kernel.org.
3. XArray: el radix tree empieza a jubilarse
La caché de páginas del kernel guarda millones de páginas indexadas por su posición en el fichero. Durante años lo hizo con un radix tree, una estructura correcta pero con una API incómoda: cada usuario gestiona sus propios candados, reserva memoria antes de bloquear y recorre el árbol más de lo que le gustaría. Matthew Wilcox propuso cambiar el punto de vista: mejor pensarlo como un array disperso de punteros indexado por un unsigned long.
Ese array es el XArray. La API mete el candado dentro, recibe los flags de memoria en la asignación, elimina el preload y esconde los punteros protegidos por RCU. Para el usuario no cambia nada; para el código que sostiene la caché, sí: menos recorridos, menos estados intermedios y menos formas de equivocarse con los candados. LWN lo explicó en The XArray data structure.
En 4.20 entra el merge completo: la implementación, la conversión de la caché de páginas y la de memremap, y la retirada del soporte multiorder del radix tree. Son 90 commits de Wilcox, que también aparece entre los autores con más líneas modificadas del ciclo.
La conversión es deliberadamente parcial. El propio autor explica en el merge que tiene más de 40 parches para convertir otros usuarios del radix tree, pero que no están en linux-next y prefiere entregar primero lo importante: la caché de páginas. Quedan subsistemas con la API vieja, y la estructura antigua sigue en el tree. La referencia para quien programe con ella está en docs.kernel.org.
4. Dos arquitecturas chinas: C-SKY e Hygon Dhyana
El mismo ciclo estrena dos familias de procesadores del mismo país por caminos distintos. La primera es C-SKY, una arquitectura de 32 bits para sistemas embebidos de C-SKY Microsystems, con sede en Hangzhou. El merge de la arquitectura llega tras diez rondas de revisión en la lista de correo y añade el port completo, desde el arranque y la MMU hasta las llamadas al sistema. Guo Ren, su autor, suma 11.713 líneas, el cuarto mayor volumen del ciclo.
La segunda es Hygon Dhyana, un x86 de la joint venture entre AMD y el consorcio chino Hygon. Los procesadores son la familia 18h, derivada de Zen y vendida en el mercado chino. El soporte no es un único parche: Pu Wen y el resto del equipo reparten cambios por la detección de CPU, ACPI, cpufreq, EDAC, KVM, Xen, MCE y las mitigaciones de Spectre. El punto de partida es el fichero de soporte de la arquitectura, integrado en la rama tip correspondiente.
Para quien ya use Linux no cambia nada: ni una línea de código existente deja de funcionar. Para quien siga el hardware, el mensaje es que el kernel acepta dos ecosistemas chinos a la vez, uno embebido y otro de servidor, y que las dos entradas vienen con maintainers propios. Hay contexto en Wikipedia y en la ficha de Hygon.
5. Gráficos: Picasso, Raven2 y Vega 20
AMD coloca tres piezas en el mapa de amdgpu. Picasso es la APU que llegaría en 2019: el soporte de bloques IP y el resto de la serie la dejan lista para arrancar antes de que exista en las tiendas. Raven2 es una variante económica de Raven Ridge, con definiciones propias en el bloque de display. Y Vega 20, la GPU de 7 nm que llegaría como Radeon VII, deja de ser experimental: el ciclo añade identificadores PCI y soporte completo de powerplay.
La pieza más curiosa es udmabuf, un dispositivo misceláneo de Gerd Hoffmann que convierte una región memfd en un dma-buf. ¿Para qué? Para que QEMU pueda exportar el framebuffer de una máquina virtual o los recursos de virtio-gpu como buffers DMA y pasarlos al host sin copias. El cliente SPICE lo usa para pintar el framebuffer clásico; el objetivo es que algún día un servidor Wayland muestre las ventanas del invitado sin costuras. La documentación de dma-buf describe el marco.
Como siempre en gráficos, el soporte llega antes que el hardware o el firmware. Vega 20 funciona, pero FreeSync y la tasa de refresco variable se quedan fuera y llegan en 5.0. Quien compre la GPU el año siguiente necesitará una actualización de kernel para aprovechar la pantalla.
6. Networking: TCP deja de enviar cuanto antes
Internet creció con la idea de enviar lo antes posible. El problema es que el hardware moderno tiene colas y el «lo antes posible» ya no es óptimo: si todos los paquetes salen a la vez, se forman ráfagas que inflan la latencia. Eric Dumazet cambia el modelo con el paso a earliest departure time: TCP calcula por sí mismo cuándo debe salir cada paquete y sch_fq deja de estimarlo. El cambio da muestras de RTT más precisas y menos latencia en el percentil 99.
El mismo ciclo añade taprio, un scheduler de tráfico con horario, base de IEEE 802.1Qbv: se definen ventanas de tiempo y qué colas pueden transmitir en cada una. Es la pieza que necesitan las redes industriales y de automoción para garantizar plazos, y se configura con tc como cualquier otro qdisc.
En el terreno programable, un programa BPF puede diseccionar paquetes en lugar del disector fijo del kernel. El gancho es por espacio de nombres de red, así que un contenedor puede traer su propio disector sin tocar el del host. Y en el detalle que afecta a todo el mundo, la ventana inicial de recepción sube: el buffer pasa de unos 87 KB a 128 KB y el SYN anuncia unos 64 KB en vez de 29 KB, lo que acelera el arranque de conexiones con RTT alto.
Hay límites: EDT necesita fq o hardware que sepa de tiempos; taprio necesita una NIC que respete el horario; y el disector BPF pide privilegios y un programa que alguien escriba. La charla de netdevconf, Evolving from AFAP, explica el cambio de modelo.
7. Seguridad: STIBP por tarea y el precio de Spectre
Spectre v2 aprovecha el predictor de saltos. Con SMT activo, dos hilos comparten ese predictor, y un hilo puede entrenarlo para atacar al otro. La mitigación de Intel se llama STIBP y, durante la merge window, el kernel la activa por defecto en equipos Intel vulnerables con los dos hilos en línea. La decisión se retroporta a las ramas estables y ahí empieza el problema: STIBP frena el sistema en muchas cargas, y los benchmarks de Phoronix lo documentan con caídas de dos dígitos en memoria y compilación.
Torvalds lo describió con su nuevo tono: «en realidad es un modo de ir muy lento», y dijo que STIBP debía ser opcional, para «gente muy valiente» dispuesta a pagar el precio. Las estables revierten el parche y el mainline rehace el control. Antes de la release entran el soporte por tarea, la llamada prctl() y los modos prctl y seccomp: por defecto, STIBP queda apagado salvo en procesos que lo pidan o que corran bajo seccomp; spectre_v2_user=on lo enciende para todos. LWN cuenta la negociación en Taming STIBP y Phoronix mide el coste en su comparativa.
El otro cambio de seguridad es STACKLEAK, un plugin de GCC portado desde grsecurity por Alexander Popov que borra la pila del kernel al salir de una llamada al sistema. Entra por el merge de Kees Cook con el plugin y protege frente a usos de pila sin inicializar, una clase de fallo que los compiladores aún no cierran del todo.
El límite es incómodo: la protección existe, pero es opt-in en la práctica. Un servidor con SMT y procesos que no piden STIBP sigue expuesto a ataques entre hilos. Ahora el administrador decide ese equilibrio entre seguridad y rendimiento; antes lo recibía impuesto.
8. El salseo: el primer ciclo de Torvalds tras la disculpa
No hubo pelea de maintainers en 4.20. Hubo, eso sí, un cambio de tono. Torvalds se apartó del kernel en septiembre de 2018 después de pedir perdón por su comportamiento, y 4.19 lo cerró Greg Kroah-Hartman. Cuando volvió, la merge window de 4.20 fue su primer ciclo completo: The Register habló del «woke Linus» y ZDNet de un Torvalds «más amable», y el anuncio de la rc1, con su broma sobre contar hasta 20, encaja con esa versión.
La prueba de fuego llegó con STIBP. El Torvalds de 2017 habría cerrado el hilo a gritos; el de 2018 explicó el problema técnico, llamó «ve muy lento» a la mitigación y aceptó que el control pasara a ser por proceso. La cita completa está en el anuncio de la rc1 y en el análisis de LWN, y el resto del ciclo transcurrió sin dramas de lista de correo.
Para quien lea la serie de releases, ahí está el cambio de época: el código de conducta y un Torvalds que discute de otra manera. La técnica sigue siendo dura —Spectre, mitigaciones y rendimiento—, y el tono ya no es el de las broncas que lo hicieron famoso.
9. Por subsistemas
9.1 Sistemas de ficheros
XFS ya puede devolver resultados parciales de reflink: si un copy_file_range() de 1 GB se queda sin espacio a mitad, el usuario sabe cuántos bytes se copiaron en vez de recibir solo un error. Btrfs mejora los candados del btree, con más ficheros por segundo y menos cambios de contexto, y reduce los extents sucios de los qgroups. CIFS estrena compounding, que agrupa operaciones para ahorrar viajes de ida y vuelta, y E/S directa para no pasar por la caché. F2FS añade suma de comprobación del superbloque y FUSE puede cachear readdir.
9.2 Memoria y bloque
El lazy TLB se vuelve más lazy: en lugar de despertar una CPU inactiva para invalidar, se recarga %CR3 en el siguiente cambio de contexto. Rik van Riel mide un 1 % menos de CPU en una carga tipo memcache, y el cambio llega junto a la variante que evita el IPI. En bloque, varios drivers abandonan la interfaz antigua y pasan a blk-mq; Kyber estrena heurísticas basadas en p99; aparecen los ioctls BLKGETNRZONES y BLKGETZONESZ para discos por zonas; y se retira el driver DAC960, que Hannes Reinecke reescribe como myrb.
9.3 Networking y BPF
BPF gana mapas de cola y pila, útiles para colas de mensajes dentro de un programa, y un helper para buscar sockets desde un programa. El almacenamiento local por cgroup admite variantes por CPU, que evitan contiendas entre núcleos. En la parte clásica, el bridge expone estadísticas VLAN por puerto, y NFSD aprende a hacer copias asíncronas.
9.4 Virtualización
virtio-balloon informa de páginas libres al host, de modo que el hipervisor puede reutilizarlas sin esperar a que el invitado las toque. El soporte de vfio para EDID de vGPU permite describir una pantalla virtual al invitado, y VMBus admite sobrescribir el driver por defecto de un dispositivo, igual que PCI.
9.5 Criptografía y claves
El kernel estrena estadísticas genéricas de criptografía y cryptostat, y las claves asimétricas pueden quedar envueltas por el TPM y usarse para firmar o descifrar sin sacar la clave privada. El modo OFB se suma a los modos disponibles. La retirada de Speck, en cambio, va en la dirección contraria: el algoritmo sale del tree por decisión de sus propios autores.
9.6 Arquitecturas y drivers
ARM64 usa el bit PSTATE.SSBS para mitigar Spectre v4 sin llamar al firmware EL3. ARM suma placas —la Raspberry Pi CM3, la HiKey 370, la Banana Pi R64, la RockPro64— y el scheduler detecta tareas «misfit» que necesitan un núcleo grande y están atascadas en uno pequeño. En x86 entra el driver igc para la Ethernet de 2,5 Gb de Intel, y en entrada, el Magic Trackpad 2 y el HDMI 2.0 de Nouveau.
10. Lo que no llega
WireGuard no entra. El túnel VPN de Jason Donenfeld sigue en la lista de espera y no entrará en el tree hasta 5.6, en 2020; quien lo quiera en 4.20 tiene que compilarlo como módulo externo. FreeSync y la tasa de refresco variable tampoco llegan: son la pieza que más se echa en falta en amdgpu, la tecnología de AMD contra el tearing, y llegan en Linux 5.0. io_uring, la interfaz de E/S asíncrona que cambiaría el bloque al año siguiente, aún no existe; llega en 5.1, según su ChangeLog.
La conversión a XArray es parcial: la caché de páginas y memremap están dentro, pero quedan decenas de usuarios del radix tree para ciclos posteriores. STIBP protege solo si se pide, así que un servidor con SMT y procesos que no lo activan sigue expuesto. Y Vega 20 funciona, pero sin FreeSync y con firmware que aún no está en la calle.
La release no es LTS. La LTS de la serie 4.x es 4.19: quien busque estabilidad en 2019 se queda ahí, y 4.20 es una release de transición hacia 5.0. El ChangeLog de 4.19 y el de 4.20 dejan claro el reparto: menos cambios en el segundo, más experimentos.
11. Cambios menores
Una selección de lo que no cabe en las claves, con su enlace y su consecuencia.
Core
root=PARTLABEL=— arrancar por la etiqueta GPT de la partición, cómodo en esquemas A/B de actualización.- fanotify con marcas de superbloque — vigilar todos los objetos de un sistema de ficheros, no solo los de un montaje.
- ioctl de binder para contar referencias — el
servicemanagerde Android sabe cuándo es el único que sostiene un nodo. - Contador
KReclaimableen/proc/meminfo— separa la memoria del kernel que se puede recuperar.
Almacenamiento
BLKGETZONESZ— tamaño de zona de un dispositivo ZNS, junto aBLKGETNRZONES.- md raid10 puede crecer con un disco nuevo — añadir un miembro a un RAID10 montado y en uso.
- Ceph admite
copy_file_range()— copiar objetos en el cliente sin leerlos y reescribirlos. - OverlayFS activa
redirect_dirconmetacopy— los renombrados de directorios siguen funcionando entre capas.
Networking
- IPv6 puede saltarse el aviso al bajar una interfaz — menos ruido en routers con muchos enlaces.
- Geneve hereda el TTL — el túnel copia el TTL del paquete exterior sin configurarlo a mano.
Seguridad y cripto
- apparmor con filtrado por secmark — políticas de red además de rutas.
- TPM sin bloqueo — operaciones asíncronas para no dormir al proceso que espera.
- Speck fuera — un algoritmo con origen en la NSA que nunca se usó.
Gráficos y entrada
- VKMS con cursor — el driver virtual de KMS ya puede probar composición con puntero.
- Nouveau con HDMI 2.0 — más modos en el driver libre de NVIDIA.
12. Qué viene después
La merge window de 5.0 se abrió el 24 de diciembre, al día siguiente de la release, y el cambio de número no alteró el proceso: dos semanas de merges y una serie de release candidates. La release salió el 3 de marzo de 2019 con Energy Aware Scheduling, el cifrado Adiantum y FreeSync, como recoge su ChangeLog; las estadísticas del ciclo y la página de la serie 5.x completan el cuadro.
Para quien administre sistemas, 4.20 es una release para probar, no para instalar en producción: no fue LTS, y la LTS de la serie fue 4.19. El mapa de ramas de kernel.org recoge las que siguen vivas. PSI merece un monitor propio, XArray no se nota, y el control de STIBP conviene revisarlo si hay cargas con SMT. La página de la serie 4.x reúne todas las entregas, el índice del kernel tiene las demás series y la entrega anterior de esta serie es Linux 4.19.
La serie 4.x termina con una release de transición y dos ideas que siguen en el kernel actual: medir la presión en vez de la carga, y aceptar que la seguridad se paga por proceso.