Linux 5.1: io_uring, pidfd_send_signal y TEO
io_uring debuta, pidfd_send_signal cierra la carrera de los PID y TEO releva a menu en cpuidle. 13.034 changesets y 1.727 desarrolladores.
Dos interfaces estrenan Linux 5.1: io_uring para la E/S asíncrona y pidfd_send_signal() para enviar señales sin race conditions. El ciclo suma 13.034 changesets y 1.727 desarrolladores.
La release sale el domingo 5 de mayo de 2019, nueve semanas después de 5.0 y dentro de la serie 5.x, y el árbol necesitó siete release candidates.
Las cifras de este post son las de la tabla acumulada de LWN, publicada en sus estadísticas de 5.11: 13.034 changesets y 1.727 desarrolladores. Es un ciclo medio, con dos interfaces nuevas que definirían los años siguientes.
Hay tres claves. La primera es la E/S: io_uring propone un modelo distinto para la asincronía. La segunda es los procesos: pidfd_send_signal resuelve un problema de diseño de Unix. La tercera es la energía: TEO elige mejor cuándo entrar en reposo.
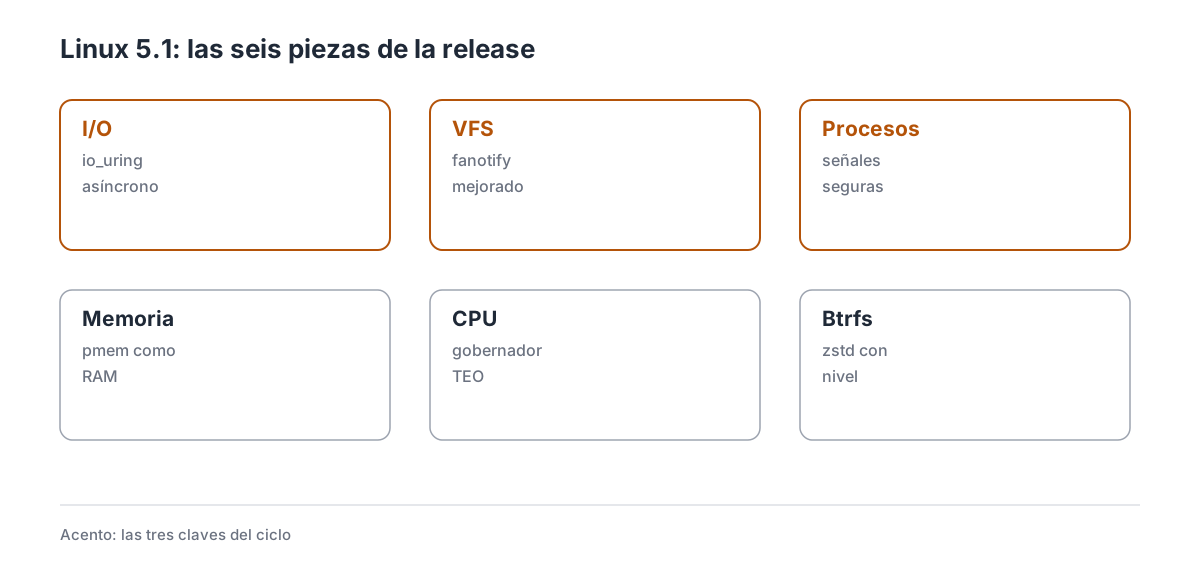
Las seis piezas que explican el ciclo, con las tres claves marcadas en ámbar.
1. Las cifras de un ciclo medio
| Dato | Valor |
|---|---|
| Fecha de release | 5 de mayo de 2019 |
| Versión anterior | 5.0 (3 de marzo de 2019) |
| Merge window | 4 al 17 de marzo de 2019 |
| Release candidates | 7 |
| Changesets | 13.034 |
| Desarrolladores | 1.727 |
El ciclo sube 226 changesets respecto a 5.0 y baja en desarrolladores. Es una release de transición, con menos titulares de hardware y más trabajo de infraestructura.
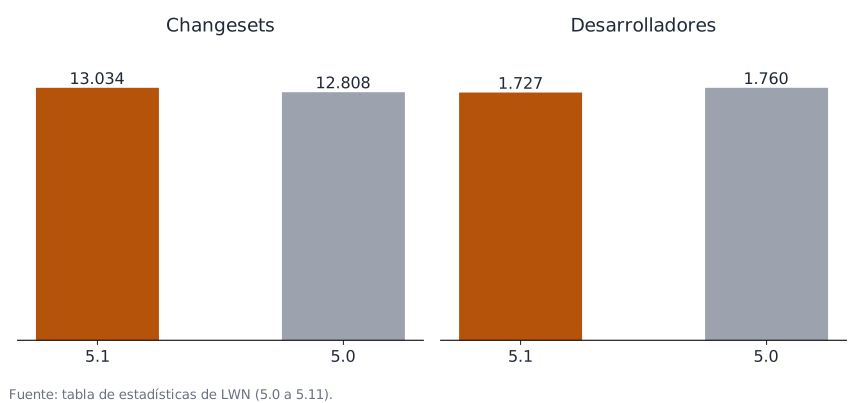
Las dos releases comparadas con la tabla de LWN, que no cuenta los merges.
El reparto por empresas sigue la tónica: Intel, Red Hat, Google y Linaro, con AMD en gráficos. El ciclo no tiene una feature de hardware dominante.
2. io_uring: la E/S asíncrona cambia de modelo
Durante años, la E/S asíncrona en Linux pasó por aio, que funciona para algunos casos y mal para otros. io_uring propone un anillo compartido entre kernel y usuario: la aplicación deposita peticiones, el kernel las procesa y publica resultados, sin una syscall por operación.
io_uring entra en 5.1 con lectura, escritura, fsync y poco más. La interfaz usa mmap para compartir las colas y io_uring_enter() para avisar al kernel.
El anillo tiene dos colas: una de envío, donde la aplicación deja peticiones, y otra de finalización, donde el kernel publica resultados. io_uring_enter() despierta al kernel solo cuando hace falta. El diseño permite además encadenar operaciones: una lectura puede disparar una escritura sin volver al espacio de usuario, que es la idea que hizo famosa a la interfaz años después. La ventaja es el coste por operación: en cargas con miles de operaciones pequeñas, el anillo elimina la transición de modo por cada una. Los límites: en 5.1 cubre pocas operaciones y no tiene openat ni red; eso llega en releases posteriores. La documentación de io_uring describe la API.
3. pidfd_send_signal: señales sin carrera
kill(2) identifica el proceso por su PID, y un PID se puede reutilizar. Si el proceso original muere y otro recibe su número, la señal acaba en el proceso equivocado: un problema clásico de Unix con consecuencias de seguridad.
pidfd_send_signal(2) usa un pidfd como identificador estable: el descriptor apunta al proceso original y no cambia aunque el PID se reutilice. Un gestor de servicios puede guardar el pidfd y enviar la señal sin comprobar el PID.
El descriptor se obtiene de /proc/<pid> o de clone(), y el kernel lo valida contra el proceso vivo antes de enviar nada. Es la primera pieza de una familia: después llegan pidfd_open, pidfd_getfd y poll sobre pidfd. Los límites: hay que obtener el descriptor antes de que el proceso muera, y su creación requiere permisos. La documentación de procesos describe la API.
4. TEO: dormir mejor
El gobernador de cpuidle decide a qué estado de reposo entra la CPU. El gobernador menu funcionaba bien en servidores, pero en sistemas con temporizadores frecuentes se equivocaba y despertaba demasiado.
TEO (Timer Events Oriented) predice el próximo evento y elige el estado que minimiza el coste total: si el próximo temporizador llega pronto, no merece la pena dormir profundo.
TEO estima el tiempo hasta el próximo evento y compara el coste de dormir con el de quedarse despierto; si el ahorro no compensa, elige un estado superficial. El gobernador se elige con cpuidle.governor=teo y convive con menu; la comparación depende del número de núcleos y de los temporizadores activos. El beneficio es el consumo en reposo: un portátil con TEO entra en reposo más a menudo y sale menos de él. Los límites: la predicción depende de los temporizadores y no siempre acierta; el gobernador es configurable y no se activa en todos los sistemas. La documentación de cpuidle describe el modelo.
5. fanotify, pmem y y2038
fanotify añade más tipos de evento: además de abrir y cerrar, puede avisar de accesos y modificaciones, con lo que un antivirus o un indexador ve más. Persistent memory se puede “conectar en caliente” como RAM: un módulo NVDIMM aparece como memoria normal y el kernel lo usa para páginas.
En tiempo, el ciclo añade las llamadas de 64 bits para time_t en las arquitecturas de 32 bits, la preparación para el año 2038.
fanotify gana un modo de permisos que permite bloquear una operación hasta que el demonio responda, pensado para antivirus. Las tres son de plataforma: más eventos, más memoria y menos fechas rotas. Los límites: fanotify necesita permisos; pmem requiere hardware; y2038 necesita que las aplicaciones usen las llamadas nuevas. La documentación de fanotify recoge el modelo.
6. Btrfs con zstd y dm sin initramfs
Btrfs permite elegir el nivel de compresión de zstd: un nivel bajo para escritorio y uno alto para archivo, con lo que el usuario decide el equilibrio entre CPU y espacio.
Device mapper añade un parámetro create que permite crear un dispositivo al arrancar sin initramfs, útil para sistemas sencillos y para arrancar desde un volumen lógico.
Las dos simplifican la configuración: una ajusta la compresión, la otra evita un paso del arranque. Los límites: zstd alto consume CPU; dm sin initramfs exige que el dispositivo esté disponible en el arranque. La documentación de Btrfs describe la compresión.
7. livepatch acumulativo
Livepatch permite aplicar parches al kernel en caliente. Hasta 5.1, cada parche era independiente y había que gestionar el orden. El reemplazo atómico permite crear un parche acumulativo que sustituye a los anteriores y se puede revertir de una vez.
El caso de uso son los servidores con largos periodos de actividad: un parche acumulativo simplifica el mantenimiento y reduce el riesgo de dejar el sistema en un estado intermedio. Los límites: livepatch no sirve para cambios estructurales y depende de la herramienta de gestión. La documentación de livepatch describe el modelo.
8. LSM apilables y SafeSetID
Durante años, el kernel permitía cargar un solo módulo LSM: SELinux o AppArmor, pero no los dos. El apilado de LSM cambia el modelo y permite componer varios módulos, con lo que una distribución puede sumar un LSM pequeño sin renunciar al principal.
El primer beneficiario es SafeSetID, un módulo que limita qué usuarios pueden cambiar de identidad: un proceso con CAP_SETUID solo puede pasar a los UID que su política permite, en vez de a cualquiera. Es una defensa contra la escalada por un binario con setuid mal configurado.
El ciclo también añade fcaps v3 en audit, que registra las capacidades de fichero con su versión nueva y evita ambigüedades al reconstruir eventos.
El patrón es el de la defensa en capas: cada LSM cubre un hueco y el apilado permite combinarlos. Los límites: el apilado no es completo en 5.1 y algunos módulos siguen sin cooperar; SafeSetID es una política sencilla, no un sistema de control de acceso. La documentación de LSM describe el modelo.
9. Memoria: swapoff lineal y compactación
swapoff tenía un problema de complejidad: al desactivar un área de swap, el kernel recorría las páginas una y otra vez, con un coste cuadrático que en un servidor con mucha swap podía tardar horas. 5.1 lo reduce a lineal con una pasada por las páginas.
La compactación mejora su tasa de éxito y su latencia, con lo que las páginas grandes se consiguen más a menudo. También se retira una heurística del OOM killer que prefería matar a los hijos del proceso con más memoria, y se impide mapear en usuario páginas especiales de SLAB, una fuga de información.
Las cuatro piezas son de higiene: menos tiempo bloqueado, menos fragmentación y menos superficie. Los límites: swapoff sigue necesitando memoria para absorber las páginas; la compactación no es gratis en CPU. La documentación de memoria recoge las políticas.
10. BPF: Host Bandwidth Manager y jmp32
BPF gana un caso de uso de red: el Host Bandwidth Manager limita el ancho de banda de un host con programas BPF en el punto de salida, sin tc ni colas externas. Sirve para máquinas virtuales y contenedores que comparten un enlace.
En el conjunto de instrucciones llegan los saltos de 32 bits (jmp32), que evitan instrucciones extra en comparaciones de 32 bits, y el acceso a struct bpf_tcp_sock, que expone el estado de la congestión a un programa de socket.
También se puede encapsular IP desde un programa LWT, con lo que un tc programable puede construir túneles sin un driver.
El Host Bandwidth Manager se engancha en el punto de salida del host y aplica un token bucket por proceso o por cgroup; el programa puede consultar el estado y devolver un veredicto en cada paquete. El beneficio es mover políticas al kernel: límites y túneles que antes necesitaban un demonio. Los límites: los programas necesitan privilegios y el verificador impone restricciones; jmp32 requiere adaptar el compilador. La documentación de BPF describe el conjunto.
11. Gráficos y almacenamiento
En gráficos, el ciclo añade el driver Komeda para las pantallas de ARM, paneles nuevos como el Kingdisplay KD097D04 y el Sitronix ST7701, y el driver del TPO TPG110. Son piezas para placas y paneles concretos, no para el escritorio general.
En almacenamiento, NVMe multipath estrena una política round-robin para repartir la E/S entre controladores, y el comando Write Zeroes permite borrar bloques sin escribir ceros de verdad. Las tarjetas MMC ganan ADMA3, que reduce la carga de la CPU en transferencias grandes.
Las dos áreas son de plataforma: hardware nuevo que arranca y almacenamiento que se gestiona mejor. Los límites: los drivers de pantalla necesitan el árbol de dispositivos correcto; Write Zeroes depende del firmware. La documentación de DRM describe el modelo.
12. Arquitecturas: ARM, x86 y RISC-V
ARM suma cuatro familias: Milbeaut SC2000, Bitmain BM1880, Renesas RZ/A2M y RZ/G2E. Son SoC de cámara, de borde y de industria, el tipo de hardware que sostiene el ecosistema.
En x86, la especulación gana PR_SPEC_DISABLE_NOEXEC, que permite desactivar la especulación en un proceso sin afectar a los hijos; intel_idle reconoce Jacobsville y RAPL añade Ice Lake mobile.
RISC-V estrena un JIT de BPF para RV64G, la pieza que permite ejecutar programas BPF a velocidad nativa en esa arquitectura.
El patrón es el de siempre: más plataformas y más rendimiento por vía de mitigaciones y JIT. Los límites: cada SoC necesita su árbol de dispositivos y su firmware. La documentación de RISC-V recoge el estado.
13. Red: sockets seguros en 2038 y bridge
La pila de red cierra dos frentes. Los timestamps de socket seguros para 2038 usan time64 en las estructuras que cruzan al usuario, con lo que una captura de paquetes no se rompe en 2038. El bridge implementa Multicast Router Discovery, el protocolo que descubre routers multicast en una red local, y bonding exporta estadísticas 3ad por xstats.
Los tres son de interoperabilidad: fechas que no se rompen, routers que se descubren y contadores que se leen. Los límites: time64 necesita que la aplicación use las estructuras nuevas; MRD es para redes con multicast. La documentación de red describe el modelo.
14. Ficheros: Btrfs, automontaje y dm-cache
Btrfs afina su gestión interna. Los qgroups retrasan el escaneo del subárbol para no pagar el coste en cada operación, y llega un ioctl para dar de baja un dispositivo sin desmontar el sistema de ficheros.
El sistema de automontaje añade una opción ignore que indica a la aplicación que el montaje no está disponible, en vez de fallar con un error genérico; es útil para directorios de red que aparecen y desaparecen, y para el automontaje en general.
En el bloque, dm-cache propaga el discard al dispositivo de origen, con lo que un SSD detrás de la caché sigue recibiendo los TRIM, y bcache exporta por sysfs el nombre y el UUID del dispositivo de respaldo, datos que faltaban para automatizar la configuración.
Las tres áreas comparten la idea de hacer visible el estado: cuotas que no bloquean, montajes que informan y cachés que no ocultan el disco. Los límites: los qgroups siguen siendo caros en sistemas grandes; dm-cache con discard necesita un dispositivo que lo admita. La documentación de ficheros recoge las opciones.
15. Sonido, watchdog y energía
El driver de FireWire estrena soporte para la Solid State Logic Duende, una interfaz de estudio, y para la RME Fireface UCX, dos equipos que hasta ahora necesitaban parches externos.
El watchdog añade un parámetro watchdog_thresh para ajustar el tiempo del detector de bloqueo duro, y el driver del STPMIC1 cubre el watchdog de ese PMIC.
En energía, cpufreq gana el driver de la Armada 8K y ACPI/APEI admite las notificaciones SDEI de GHES, con lo que un error de hardware se puede notificar por firmware.
Las piezas son de plataforma: audio profesional, watchdog y errores de firmware. Los límites: las interfaces de audio necesitan firmware; SDEI depende del firmware ACPI. La documentación de sonido describe el modelo.
16. PowerPC, s390 y MIPS
PowerPC amplía la emulación de instrucciones single-step y activa THREAD_INFO_IN_TASK, que reduce el acceso a la pila del kernel. s390 añade las estadísticas de anillo de qeth para las tarjetas OSA y trazas de contadores de CPU.
MIPS habilita páginas grandes en MIPS64r6 y el árbol de dispositivos adjunto en Ingenic. En USB, usbfs permite autorizar solo dispositivos internos, la política que usa ChromeOS.
El trabajo de arquitecturas no es cosmético: THREAD_INFO_IN_TASK reduce el coste de acceder a la información del proceso, y las páginas grandes de MIPS mejoran el rendimiento de la memoria en servidores embebidos. En conjunto, cada arquitectura se acerca al soporte de x86. Las piezas son de paridad: cada arquitectura cubre lo que ya hacía x86. Los límites: las mejoras de PowerPC son para servidores IBM; MIPS sigue perdiendo protagonismo. La documentación de PowerPC recoge el estado.
17. Por subsistemas
17.1 Core y herramientas
La documentación del proceso recoge el modelo.
io_uring, pidfd_send_signal y fanotify son las novedades. El scheduler y la memoria reciben ajustes.
17.2 Sistemas de ficheros
Btrfs estrena el nivel de zstd; ext4 y XFS reciben correcciones.
17.3 Memoria
pmem como RAM es la pieza visible, junto con mejoras de reclamación.
17.4 Bloque
dm gana el parámetro create; NVMe y SCSI suman hardware.
17.5 Redes
La pila recibe mejoras y los drivers siguen entrando.
17.6 Virtualización
KVM y virtio reciben correcciones y mejoras.
17.7 Arquitecturas
ARM suma placas; x86 añade modelos y correcciones; RISC-V sigue creciendo.
18. Lo que no llega
io_uring cubre pocas operaciones en 5.1: openat, red y epoll llegan después. pidfd_send_signal necesita el descriptor antes de que el proceso muera.
TEO no siempre acierta y es configurable. pmem necesita hardware. Y 5.1 no es LTS: la LTS es 4.19 hasta noviembre, según el calendario de kernel.org.
19. Cambios menores
Más detalle en la documentación de la API del core.
Más detalle en la documentación de livepatch.
Más detalle en la documentación de livepatch.
Core
- io_uring — E/S asíncrona.
- fanotify — eventos.
- livepatch — acumulativo.
Memoria
- pmem — como RAM.
Ficheros
- Btrfs — zstd.
20. Qué viene después
El siguiente ciclo está en el inventario de KernelNewbies.
La merge window de 5.2 se abre el 6 de mayo y cierra el 19 de mayo. Ese ciclo traerá Sound Open Firmware, la nueva API de montaje y mitigations=; Linux 5.2 sale el 7 de julio.
Para las distribuciones, 5.1 es la base de Ubuntu 19.10 y Fedora 31. Las rolling la adoptan en semanas. La LTS sigue siendo 4.19.
Las próximas releases mostrarán si io_uring se convierte en el modelo de E/S, si pidfd sustituye a kill y si TEO se impone en los portátiles.
io_uring y pidfd son las dos piezas que más han envejecido bien: la primera cambió la forma de escribir servidores de E/S y la segunda sustituyó a kill en los gestores de servicios. El resto del ciclo es mantenimiento de calidad: memoria, bloque y arquitecturas que se acercan a x86. Para un usuario de escritorio, lo visible es TEO y el soporte de memoria persistente; para un administrador, fanotify y livepatch acumulativo.
21. Referencias
- KernelNewbies: Linux 5.1 — inventario completo por subsistema.
- ChangeLog-5.1 — la lista completa de commits.
- Phoronix: Linux 5.1 features — repaso de las novedades.
- kernel.org: releases — calendario y LTS.