Linux 5.10: LTS, ext4 fast commit y static calls
La LTS de 2020 llega con fast commit en ext4, restricciones de io_uring, process_madvise y static calls. 16.174 changesets y cinco años de mantenimiento.
Linux 5.10 se publicó el 13 de diciembre de 2020 y es la LTS de 2020, con mantenimiento previsto hasta finales de 2026. Incluye fast commit en ext4, restricciones para compartir anillos de io_uring, process_madvise() y static calls que evitan los retpolines. El ciclo suma 16.174 changesets y 1.971 desarrolladores.
La release sale el domingo 13 de diciembre de 2020, nueve semanas después de 5.9 y dentro de la serie 5.x. La merge window se abrió el 12 de octubre y cerró el 25 de octubre, y el árbol se estabilizó en siete release candidates.
Las cifras de este post son las de LWN, que cuenta changesets sin merges: 16.174 changesets y 1.971 desarrolladores. Es el segundo ciclo más grande de la serie 5.x, solo por detrás de los 16.306 de 5.8, y el que más trabajo acumula antes de una LTS.
Hay tres claves. La primera es el rendimiento: ext4 acelera fsync() y las static calls recuperan parte de lo que perdieron las mitigaciones de Spectre. La segunda es la seguridad: io_uring se puede compartir con procesos menos confiables y AMD cifra los registros de sus invitados. La tercera es la memoria: process_madvise() deja que un daemon gestione la memoria de otras aplicaciones.
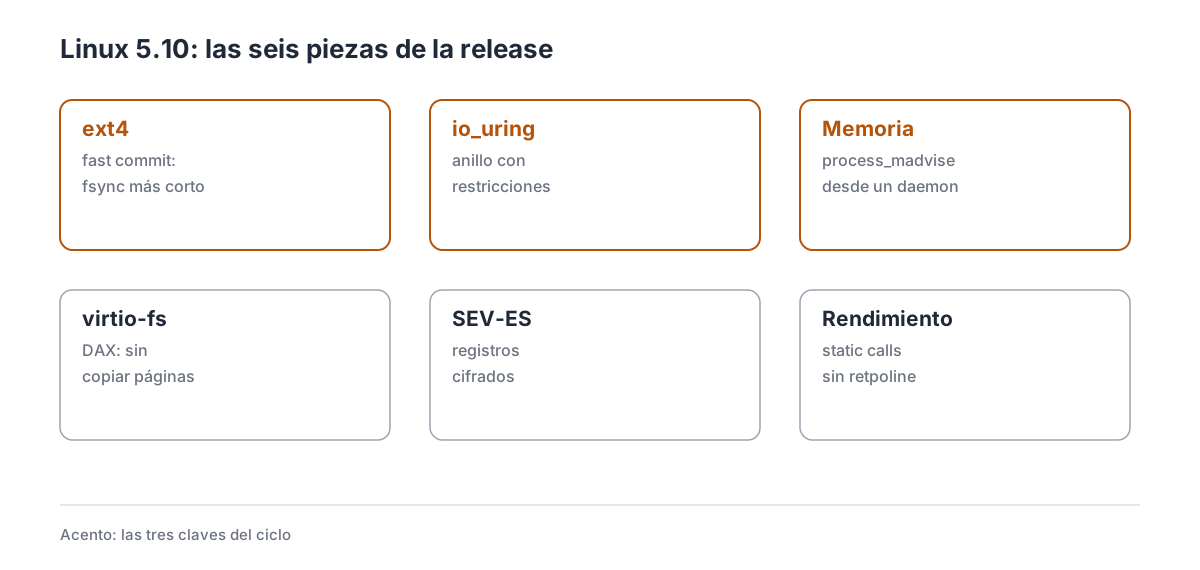
Las seis piezas que explican el ciclo, con las tres claves marcadas en ámbar.
1. Las cifras de la LTS
| Dato | Valor |
|---|---|
| Fecha de release | 13 de diciembre de 2020 |
| Versión anterior | 5.9 (11 de octubre de 2020) |
| Merge window | 12 al 25 de octubre de 2020 |
| Release candidates | 7 |
| Changesets | 16.174 |
| Desarrolladores | 1.971 |
| Mantenimiento | LTS hasta finales de 2026 |
El ciclo se queda a 132 changesets del récord de 5.8 y supera en casi dos mil a 5.11. Los 1.971 desarrolladores son la segunda cifra más alta de la serie, solo por detrás de los 1.991 de 5.8, y explican por qué el árbol tarda más en estabilizarse: más gente trabajando en más código.
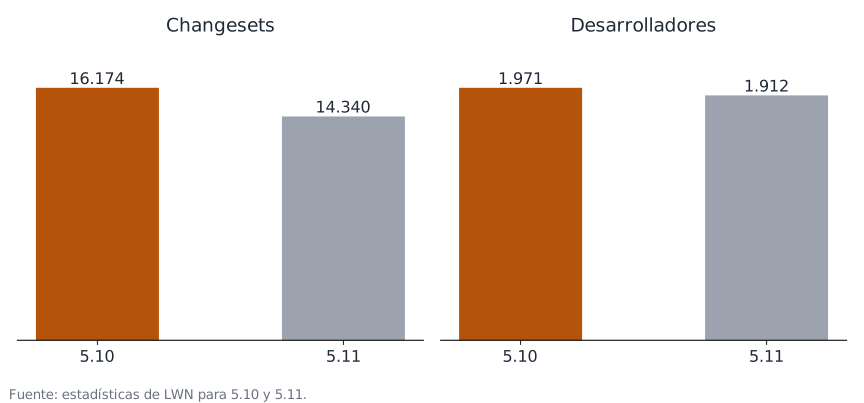
Las dos releases comparadas con las estadísticas de LWN, que no cuentan los merges.
La LTS no se elige sola: la decide la comunidad de maintainers y depende de cuántas distribuciones y dispositivos vayan a usarla. 5.10 fue la elegida de 2020, con seis años de correcciones y un flujo de versiones estables semanales.
La LTS anterior, 5.4, sigue viva y convive con 5.10 durante años; las dos reciben parches de seguridad, pero no drivers nuevos. El coste de mantener una LTS es alto: cada corrección se revisa dos veces, una para mainline y otra para la rama estable, y los maintainers arrastran cientos de parches. Por eso no todas las releases pueden serlo, aunque el número de empresas que la usan sea grande.
2. ext4 fast commit: fsync() sin escribir de más
Una aplicación que guarda un fichero llama a fsync() para asegurarse de que los datos están en el disco. En ext4, esa llamada podía acabar escribiendo más metadatos de los necesarios: el journal tradicional registra bloques completos, y un cambio pequeño arrastra una transacción grande.
Fast commit cambia el journal: en vez de escribir bloques, anota solo la información mínima para que la recuperación tras un fallo pueda reconstruir los metadatos que tocó el fsync(). El resultado es un journal mucho más corto y una llamada más rápida.
El journal rápido se escribe al final de la transacción, como un registro aparte, y la recuperación lo aplica antes que el journal normal. La mejora se aprecia en cargas con muchos ficheros pequeños: bases de datos, correo, repositorios y compilaciones, donde el cuello de botella son las operaciones, no el ancho de banda. En las pruebas que acompañaron al parche, el rendimiento de fsync() mejoraba de forma clara y el resto del sistema no empeoraba.
La función se activa al crear el sistema de ficheros con mkfs.ext4 -O fast_commit; no se puede encender en un volumen existente sin reformatear. Los límites: la recuperación solo funciona con esa opción activa, y un fallo durante la escritura del journal rápido vuelve al journal completo. La documentación de ext4 recoge las opciones.
3. io_uring con restricciones: compartir el anillo sin regalar el kernel
io_uring permite enviar operaciones de E/S desde un anillo compartido entre kernel y usuario. Es rápido, pero si un proceso comparte su anillo con otro menos confiable, el invitado puede pedir operaciones que el dueño no quería permitir: abrir ficheros, cambiar credenciales o registrar recursos.
Las restricciones de 5.10 añaden un registro de políticas: el dueño del anillo declara qué opcodes, qué banderas y qué operaciones de registro se permiten, y el kernel rechaza el resto. El anillo se crea deshabilitado, se configura y solo entonces se activa.
io_uring nació en 5.1 como una interfaz para hacer E/S sin syscalls por operación, y en año y medio se había ganado usuarios en bases de datos y servidores web. Los casos de uso están en la nube y en los navegadores: un servicio puede dar a un cliente un anillo con acceso solo a sus descriptores, sin que el cliente pueda salirse del contrato. También sirve para sandboxes que quieren E/S rápida sin dar acceso total al sistema.
Los límites: las restricciones son una lista de permitidos, no un sistema de capacidades completo; y si el dueño se equivoca al configurarlas, el invitado hereda ese error. La documentación de io_uring describe la API.
4. process_madvise: consejos de memoria para otro proceso
madvise() permite a un proceso decirle al kernel cómo va a usar un rango de memoria: que lo va a necesitar pronto, que puede liberarlo, que no lo va a tocar. El problema es que en Android y en otros sistemas el que sabe qué hacer es un daemon central, no la aplicación.
process_madvise(2) resuelve eso: toma un pidfd del proceso objetivo, un vector de rangos y un consejo, y aplica el consejo a la memoria de ese proceso. El daemon puede liberar memoria de una aplicación en segundo plano sin que la aplicación colabore.
La llamada toma un vector de iovec, igual que readv, así que un daemon puede aconsejar varios rangos en una sola operación. Sirve para gestionar la memoria del sistema, no la de un proceso: el kernel comprueba que quien llama tiene permiso sobre el objetivo, y solo acepta un conjunto limitado de consejos, entre ellos MADV_COLD y MADV_PAGEOUT.
Los límites: no sirve para leer ni escribir la memoria del otro proceso, solo para dar consejos; y un consejo no obliga al kernel a hacer nada, es una pista. La documentación de memoria recoge las políticas.
5. virtio-fs con DAX: el sistema de ficheros del host sin copiar
virtio-fs comparte directorios del host con una máquina virtual con la API de un sistema de ficheros. Hasta 5.10, los datos pasaban por la página del invitado: el host los leía y el invitado los copiaba, con dos copias y el doble de memoria.
El soporte de DAX cambia el modelo: el invitado mapea directamente la página del host en su espacio de direcciones y se salta su propia caché. El resultado es menos memoria y menos copias, sobre todo en ficheros grandes que se leen varias veces.
virtio-fs entró en 5.4 como respuesta a los sistemas de ficheros de red de las máquinas virtuales, que añadían latencia y complejidad. Quien más gana son los entornos de desarrollo y los contenedores con máquina virtual: un editor dentro de la VM puede abrir el código del host casi a velocidad nativa, sin duplicar el árbol en RAM.
Los límites: DAX necesita que el hipervisor exponga una región de memoria compartida y que el sistema de ficheros del host lo admita; sin eso, virtio-fs sigue funcionando en modo normal. La documentación de virtio describe el dispositivo.
6. SEV-ES: cifrar también los registros del invitado
AMD SEV cifra la memoria de las máquinas virtuales para que el hipervisor no pueda leerla. Pero los registros de la CPU del invitado seguían siendo visibles en cada cambio de contexto, y con ellos el estado de la ejecución.
SEV-ES cifra también ese estado: el invitado guarda sus registros en una zona cifrada (la VMSA) y el hipervisor solo ve lo que el invitado decide compartir. En cada world switch, el firmware cifra y descifra el estado.
SEV lleva en el kernel desde 4.15 y se apoya en el firmware PSP de AMD para gestionar las claves; SEV-ES añade el estado de la CPU a la misma frontera de confianza. La diferencia está en el modelo de amenaza: con SEV, el hipervisor no lee la memoria pero puede manipular los registros; con SEV-ES, tampoco los registros. Un host comprometido sigue pudiendo negar servicio o hacer ataques de canal lateral, pero no leer secretos directamente.
Los límites: hace falta un procesador AMD con SEV-ES y un hipervisor que lo soporte; el arranque y la atestación necesitan firmware y software de invitado preparados. La documentación de KVM recoge el soporte.
7. static calls: llamar sin retpoline
Después de Spectre, el kernel cambió muchas llamadas indirectas por retpolines, que son seguros pero caros. Una llamada a través de un puntero a función se convierte en una secuencia de instrucciones que el predictor no puede especular.
Las static calls recuperan el rendimiento: el kernel parchea en el sitio de la llamada una instrucción de salto directo, y cuando el destino cambia, reescribe el código con la nueva dirección. El resultado es una llamada directa, sin retpoline, con la flexibilidad de un puntero.
Los retpolines se generalizaron como mitigación de Spectre v2 y se llevaron puntos de rendimiento en las llamadas indirectas. Las static calls son la excepción selectiva a esa mitigación. El primero que las usa es perf: el manejador de la PMU usa punteros a función y con static calls es un 4,2 % más rápido. El patrón se puede aplicar a cualquier punto caliente con un destino que cambia poco.
Los límites: el parcheo necesita sincronización entre núcleos y no se puede hacer en cualquier contexto; y si el destino cambia mucho, el coste de parchear supera al de una llamada indirecta. La documentación del kernel recoge las APIs internas.
8. MTE: etiquetas de memoria para el usuario
La Memory Tagging Extension de ARMv8.5 asocia una etiqueta a cada fragmento de memoria y otra a cada puntero. Cuando un programa accede con una etiqueta distinta, el hardware avisa: es una forma de detectar desbordamientos y usos después de liberar sin instrumentar cada acceso.
5.10 añade el soporte de usuario: el proceso activa las etiquetas con prctl(PR_SET_TAGGED_ADDR_CTRL), recibe direcciones etiquetadas y puede elegir entre un fallo inmediato y uno diferido. El kernel tiene que aceptar esas direcciones en las llamadas al sistema.
El modelo tiene tres piezas: una etiqueta por asignación, la etiqueta en el puntero y una comprobación en cada acceso que hace el hardware. La mejora se aprecia en los allocators y en los lenguajes con recolector: un malloc puede etiquetar cada bloque y detectar el uso de memoria liberada sin cambiar el programa. El problema es que hace falta hardware con MTE.
Los límites: en 2020 no había hardware comercial con MTE, así que el soporte se probó en emuladores y en el modelo de ARM; y el modo asíncrono pierde precisión sobre dónde ocurrió el fallo. La documentación de arm64 recoge la extensión.
9. Hardware y plataformas
En virtualización, vfio suma el paso de información zPCI y el soporte de FSL-MC, y vhost-scsi admite reset de LUN.
En x86, el trabajo de virtualización y el de compatibilidad con Wine van de la mano: los dos necesitan que el kernel exponga instrucciones que Windows da por hechas. En x86 llega la emulación de SLDT y STR que necesita Wine, el intercambio de direcciones virtuales con dispositivos y el soporte para CPUs Centaur Family 7.
En ARM, el ciclo también suma soporte para placas de desarrollo y para la virtualización anidada. En ARM entran el Kontron sl28cpld, el TPM del SynQuacer y la SVA del SMMUv3, que comparte direcciones virtuales entre CPU y dispositivos. En s390 hay inyección de fallos y claves ECC seguras.
También se retira: ARC pierde la plataforma EZChip NPS y varios drivers antiguos desaparecen del árbol. Los límites: el hardware nuevo necesita firmware; el resto son placas y hardware de nicho. La documentación de x86 recoge las plataformas.
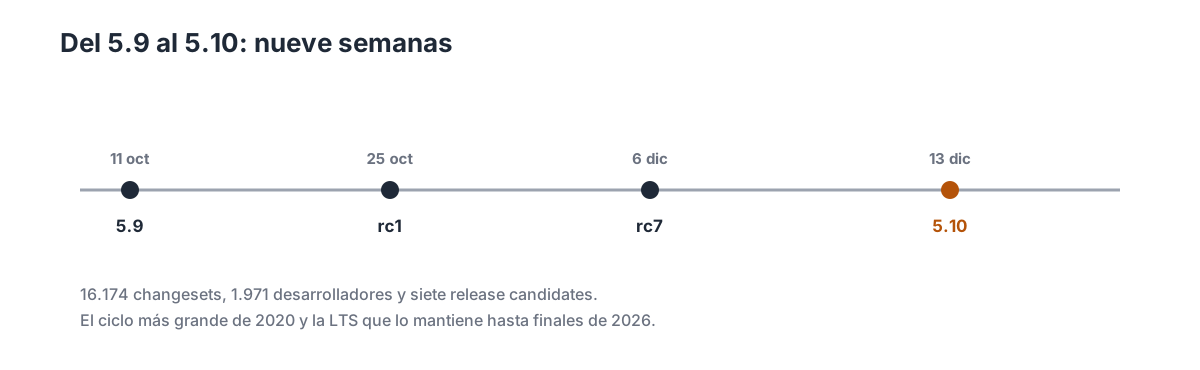
Nueve semanas de ciclo, con siete release candidates y una LTS al final.
10. Por subsistemas
10.1 Core y herramientas
Llega la opción de montaje nosymfollow, que impide seguir enlaces simbólicos en un montaje, y los pidfd no bloqueantes para waitid(). io_uring permite esperar el consumo del anillo con SQPOLL y el bloque contabiliza la E/S delegada al cgroup correcto.
10.2 Sistemas de ficheros
Btrfs mejora fsync y rename/link, pasa la E/S directa a iomap y unifica las reservas con tickets. XFS guarda los contadores del árbol de inodos en el AGI para acelerar el montaje, y sysfs exporta la versión de send.
10.3 Memoria
La gestión de THP deja de suponer el tamaño de página y se prepara para páginas de 64K, la contabilidad de memcg cubre las asignaciones desde interrupción y cgroup v2 gana numa_stat. El manejo de HWPOISON se reescribe.
10.4 Bloque
Se puede usar IOPRIO_CLASS_RT con CAP_SYS_NICE, iocost mejora su precisión y perdona la deuda. SCSI comparte tags entre los puertos de un HBA y null_blk imita los límites de zonas.
10.5 Traza, perf y BPF
BPF estrena un iterador de sockmap, opciones de cabecera TCP y soporte mínimo de programas que duermen. Un módulo de ejemplo llena bpffs con iteradores y llega tcp_notsent_lowat por setsockopt.
10.6 Virtualización
Nitro Enclaves añade su dispositivo y su API, vDPA puede informar el rango de IOVA y el simulador permite fijar la MAC. KVM y vfio reciben correcciones y más soporte de dispositivos.
10.7 Networking
La pila añade inet_diag para todos los sockopt, randomiza el limitador de ICMP para no filtrar estado y permite más de 255 interfaces multicast. TCP puede reflejar el TOS del SYN.
10.8 Criptografía y seguridad
Llega el algoritmo SM2 y los certificados OSCCA, ecb(arc4) queda obsoleto y el PRNG de red se refuerza. La API de IOMMU para usuario se amplía.
11. Lo que no llega
ext4 fast commit exige formatear de nuevo: no se puede activar en un volumen existente, y la recuperación solo funciona con la opción puesta. Las restricciones de io_uring son una lista de permitidos, no un modelo de capacidades.
process_madvise solo acepta unos pocos consejos y no da acceso a la memoria ajena. virtio-fs con DAX necesita memoria compartida del hipervisor. SEV-ES necesita CPU AMD y firmware compatible, y MTE no tenía hardware comercial en 2020.
Y 5.10 es LTS, pero eso no significa que todo funcione: la LTS cubre correcciones, no drivers nuevos. Quien compre hardware posterior a la release necesitará un kernel más reciente, como recuerda el calendario de kernel.org.
12. Cambios menores
Core
- casefold — convive con cifrado en ext4.
- BPF —
BPF_F_PRESERVE_ELEMSen el array de perf. - xen-blk — persistent grants opcionales.
Drivers I
- EDAC — controlador de memoria de Annapurna Labs.
- MTD — framework de motores ECC.
- GPIO — nueva versión de la uAPI de
cdev.
Drivers II
13. Qué viene después
La merge window de 5.11 se abre el 14 de diciembre y cierra el 27 de diciembre. Ese ciclo traerá SGX, overlayfs sin privilegios y Syscall User Dispatch, según el inventario de KernelNewbies; Linux 5.11 sale el 14 de febrero de 2021.
Para las distribuciones, 5.10 es la base de Debian 11 y de muchas imágenes de servidor, y por eso su mantenimiento importa más que el de una release normal. Las distribuciones rolling la adoptan en semanas. La LTS anterior, 5.4, sigue viva.
Las próximas releases mostrarán si fast commit se convierte en el modo por defecto de ext4, si las restricciones de io_uring se usan en la nube y si las static calls se extienden al resto del kernel.
14. Referencias
- KernelNewbies: Linux 5.10 — inventario completo por subsistema.
- ChangeLog-5.10 — la lista completa de commits.
- LWN: Fast commits for ext4 — el diseño del fast commit.
- LWN: Operations restrictions for io_uring — las restricciones del anillo.
- LWN: process_madvise(), pidfd capabilities, and the revenge of the PIDs — la nueva llamada.
- LWN: Relief for retpoline pain — las static calls.
- LWN: The Arm64 memory tagging extension in Linux — MTE.
- Phoronix: Linux 5.10 features — repaso de las novedades.
- kernel.org: releases — calendario y LTS.