Linux 5.11: SGX, overlayfs sin root y syscalls de Wine
El kernel estrena SGX, overlayfs para usuarios sin privilegios y Syscall User Dispatch para Wine. 14.340 changesets en un ciclo medio.
Tres años después de las primeras series, SGX entra en el kernel: Linux 5.11 se publicó el 14 de febrero de 2021 con enclaves cifrados, overlayfs que ya pueden montar los usuarios sin privilegios y Syscall User Dispatch para que Wine atienda las llamadas de Windows sin trucos. El ciclo suma 14.340 changesets y 1.912 desarrolladores.
La release sale el domingo 14 de febrero de 2021, nueve semanas después de Linux 5.10 y dentro de la serie 5.x. La merge window se abrió el 14 de diciembre y cerró el 27 de diciembre, y el árbol se estabilizó en siete release candidates.
Las cifras de este post son las de LWN, que cuenta changesets sin merges: 14.340 changesets y 1.912 desarrolladores, de los que 280 enviaban su primer parche. Es un ciclo medio dentro de la serie 5.x, con 608.000 líneas netas más que 5.10.
Hay tres claves. La primera es la compatibilidad: Syscall User Dispatch deja que un emulador intercepte llamadas al sistema sin penalizar al resto del sistema. La segunda es los permisos: overlayfs deja de exigir root. La tercera es el hardware: SGX y las GPU de AMD e Intel que estaban por salir.
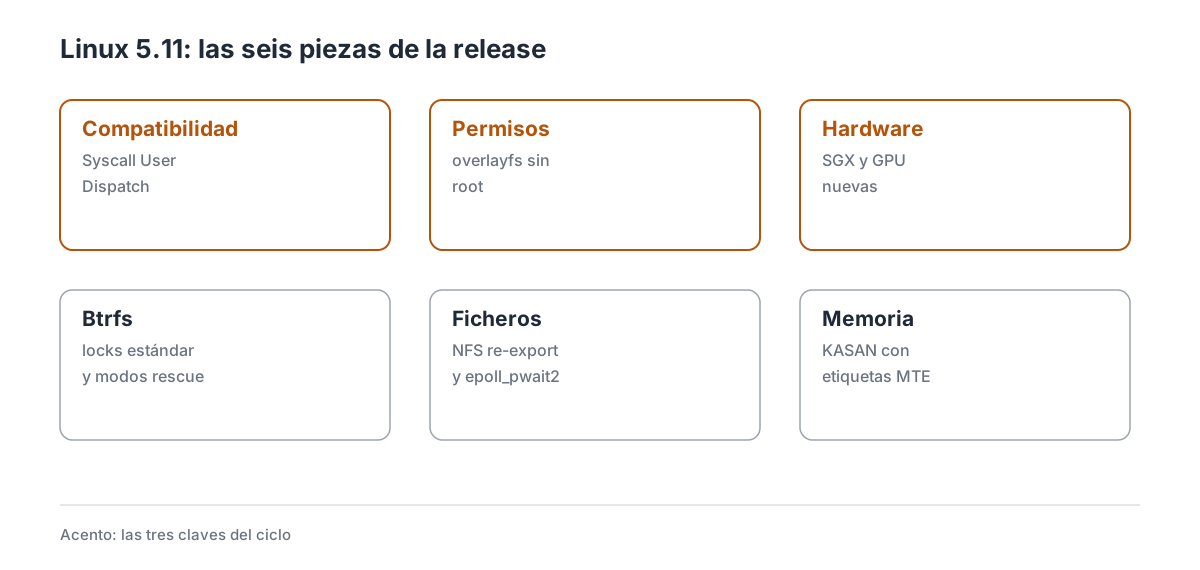
Las seis piezas que explican el ciclo, con las tres claves marcadas en ámbar.
1. Las cifras de un ciclo medio
| Dato | Valor |
|---|---|
| Fecha de release | 14 de febrero de 2021 |
| Versión anterior | 5.10 (13 de diciembre de 2020) |
| Merge window | 14 al 27 de diciembre de 2020 |
| Release candidates | 7 |
| Changesets | 14.340 |
| Desarrolladores | 1.912 |
| Novatos | 280 |
El ciclo se queda por debajo de los 16.174 changesets de 5.10 y por encima de los 13.015 de 5.12: es el centro de la tabla. Las 608.000 líneas netas que añade no son solo código nuevo: incluyen cabeceras de GPU, tablas de firmware y drivers de plataformas que se activan con un defconfig. Los 1.912 desarrolladores también están en la media, y los 280 novatos son la señal de que el relevo generacional sigue funcionando.
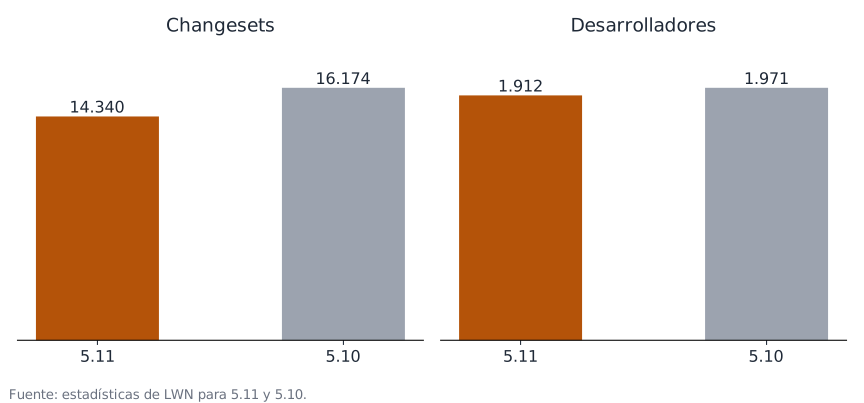
Las dos releases comparadas con las estadísticas de LWN, que no cuentan los merges.
En el reparto por empresas, Intel va primero (9,5 %), seguida de Linaro (7,3 %), Red Hat y AMD (5,8 %), Huawei (5,3 %) y Google (4,9 %). Por líneas modificadas AMD se lleva casi el 40 %, gracias a las cabeceras de sus GPU y al trabajo de RAS.
El desarrollador más activo es Lee Jones, como en los ciclos vecinos, con limpieza de avisos por delante de cualquier feature. Detrás aparecen los nombres de siempre en i915, io_uring y red: es un ciclo de mantenimiento amplio, no de un solo titular.
2. Syscall User Dispatch: los syscalls de Windows sin tocar el kernel
Wine y los emuladores tienen un problema: una aplicación de Windows hace llamadas al sistema con la convención de Windows, y el kernel de Linux no sabe qué hacer con ellas. La solución clásica era interceptarlas una a una o cambiar el código, y las dos cosas cuestan rendimiento.
Syscall User Dispatch lo resuelve con una región de memoria: el proceso declara una región de memoria con un byte de control, y el kernel consulta ese byte en cada llamada. Si está activo, la llamada no se ejecuta y se convierte en una señal SIGSYS que el emulador atiende. Si está apagado, el camino es el normal.
La alternativa era seccomp, pero seccomp filtra por número de llamada y obliga a un user_notif con ida y vuelta al emulador, que es justo el coste que Wine no puede permitirse en cada NtReadFile. El diseño cuida el coste: la comprobación es una lectura de un byte en la memoria del proceso, y el resto del sistema no paga nada. Se activa con prctl(PR_SET_SYSCALL_USER_DISPATCH) y se puede encender y apagar desde el propio emulador en cada hilo.
El coste de una llamada redirigida es una señal: el emulador sale del kernel, lee los registros y decide. Para las llamadas de Windows, que ya de por sí cruzan una capa de emulación, ese coste es aceptable; para las de Linux, el byte de control está apagado. En 5.11 el soporte es para x86; otras arquitecturas llegaron después. Los límites: no sirve para interceptar llamadas del propio kernel ni para aislar a un proceso malicioso, y el emulador tiene que gestionar la señal sin bloquearse. La documentación de Syscall User Dispatch describe el mecanismo.
3. Overlayfs sin privilegios
Overlayfs monta un directorio encima de otro y guarda los cambios en una capa superior. Es la base de los contenedores y de las imágenes de solo lectura, pero durante años solo podía montarlo root, porque el kernel no tenía claro que las operaciones sobre las capas inferiores se hicieran con los permisos correctos.
5.11 permite los montajes sin privilegios después de auditar el código: cada operación sobre las capas se ejecuta con los privilegios de la tarea que monta, no con los del usuario que hizo la llamada. Eso permite que los usuarios normales usen overlayfs y a los espacios de nombres de usuario.
El caso típico son los contenedores sin root: un usuario puede construir una imagen con capas y montarla sin sudo, y un entorno de escritorio puede usar overlayfs para una sesión desechable. Con la opción userxattr, las marcas se guardan en user.overlay.* en vez de en trusted.overlay.*, que requiere privilegios.
Los límites: sin privilegios hay operaciones que siguen prohibidas, como montar sobre un directorio que el usuario no controla, y el montaje no da acceso a ficheros que el usuario no podría leer. La documentación de overlayfs recoge las restricciones.
4. SGX: enclaves en el kernel
Intel SGX crea enclaves: regiones de memoria cifradas por el procesador donde el código y los datos quedan fuera del alcance del sistema operativo, del hipervisor y de cualquiera con acceso físico. Es la tecnología que usan los reproductores de vídeo para proteger claves y los servicios de nube para computación privada.
El soporte entra en 5.11 con el driver, la gestión de la memoria EPC y las ioctls para crear y ejecutar enclaves. La pieza nueva es /dev/sgx_enclave, y el trabajo de atestación usa /dev/sgx_provision.
El EPC es una zona de memoria reservada por el firmware y el driver la reparte entre enclaves; cuando se llena, el sistema no puede usarla para otra cosa. Lo importante es que el kernel no puede leer el enclave: el driver mueve páginas y gestiona permisos, pero el contenido está cifrado con una clave que solo conoce el procesador. Ni un root comprometido puede abrirlo.
Los límites: hace falta CPU con SGX habilitado en la BIOS y no todos los modelos lo tienen; el soporte es de base y las funciones de atestación remota dependen de servicios externos. La documentación de SGX describe el modelo.
5. Gráficos: Vangogh, Green Sardine y Dimgrey Cavefish
El ciclo añade soporte para las GPU de AMD que iban a salir: Vangogh para consolas y portátiles, Green Sardine para APU y Dimgrey Cavefish para la gama media de RDNA 2. En Intel, el driver de DG1 mejora y llega el escalado entero, que replica píxeles sin interpolar para que un juego de baja resolución se vea nítido en una pantalla grande.
El escalado entero necesita explicación aparte: en un monitor de 4K, un juego a 1080p se ve borroso si el driver interpola los píxeles, y nítido si replica cada píxel cuatro veces. El patrón es el de siempre: el kernel reconoce el hardware antes de que esté a la venta, y las distribuciones tardan meses en tener la versión que lo usa. La contrapartida es que el soporte inicial no cubre todo: faltan frecuencias, aceleración de vídeo y algunas funciones de cálculo.
Los límites: quien compre la GPU el día del lanzamiento necesitará un kernel reciente y firmware actualizado. La documentación de DRM describe el modelo de drivers.
6. Btrfs: locks estándar y modos de rescate
Btrfs cambia una pieza interna: el árbol de búferes deja el esquema de bloqueo propio y usa los semáforos de lectura y escritura del kernel. El cambio se aprecia en cargas con mucha concurrencia, donde el lock casero se convertía en el cuello de botella.
También llegan mejoras para cargas tipo dbench y, sobre todo, opciones para rescatar un sistema de ficheros dañado: rescue=ignoredatacsums ignora los checksums que fallan, rescue=ignorebadroots intenta montar en solo lectura aunque las raíces del árbol estén corruptas, y rescue=all activa las dos y desactiva el replay del log.
El cambio de locks no es solo estético: el esquema anterior usaba un contador propio y ahora compite con el resto del kernel en igualdad de condiciones, con lo que el perfil de contención cambia. El caso real es un disco que empieza a dar errores de checksum: el administrador monta con rescue=all, copia lo que se puede leer y sustituye el disco. La diferencia es poder copiar los datos antes de tirar el disco: sin estas opciones, un mount falla y el usuario se queda sin acceso. Con ellas, el sistema monta en un modo degradado y permite sacar lo que se pueda.
Los límites: rescatar no repara; los datos con checksum malo se sirven igual y pueden estar corruptos. La documentación de Btrfs explica cada opción.
7. NFS re-export y esperas de nanosegundos
Dos cambios para servidores. El primero es el re-export de NFS: un servidor Linux puede exportar por NFS un montaje que ya es NFS, con lo que sirve de caché intermedia entre un servidor principal y los clientes. El caso que lo motivó es reexportar NFSv4.2 con pNFS por NFSv3, algo que antes no era posible.
El segundo es epoll_pwait2(2): la misma espera de epoll, pero con un struct timespec en vez de milisegundos enteros. En redes de centro de datos, los tiempos por debajo del milisegundo cambian la forma de las colas.
El re-export también sirve para migrar: un servidor intermedio puede mantener la caché caliente mientras el almacenamiento principal se mueve. Las dos piezas apuntan a la escala: una añade un salto en la topología de almacenamiento, la otra afina la latencia. Los límites: el re-export no convierte NFS en un sistema local y hereda los problemas del servidor de origen; epoll_pwait2 necesita un kernel y una libc que lo conozcan. La documentación de NFS recoge las opciones.
8. KASAN con etiquetas de memoria en arm64
KASAN detecta errores de memoria, pero su versión software instrumenta cada acceso y consume mucha memoria. arm64 tiene desde ARMv8.5 la Memory Tagging Extension: el hardware asocia una etiqueta a cada fragmento de memoria y otra a cada puntero, y avisa cuando no coinciden.
5.11 añade el modo de KASAN con etiquetas por hardware: el compilador no instrumenta cada acceso y el coste baja de forma notable, aunque sigue habiendo comprobaciones. Los parámetros de arranque permiten elegir el modo y la fracción de memoria que se vigila.
Las etiquetas se guardan en los bits altos de cada puntero y de cada grano de 16 bytes de memoria, y el hardware compara en cada acceso. El beneficio es poder dejar KASAN activado en pruebas reales sin que el sistema vaya lento. La contrapartida es que necesita hardware con MTE, que en 2021 era escaso fuera de los prototipos.
Los límites: MTE detecta accesos con etiqueta distinta, no todos los errores lógicos; y el soporte de software sigue siendo más completo. La documentación de KASAN describe los modos.
9. Hardware y arquitecturas
El ciclo es generoso en plataformas ARM. Entran la MStar Infinity2M, un chip de cámaras IP con dos Cortex-A7; el Nuvoton NPCM730, un controlador de placa base; el Broadcom BCM4908 de los routers domésticos; y el MediaTek MT8192 de los Chromebooks.
En x86, Intel añade la tabla de C-states de SnowRidge y Alder Lake-P suma soporte de traza. Los SoC de Microsemi crecen con Luton, Serval y Jaguar2, y parisc permite configurar el tamaño de la pila de usuario.
El patrón es el de siempre: el kernel reconoce placas y chips antes de que se vendan, y cada defconfig incorpora soporte para una familia nueva. La contrapartida es que el soporte inicial no cubre todos los periféricos.
Los límites: el hardware nuevo necesita firmware y, a menudo, un kernel más reciente que el de la distribución. La documentación de ARM64 recoge las plataformas.
10. Por subsistemas
10.1 Core y herramientas
seccomp añade una caché en mapa de bits para los filtros que solo permiten o bloquean, y la entrega de señales usa task_work para no montar un contexto completo. io_uring permite ficheros no fijados con SQPOLL y el rwsem mejora el giro optimista del lector.
10.2 Sistemas de ficheros
sysfs exporta la generación del sistema de ficheros para que los backups detecten cambios sin recorrer el árbol. Btrfs mejora las cargas tipo dbench, y el resto de sistemas reciben correcciones de montaje.
10.3 Memoria
mremap se acelera en regiones grandes, la lectura con búfer agrupa asignaciones y copias y llega una variante preemptible de kmap_atomic. El bloqueo de LRU pasa a ser por memcg, y el modo no jerárquico de cgroup v1 queda obsoleto.
10.4 Bloque
null_blk permite limitar max_hw_sectors para probar el stack, rnbd admite dos dispositivos con el mismo nombre y dm-verity verifica firmas con un segundo llavero. dm-mpath estrena un selector de rutas por CPU.
10.5 Traza, perf y BPF
Los programas BPF pasan de memlock a contabilidad por memcg, y los módulos pueden tener programas de traza con BTF. perf record guarda el tamaño de página y un helper nuevo calcula el hash de IMA de un inodo.
10.6 Networking
Llega el busy-polling preferente para repartir el sondeo entre varias colas, SRv6 suma End.DT4 y End.DT6 y RTM_GETROUTE puede devolver la encapsulación de la ruta. batman-adv elige el algoritmo de rutas por rtnetlink.
10.7 Arquitecturas
En x86, la PMT de Intel expone contadores de hardware y la invariancia de frecuencia de AMD alimenta al scheduler. En s390, el área de vmalloc sube a 512 GB; en RISC-V llega CMA; y en MIPS, Loongson estrena KASLR.
10.8 Drivers y plataformas
DRM añade el filtro de escalado que incluye el modo entero, los mapeos de objetos GEM desde memoria de E/S y el pinctrl de Alder Lake-S. Las tarjetas MMC admiten SD Express, Thunderbolt suma el NVM de Maple Ridge y el bus MHI tiene driver PCI para módems WWAN.
11. Lo que no llega
La lista de límites empieza por la cobertura: en 5.11 el mecanismo solo existe en x86 y el emulador debe gestionar SIGSYS sin bloquear el hilo. Tampoco aísla a un proceso malicioso; solo redirige llamadas.
El soporte de SGX no incluye la atestación remota completa ni la gestión de claves fuera del enclave: eso queda para el software de usuario. Overlayfs sin privilegios no da acceso a lo que el usuario no podría leer, y algunas combinaciones de capas siguen prohibidas. SGX exige CPU compatible y BIOS habilitada, y el soporte es de base. Las GPU nuevas necesitan firmware y un kernel reciente. Btrfs rescata, pero no repara.
Y 5.11 no es LTS: la LTS es 5.10, que sale dos meses antes y se mantiene cinco años, según el calendario de kernel.org.
12. Cambios menores
Core
- inotify — más relojes por usuario.
- reboot — modo de reinicio por sysfs.
- tty synclink — driver redundante fuera.
Ficheros y bloque
- PCIe — decodifica el enlace de 64 GT/s.
- xen-blk — persistent grants opcionales.
- IOPRIO — clase realtime con
CAP_SYS_NICE.
Drivers
13. Qué viene después
La merge window de 5.12 se abre el 15 de febrero y cierra el 28 de febrero. Ese ciclo traerá idmapped mounts, KFENCE, LTO de Clang y el preempt elegible en el arranque, según el inventario de KernelNewbies; Linux 5.12 sale el 25 de abril.
Para las distribuciones, 5.11 es la base de Fedora 34 y de Ubuntu 21.04, que llegan en abril con overlayfs sin privilegios y SGX. Las rolling la adoptan en semanas. La LTS sigue siendo 5.10.
Las próximas releases mostrarán si SGX se usa fuera de la nube, si Wine aprovecha Syscall User Dispatch y si KASAN con MTE se vuelve práctico cuando llegue más hardware.
14. Referencias
- KernelNewbies: Linux 5.11 — inventario completo por subsistema.
- ChangeLog-5.11 — la lista completa de commits.
- LWN: Emulating Windows system calls, take 2 — el diseño de Syscall User Dispatch.
- LWN: SGX: when 20 patch versions aren’t enough — la historia de SGX.
- LWN: epoll_pwait2(), close_range(), and encoded I/O — las esperas de nanosegundos.
- Phoronix: Linux 5.11 features — repaso de las novedades.
- kernel.org: releases — calendario y LTS.