Linux 5.12: idmapped mounts, KFENCE y LTO de Clang
idmapped mounts cambia el dueño de un montaje sin tocar los ficheros, KFENCE vigila la memoria en producción y el kernel se compila con LTO. 13.015 changesets.
Linux 5.12 se publicó el 25 de abril de 2021, con idmapped mounts para cambiar el dueño de un montaje sin tocar los ficheros, KFENCE para detectar errores de memoria en producción sin el coste de KASAN y el soporte de LTO para compilar el kernel con Clang como un solo programa. El ciclo suma 13.015 changesets y 1.873 desarrolladores, el más corto desde 5.6.
La release sale el domingo 25 de abril de 2021, diez semanas después de 5.11 y dentro de la serie 5.x. El ciclo necesitó ocho release candidates: el rc7 no bastó, Linus Torvalds dio una semana más y el rc8 llegó el 18 de abril para dejar el tree estable.
Las cifras de este post son las de LWN, que cuenta changesets sin merges: 13.015 changesets y 1.873 desarrolladores. Es el ciclo más lento desde 5.6, y LWN lo atribuye al volumen de correcciones: menos parches nuevos, más estabilización.
Hay tres claves. La primera es la identidad: idmapped mounts separa el dueño de un fichero del dueño con el que se ve en un montaje. La segunda es la memoria: KFENCE encuentra errores reales con una muestra pequeña y casi sin coste. La tercera es el compilador: LTO abre la puerta a optimizaciones globales y, detrás, a Clang CFI.
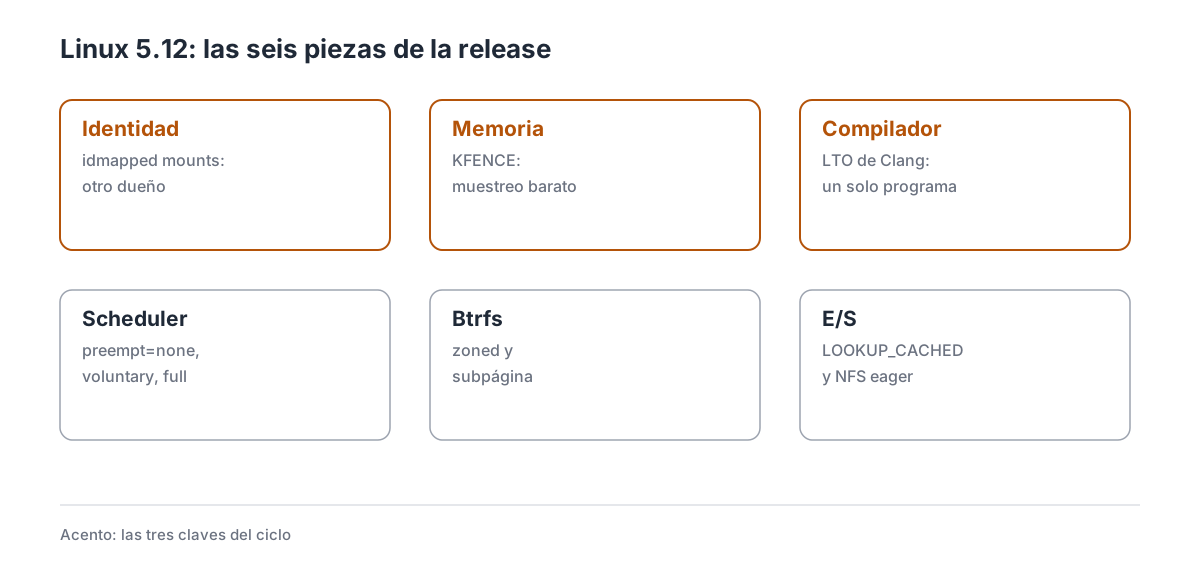
Las seis piezas que explican el ciclo, con las tres claves marcadas en ámbar.
1. Las cifras de un ciclo corto
| Dato | Valor |
|---|---|
| Fecha de release | 25 de abril de 2021 |
| Versión anterior | 5.11 (14 de febrero de 2021) |
| Merge window | 15 al 28 de febrero de 2021 |
| Release candidates | 8 |
| Changesets | 13.015 |
| Desarrolladores | 1.873 |
| Novatos | 262 |
| Empresas | 211 |
El ciclo se queda en 13.015 changesets, muy por debajo de los 16.030 de 5.13 y los 14.735 de 5.14. Los 1.873 desarrolladores también son menos que los 2.062 de 5.13, y los 262 novatos están en la media de un ciclo pequeño.
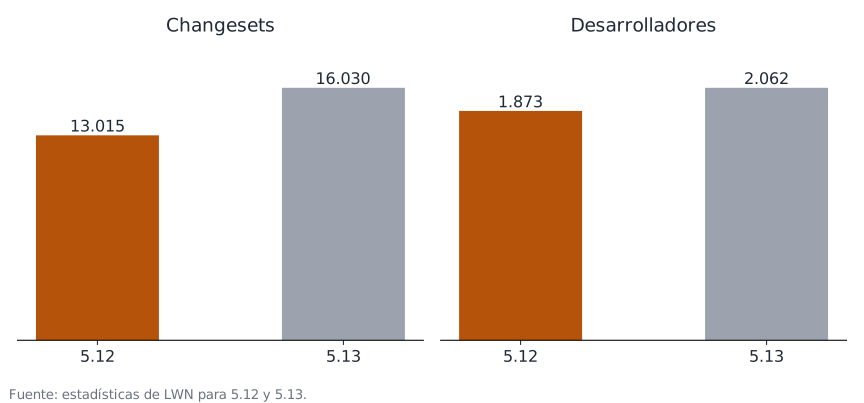
Las dos releases comparadas con las estadísticas de LWN, que no cuentan los merges.
En el reparto por empresas, Intel va primero (10,9 %), seguida de Red Hat y Linaro (6,7 %), Google (5,8 %), Huawei (4,0 %), Facebook (3,7 %) y AMD y NVIDIA (3,1 % cada una). Por líneas modificadas gana Arnd Bergmann, y no por escribir: por borrar arquitecturas y drivers que ya no usaba nadie.
Lee Jones vuelve a ser el más activo en changesets, con 256, casi todos de limpieza de avisos del compilador. Detrás aparecen Chris Wilson (i915), Pavel Begunkov (io_uring) y Vladimir Oltean (red). Es un ciclo de mantenimiento, con pocos titulares.
2. idmapped mounts: el mismo fichero con otro dueño
En Linux, un fichero tiene un uid y un gid guardados en el inodo. Cambiarlos significa recorrer el árbol y reescribir metadatos, algo caro en un sistema grande y arriesgado en un contenedor. idmapped mounts separa las dos cosas: el dueño real del fichero y el dueño con el que se ve a través de un montaje.
La pieza nueva es mount_setattr(2), que permite aplicar un idmapping a un montaje concreto. El mismo directorio puede verse como uid 1000 en un montaje y como uid 0 en otro, sin tocar el inodo ni el disco. El cambio es instantáneo y se puede deshacer desmontando.
Por dentro, el kernel guarda un struct mount con un puntero al idmapping y traduce los uid y gid al vuelo en cada consulta de atributos; los inodos no se tocan. Los casos de uso típicos son los contenedores y los directorios personales: compartir una carpeta del host con un contenedor sin privilegios sin hacer chown a todo, o montar el $HOME de un usuario en otra máquina donde su uid es distinto. systemd-homed lo usa para las homes portables, y Chrome OS para compartir la carpeta de descargas con su subsistema Linux.
En 5.12 el soporte cubre ext4, XFS y FAT como sistemas de ficheros, y deja fuera NFS, overlayfs y ecryptfs encima de un montaje con idmapping: no están portados y el kernel lo impide.
Los límites: un idmapping no da permisos que el fichero no tenga; solo cambia a quién se le atribuye. Si el proceso puede escribir el inodo, seguirá pudiendo. La documentación de idmapped mounts describe la API.
3. LTO: compilar el kernel como un solo programa
Un kernel normal se compila por ficheros: el compilador ve una unidad de traducción cada vez y no puede optimizar a través de ellas. Link Time Optimization cambia el modelo: el compilador guarda una representación intermedia y la optimiza toda junta en el enlazado, con lo que puede alinear funciones, eliminar código muerto y, más adelante, comprobar los tipos de las llamadas indirectas.
El soporte llega con CONFIG_LTO_CLANG y su variante ThinLTO, y exige la toolchain de LLVM. La serie llevaba años en las listas y entró en el rc6, algo poco habitual: las features suelen entrar en la merge window, y esta lo hizo con el ciclo casi cerrado.
ThinLTO optimiza por módulos y enlaza al final; el modo completo ve todo el programa, tarda más y consume más memoria. La comunidad eligió ThinLTO como opción práctica para un kernel de millones de líneas. Lo inmediato es el tamaño y el rendimiento; lo importante llega en 5.13, cuando CFI usa el LTO para saber qué funciones puede llamar cada puntero. Sin esta pieza, el control de flujo no se puede comprobar.
Los límites: el build tarda más y consume mucha memoria, algunos allmodconfig fallaron al principio y el soporte depende de Clang, no de GCC. La documentación de compilación con Clang recoge las variables.
4. KFENCE: encontrar el error sin instrumentar todo
KASAN detecta accesos fuera de límites y usos después de liberar, pero instrumenta cada acceso a memoria y su coste lo destierra de producción. KFENCE toma otro camino: reserva un conjunto pequeño de páginas, coloca cada objeto en una página vigilada por guard pages y solo muestrea una fracción de las asignaciones.
Cuando un objeto muestreado se sale de su página o se usa después de liberarse, el kernel da un fallo inmediato con la pila de la asignación y de la liberación. El coste es casi cero porque la mayoría de las asignaciones no se vigila, y por eso se puede dejar activado en un kernel de producción.
La contrapartida es la cobertura: al muestrear, KFENCE puede tardar mucho en ver un error que KASAN detectaría a la primera. No sustituye a KASAN en desarrollo ni a un test; es una red de seguridad en máquinas reales.
El detector se integró con syzkaller y con los tests del kernel, que pueden forzar el muestreo de todas las asignaciones durante una ejecución. En 5.12 funciona en x86_64 y arm64. Los límites: el pool es fijo, el muestreo se ajusta con kfence.sample_interval y los errores fuera de ese conjunto no se ven. La documentación de KFENCE explica el diseño.
5. Elegir el modelo de preempt en el arranque
Linux tiene tres modelos de expulsión: PREEMPT_NONE (nada), PREEMPT_VOLUNTARY (en puntos concretos) y PREEMPT (casi todo). Hasta ahora se elegía al compilar, así que una distribución necesitaba dos kernels o renunciar a uno.
5.12 permite elegirlo en el arranque con preempt=none, preempt=voluntary o preempt=full, y cambiarlo en caliente desde /sys/kernel/debug/sched/preempt. La implementación usa una variante nueva de static calls: el código de cada variante se parchea en el sitio de la llamada.
Las static calls son llamadas que se pueden reescribir en caliente: el kernel parchea el destino para que cada modelo ejecute su propia versión sin una rama en el camino caliente. Quien más gana son las distribuciones y los servidores: un mismo kernel puede arrancar en modo servidor, con menos cambios de contexto, o en modo escritorio, con mejor latencia interactiva. También sirve para medir el coste de cada modelo sin recompilar.
Los límites: el cambio en caliente no vuelve a compilar el kernel, así que hay código que solo existe en una variante y sigue compilado; y el modelo elegido afecta a todo el sistema, no a un proceso. La documentación de parámetros lista los valores.
6. Btrfs: dispositivos por zonas y páginas de 4K
Dos trabajos de fondo en Btrfs. El primero es el soporte inicial de dispositivos por zonas, esos discos que solo se pueden escribir de forma secuencial dentro de cada zona. El segundo es el soporte de bloques menores que una página, necesario para compartir un sistema de ficheros entre máquinas con páginas de distinto tamaño.
Ninguno de los dos es una función para el usuario: son cimientos. el modo zoned arranca con limitaciones y el de subpágina llega en solo lectura. Lo importante es que el tree deja de suponer que una página es la unidad mínima y que un disco se puede escribir en cualquier orden.
El trabajo de subpágina es el más profundo: obliga a separar el tamaño de bloque del tamaño de página en la caché, y por eso llega en fases. El ciclo también trae mejoras de rendimiento: el cleaner no se bloquea en un mutex de un bloque borrado, el flushing preventivo separa su lógica de las reservas y el registro de inodos evita trabajo en dbench.
Los límites: el modo zoned y el de subpágina son cimientos, y el segundo llega en solo lectura; sin un dispositivo zoned no hay nada que probar. La documentación de Btrfs describe el estado.
7. Abrir un fichero sin bloquear y escribir en NFS sin esperar
Dos cambios para quien hace E/S desde el kernel. El primero es LOOKUP_CACHED y RESOLVE_CACHED: una búsqueda de ruta que solo usa la caché y devuelve un error si necesita leer del disco. Lo necesita io_uring, que no puede bloquear a un worker, y también está disponible en openat2() mediante RESOLVE_CACHED.
El segundo es el modo de escritura eager en NFS: con writes=eager, el cliente manda la escritura al servidor de inmediato en vez de acumularla, y con writes=wait espera la respuesta. El valor por defecto sigue siendo writes=lazy.
El primero evita bloqueos; el segundo hace visibles los errores: con escrituras perezosas, un ENOSPC en el servidor puede aparecer mucho después del write() que lo provocó, y la aplicación ya no sabe qué hacer.
Los límites: RESOLVE_CACHED falla a propósito si hay que ir a disco, así que quien llama debe tener un camino lento; y writes=eager no convierte NFS en un sistema de ficheros local. La documentación de NFS recoge las opciones.
8. NAPI en hilos y presupuesto térmico
La encuesta NAPI de las tarjetas de red corría en contexto de softirq, donde el scheduler no la ve y no se puede priorizar. En 5.12 se puede mover a hilos del kernel, uno por cola, con lo que aparecen en ps, se les puede dar afinidad y compiten por CPU como cualquier tarea.
El otro cambio es el framework DTPM para la gestión dinámica de potencia térmica: los SoC modernos tienen más de veinte sensores y un daemon de espacio de usuario reparte un presupuesto de vatios para no pasar de unos 45 °C de temperatura superficial. DTPM da al kernel una forma común de aplicar ese presupuesto a cada dispositivo.
El NAPI en hilos se activa por dispositivo y por cola, y se puede combinar con la encuesta clásica en las colas que no interesan. Las dos piezas trasladan trabajo al scheduler: una saca la red del softirq, la otra convierte la térmica en un reparto de potencia. Los límites: el NAPI en hilos añade latencia si hay muchos hilos y pocas colas, y DTPM solo es útil si la plataforma declara sus sensores. La documentación de NAPI describe el modelo.
9. Hardware y arquitecturas
El ciclo es variado. En x86 llega el soporte de PMU para Sapphire Rapids y la tabla de páginas genérica del IOMMU de AMD; los portátiles Surface suman el módulo agregador, y Hyper-V permite arrancar Linux como partición raíz.
En RISC-V entran kprobes, uprobes, fentry e inyección de errores, además de NUMA y KASAN en vmalloc. En MIPS llega la máquina Nintendo 64 y el soporte de los SoC Realtek RTL838x y RTL839x, que son switches.
La retirada de C6x no es capricho: la arquitectura se añadió en 2011 para unos DSP de Texas Instruments que nunca llegaron en volumen, y mantenerla costaba cambios en el core. El soporte de MIPS para la Nintendo 64 incluye el cartucho como dispositivo de bloque y el audio, dos piezas que solo tienen sentido en un emulador o en una consola restaurada. También se borra: se retira la arquitectura C6x entera y el mecanismo de perfilado oprofile.
Los límites: el hardware nuevo necesita firmware y una distribución con 5.12 o posterior; el soporte de N64 es para emuladores y coleccionistas. La documentación de x86 recoge las plataformas.
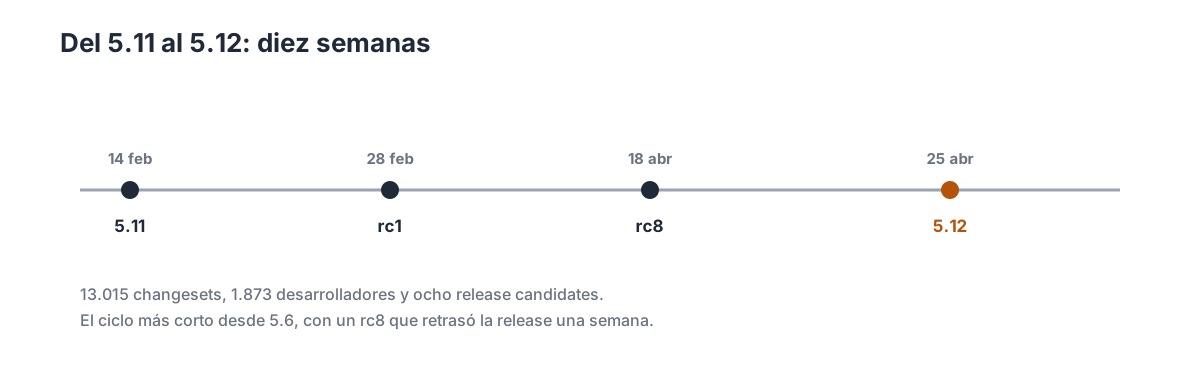
Diez semanas de ciclo, con ocho release candidates y una semana extra al final.
10. Por subsistemas
10.1 Core y herramientas
fw_devlink pasa a estar activo por defecto: el kernel crea enlaces entre dispositivos a partir del firmware y reduce los sondeos diferidos. fs-verity gana una ioctl para leer sus metadatos, y el scheduler ajusta el reparto de carga.
10.2 Sistemas de ficheros
XFS acelera el fsync de ficheros reduciendo el ciclo del iolock, y Btrfs mejora el flushing preventivo. El bloque estrena el límite zone_write_granularity para dispositivos por zonas.
10.3 Memoria
KASAN mejora su modo de etiquetas por hardware, stackdepot permite configurar el tamaño de la tabla y la búsqueda de páginas múltiples se reescribe pensando en THP. Las páginas CMA se cuentan por zona.
10.4 Bloque
El keyslot-manager gana soporte para device mapper, los schedulers no-mq mejoran con varias colas y virtio-blk permite profundidad de cola por dispositivo.
10.5 Traza, perf y BPF
BPF añade operaciones atómicas al conjunto de instrucciones y permite engancharse a tracepoints vacíos. El ring buffer se puede usar en programas que duermen y se puede reescribir el puerto de origen bajo ip_unprivileged_port_start.
10.6 Virtualización
KVM permite operaciones de MMU en paralelo con TDP y llega la herramienta de gestión de vDPA. virtio-input gana multitáctil y virtio permite configurar el despertar.
10.7 Redes
La pila añade notificaciones de fallo de offload de rutas, permite métrica en la ruta por defecto de IPv6 y acepta timestamps en el receive de TCP zerocopy.
10.8 Seguridad
SELinux aprende a etiquetar inodos anónimos y userfaultfd, el TPM 2 expone sus registros PCR por sysfs e IMA puede medir datos críticos del kernel. Se retiran cifrados y hashes que ya nadie usa, como Salsa20 y RIPE-MD.
11. Lo que no llega
idmapped mounts no cubre todos los sistemas de ficheros: NFS, overlayfs y ecryptfs no se pueden montar encima, y hay sistemas que aún no lo implementan. Tampoco cambia los permisos, solo la identidad con la que se ven.
KFENCE muestrea y por eso puede no ver un error; no sustituye a KASAN ni a las pruebas. LTO solo funciona con Clang y alarga el build. Btrfs zoned y subpágina son cimientos con modo de solo lectura en el segundo.
El ciclo tampoco trae un cambio de formato: ext4, XFS y Btrfs siguen leyendo los mismos discos, y las opciones nuevas son opcionales. Y 5.12 no es LTS: la LTS sigue siendo 5.10 hasta que 5.15 tome el relevo en octubre, según el calendario de kernel.org.
12. Cambios menores
Core
- io_uring — reciclaje de peticiones.
- io_uring memcg — bajo protección de memoria.
- inotify — instancias contadas en
kmemcg. - memcg — estadística de swapcache en la v2.
Ficheros
- Btrfs logging — menos trabajo al registrar inodos.
- Btrfs cleaner — sin bloqueos largos.
- keyslot-manager — paso directo para device mapper.
Bloque y memoria
Networking
13. Qué viene después
La merge window de 5.13 se abre el 26 de abril y cierra el 9 de mayo. Ese ciclo traerá Landlock, Clang CFI, la pila aleatoria por syscall y el arranque en el Apple M1, según el inventario de KernelNewbies; Linux 5.13 sale el 27 de junio.
Para las distribuciones, 5.12 es la base de Fedora 34 y de Ubuntu 21.04, que llegan con idmapped mounts y KFENCE. Las rolling la adoptan en semanas. La LTS sigue siendo 5.10.
Las próximas releases mostrarán si idmapped mounts se usa en contenedores de verdad, si KFENCE encuentra errores en producción y si LTO se queda como opción o pasa a ser el modo normal de compilar.
14. Referencias
- KernelNewbies: Linux 5.12 — inventario completo por subsistema.
- ChangeLog-5.12 — la lista completa de commits.
- LWN: The 5.12 kernel has been released — el anuncio y los comentarios.
- LWN: ID mapping for mounted filesystems — el diseño de idmapped mounts.
- LWN: NAPI polling in kernel threads — el NAPI con hilos.
- Phoronix: Linux 5.12 features — repaso de las novedades.
- kernel.org: releases — calendario y LTS.