Linux 5.14: memoria secreta, core scheduling y GPUs
memfd_secret crea memoria que el kernel no puede leer, core scheduling reparte los SMT y las GPU de AMD e Intel suman soporte. 14.709 changesets.
Linux 5.14 se ha publicado hoy, 29 de agosto de 2021, con memfd_secret() para crear memoria que el kernel no puede leer, core scheduling para repartir los hilos de un SMT y soporte para las GPU de AMD e Intel que estaban a punto de salir. El ciclo suma 14.709 changesets y 1.935 autores, y sale después de siete release candidates.
Torvalds cerró el ciclo pensando ya en el siguiente, y la release sale el domingo 29 de agosto de 2021, diez semanas después de Linux 5.13 y dentro de la serie 5.x; la merge window de 5.15 se abre al día siguiente.
Las cifras de este post se cuentan sobre el ChangeLog de kernel.org: 15.871 commits, de los que 1.162 son merges, y 1.935 autores distintos. Es un ciclo medio-alto, con más trabajo que 5.12 y menos que 5.13.
Hay tres claves. La primera es la seguridad: la memoria secreta sale del mapa del kernel y se puede usar para guardar claves. La segunda es el scheduler: core scheduling permite que dos hilos que no se llevan bien no compartan un núcleo SMT. La tercera es el hardware: las GPU nuevas de AMD e Intel llegan con soporte desde el primer día.
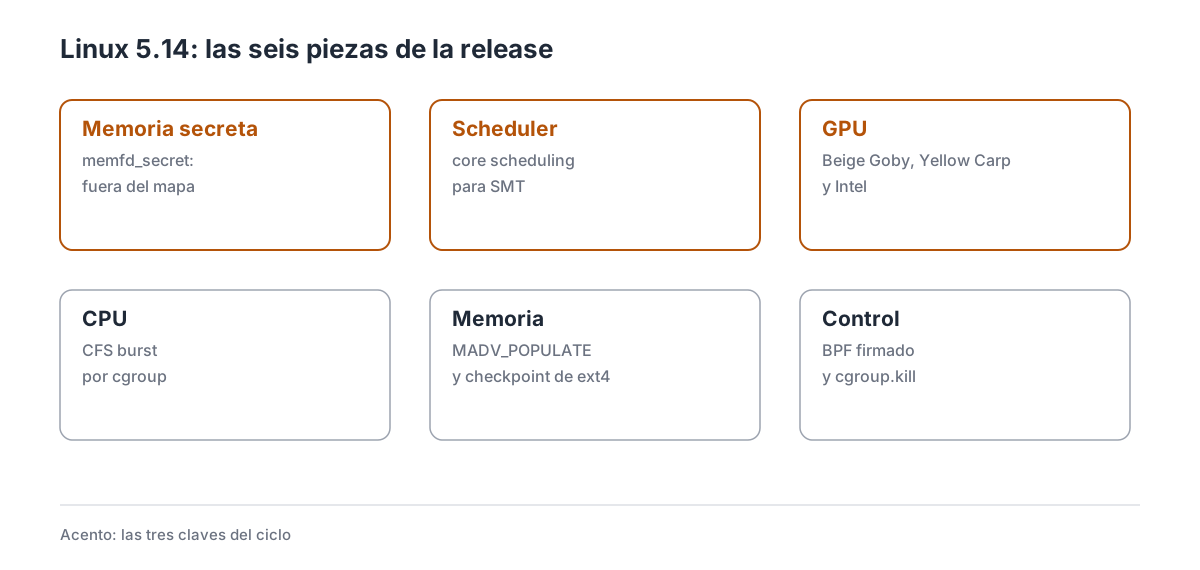
Las seis piezas que explican el ciclo, con las tres claves marcadas en ámbar.
1. Las cifras de un ciclo medio
| Dato | Valor |
|---|---|
| Fecha de release | 29 de agosto de 2021 |
| Versión anterior | 5.13 (27 de junio de 2021) |
| Merge window | 28 de junio al 11 de julio de 2021 |
| Release candidates | 7 |
| Changesets | 14.709 |
| Commits totales | 15.871 |
| Autores | 1.935 |
El ciclo crece respecto a 5.12 y se queda por debajo de 5.13, el más grande de la serie hasta ese momento. La merge window cayó en verano y el árbol se estabilizó en siete release candidates, sin sobresaltos.
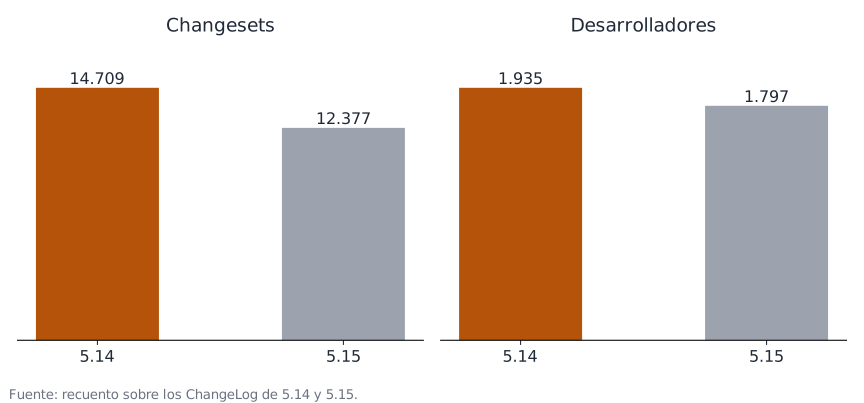
El ciclo de 5.14 comparado con 5.15, con el mismo método de recuento.
El ciclo también cierra la transición a la nueva API de montaje en varios sistemas de ficheros y retira drivers que ya nadie usa, como el raw o el IDE antiguo; esa limpieza compensa parte del crecimiento. El código de drivers es lo que más crece: las GPU nuevas y los SoC de ARM explican buena parte de las 14.000 changesets, y el núcleo del kernel cambia menos que en ciclos anteriores.
2. memfd_secret: memoria que el kernel no ve
Los enclaves de Intel y las memorias cifradas de AMD ya protegían la memoria del invitado frente al host; memfd_secret lo hace dentro de un mismo kernel, sin hardware especial. Con esto, Linux gana una capa más en la defensa contra volcados y herramientas de diagnóstico que leen la memoria del sistema. memfd_secret() crea un descriptor de memoria anónima cuyas páginas se sacan del mapa directo del kernel. El kernel no puede leerlas ni escribirlas, y solo el proceso que las mapea tiene acceso. Es la respuesta de Linux a las técnicas que buscan claves y contraseñas en la memoria del sistema.
La llamada entra en 5.14 con un requisito: hay que montar secretmem y tener privilegios para crear el descriptor. Una vez creado, el proceso puede mapear la memoria, escribir una clave y cerrar el descriptor; las páginas quedan fuera del alcance del kernel.
El descriptor se puede sellar y heredar, y las páginas no aparecen en /proc/pid/maps con una ruta legible; el proceso las mapea con mmap() y las usa como memoria normal. La ventaja aparece frente a volcados y ataques con acceso al kernel: si un atacante consigue leer memoria del kernel, no encuentra ahí las claves. La contrapartida es el coste: cada página secreta ocupa memoria que no se puede migrar ni usar para la caché, y el mapeo tiene limitaciones.
El coste está en la flexibilidad: la memoria secreta no se puede compartir con un dispositivo, ni migrar entre nodos, ni usar para la caché de página. Es una herramienta para secretos pequeños y de vida corta, no para datos de trabajo. El montaje de secretmem es un requisito de seguridad: sin él, la llamada devuelve un error, así que una distribución puede decidir no ofrecerla. Los límites: memfd_secret no protege contra un atacante con acceso al proceso, ni contra un hardware comprometido; y no sirve para memoria compartida con dispositivos. La documentación de memoria secreta describe el modelo.
3. Core scheduling: dos hilos, un núcleo
Un núcleo con SMT (hyperthreading) ejecuta dos hilos a la vez, y esos hilos comparten unidades de ejecución. Si dos procesos de confianza distinta comparten un núcleo, uno puede espiar al otro con ataques de canal lateral, como demostraron varias variantes de Spectre.
La API es pequeña: un prctl para fijar la cookie del hilo y otra para consultarla, y el scheduler hace el resto. La mitigación cuesta utilización: si dos hilos no pueden compartir núcleo, el scheduler deja un hermano SMT libre aunque haya trabajo. Por eso core scheduling se activa por proceso y no por defecto. Core scheduling permite etiquetar procesos con un «cookie» y decirle al scheduler que solo comparta un núcleo SMT entre hilos de la misma cookie. El usuario lo activa con prctl(PR_SCHED_CORE) y el scheduler lo respeta al repartir.
El mecanismo también sirve para los invitados de nube: el hipervisor puede asignar cookies distintas a clientes distintos y evitar que compartan núcleo. El caso de uso son los servidores con clientes de confianza distinta y los navegadores, que ya aíslan pestañas en procesos. La contrapartida es el rendimiento: si dos hilos no pueden compartir núcleo, se pierde parte del SMT, y en cargas con pocos procesos el coste se nota.
En un servidor de nube, el proveedor puede activar core scheduling para sus clientes sin que la aplicación cambie, siempre que el hipervisor lo propague. Los límites: core scheduling no arregla Spectre, solo reduce la superficie; y su activación requiere que la aplicación coopere. La documentación del scheduler describe la API.
4. GPUs nuevas de AMD e Intel
El trabajo de gráficos no es solo añadir IDs: cada GPU nueva trae firmware, tablas de relojes y rutas de display propias, y el driver tiene que reconocerlas sin romper las anteriores. El ciclo llega con soporte para las GPU que AMD e Intel presentaron en 2021: Beige Goby y Yellow Carp en AMD, y el soporte de LMEM para DG1. El kernel reconoce las tarjetas antes de que lleguen a las tiendas, y los drivers cubren display y parte de cálculo.
En AMD, Beige Goby y Yellow Carp son las GPU de gama media de 2021; en Intel, el soporte de LMEM permite que DG1 use su memoria local. El patrón es el de siempre: el kernel admite el hardware antes de que exista, y las distribuciones tardan meses en tener la versión que lo usa. La contrapartida es que el soporte inicial no cubre todo: faltan frecuencias, aceleración de vídeo y algunas funciones de cálculo.
Los límites: quien compre la GPU el día del lanzamiento necesitará un kernel reciente y firmware actualizado. La documentación de DRM describe el modelo.
5. CFS burst: más CPU cuando hace falta
El controlador de ancho de banda de CFS limita la CPU de un cgroup a una cuota por periodo. Hasta ahora, un grupo que no usaba su cuota la perdía; con CFS burst, el grupo puede acumular parte del presupuesto no usado y gastarlo en un pico.
El burst se configura con cpu.max.burst y se mide en microsegundos de CPU: el grupo puede gastar hasta ese extra cuando tiene trabajo acumulado. El burst también ayuda a los escritorios con muchos servicios: un contenedor de compilación puede usar más CPU cuando el resto está en reposo, sin cambiar su cuota nominal. El mecanismo encaja con los presupuestos de CPU de Kubernetes: un limit bajo con burst alto deja que el servicio responda a picos sin cambiar la cuota base. El caso de uso son los contenedores con cuota ajustada: un servicio que normalmente usa poco puede responder a un pico sin esperar al siguiente periodo. La contrapartida es que el burst no es ilimitado y que el reparto entre grupos cambia.
El burst se mide en microsegundos y su valor por defecto es cero, así que nada cambia si no se configura. El ajuste se hace por cgroup y se puede cambiar en caliente, así que un orquestador puede subir el burst antes de un pico previsto. Los límites: el burst no crea CPU de la nada y no sustituye a ajustar la cuota. La documentación de cgroups describe los ficheros.
6. MADV_POPULATE y el checkpoint de ext4
En un servidor de trading o en un sistema de control, la diferencia entre un acceso con fallo de página y otro sin él puede ser la diferencia entre cumplir el plazo o no. Las dos llamadas se pensaron para reducir la varianza de latencia: un fallo de página en el momento equivocado arruina un bucle de tiempo real, y un journal a medias arruina un backup. Dos mejoras para el espacio de usuario. La primera son MADV_POPULATE_READ y MADV_POPULATE_WRITE: permiten pedir al kernel que rellene las tablas de páginas de un rango antes de usarlo, con lo que el primer acceso no provoca un fallo de página. Es útil en aplicaciones realtime y en bases de datos.
La segunda es el checkpoint de ext4: un ioctl que fuerza la escritura del journal y deja el sistema de ficheros en un estado consistente. Sirve antes de una instantánea o de un backup, para no copiar un journal a medias.
En bases de datos, MADV_POPULATE_WRITE evita que el primer INSERT pague los fallos de página; en backups, el checkpoint de ext4 garantiza que la copia del journal es coherente. Las dos piezas son de control: una prepara la memoria, la otra el disco. Los límites: MADV_POPULATE puede fallar si no hay memoria, y el checkpoint de ext4 no sustituye a fsync por fichero.
7. BPF firmado y cgroup kill
BPF da sus primeros pasos hacia los programas firmados: el cargador puede verificar la firma de un programa antes de cargarlo, con lo que un sistema con lockdown puede rechazar código no firmado. También llegan el programa de syscall, el array de descriptores y el esqueleto ligero de libbpf.
En cgroups, el interfaz de kill permite matar todos los procesos de un grupo de una vez, sin recorrer el árbol desde el espacio de usuario. Es lo que necesita un orquestador para limpiar un contenedor.
El programa de syscall permite filtrar llamadas sin seccomp y el array de descriptores simplifica el paso de ficheros a un programa BPF. Las dos piezas son de control: una decide qué código se ejecuta, la otra qué procesos viven. Los límites: la firma de BPF necesita claves y una política, y el kill de cgroup no espera a que los procesos terminen.
8. Hardware: lo que llega y lo que se va
El ciclo es generoso en hardware. En portátiles, Intel añade los IDs de Alder Lake-M y el driver intel_lpss reconoce la plataforma, mientras AMD suma más IDs de PMC para sus portátiles. En almacenamiento, NVMe over Fabrics admite dispositivos por zonas y llega el driver efct para las tarjetas Fibre Channel de Broadcom.
En red, Mellanox añade el driver de la BlueField Gigabit Ethernet, y NCSI incorpora comandos OEM de Intel para mantener el enlace del PHY. Son drivers que no cambian la vida al usuario general, pero que hacen que un servidor nuevo arranque con todas sus piezas.
También hay retiradas: se van el driver raw, el IDE antiguo, em86 y varios sensores y reguladores que ya nadie fabrica. La limpieza es parte del ciclo: menos código que compilar y menos superficies que mantener.
Los límites: el hardware nuevo necesita firmware actualizado y, en muchos casos, una distribución con el kernel de 5.14 o posterior. La documentación de drivers recoge el modelo.
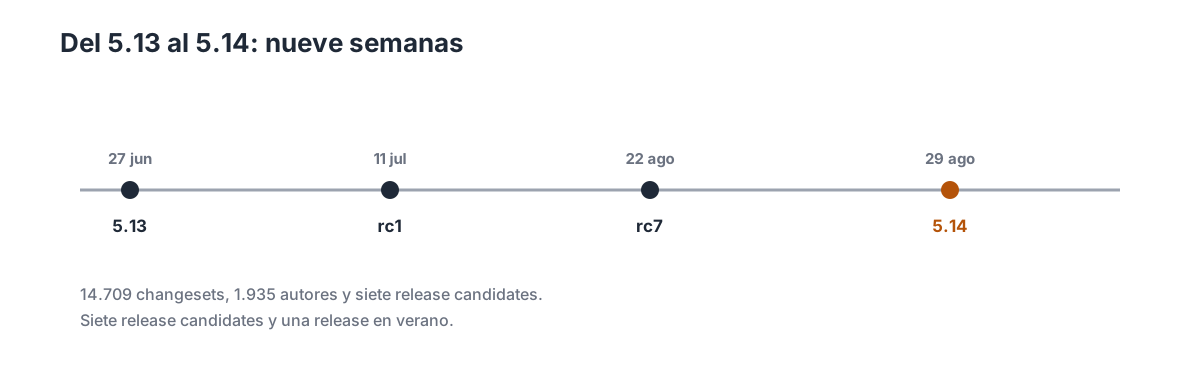
Nueve semanas de ciclo, con siete release candidates y una release en verano.
9. Por subsistemas
9.1 Core y herramientas
El ciclo también limpia la API de montaje con nosymfollow y mejora la información de fdinfo. cgroup.kill permite matar todos los procesos de un cgroup con una escritura, y futex añade FUTEX_LOCK_PI2 para no arrastrar el flag de reloj. Llega quotactl_fd() y se retira el driver raw, obsoleto desde hace años.
9.2 Sistemas de ficheros
El checkpoint de ext4 y el contador de errores completan el trabajo de ficheros. Btrfs permite limitar el ancho de banda del scrub y cancelar un resize o el borrado de un dispositivo. Acelera el registro de xattrs en fsync y el truncado que no toca extents.
9.3 Memoria
La memoria secreta convive con el resto de la gestión de memoria sin cambiar las políticas. Los RLIMIT se atan a un usuario en su namespace, KASAN identifica mejor la corrupción con tags y la contabilidad de kmem_cache cuesta menos. La página por CPU admite órdenes altas.
9.4 Bloque
El bloque también mejora la prioridad de E/S y el comportamiento de dm en dispositivos por zonas. El bloque permite configurar la prioridad de E/S por cgroup, BFQ mejora su control y rendimiento y el I/O del loop se carga al cgroup emisor. dm-btree mejora su residencia en caché.
9.5 Networking
La pila de red suma soporte para VSOCK con SOCK_SEQPACKET y para VF de confianza. TCP añade estadísticas de migración de socket y desactiva por defecto la lógica de TFO blackhole. Llega SRv6 End.DT46 y xdp_redirect_map admite broadcast.
9.6 Arquitecturas
x86 también estrena el driver intel_skl_int3472 para sensores y cámaras en portátiles. ARM64 recibe la Raspberry Pi 400, el Rockchip RK3568 y la plataforma automotriz SA8155p, además de la Surface Duo. x86 gana el driver intel_skl_int3472 y más piezas de AMD PMC.
9.7 Drivers y plataformas
El driver simpledrm sustituye a simplefb y funciona con el framebuffer que deja el firmware. Entra simpledrm, un driver para framebuffers simples, y AMD PMC puede registrar métricas de la SMU. Se retira el driver IDE antiguo, y CXL avanza con la enumeración de puertos y decodificadores.
10. Lo que no llega
La release tampoco es un cambio de modelo: las interfaces siguen donde estaban y no hay migraciones de formato. memfd_secret necesita privilegios y no cubre todo: no protege contra un atacante dentro del proceso y no se puede compartir con dispositivos. Core scheduling pierde rendimiento cuando se activa y requiere que la aplicación lo pida.
El soporte de GPU nuevas es inicial: falta aceleración de vídeo y funciones de cálculo. CFS burst no crea CPU. Y 5.14 no es LTS: la LTS es 5.10 hasta que 5.15 tome el relevo en octubre. Quien necesite una LTS tiene que esperar dos meses.
11. Cambios menores
Core
- idle aging — decaimiento del tiempo de reposo.
- capacidad asimétrica — detección reescrita.
- delayacct — desactivado por defecto.
nosymfollow— opción de montaje.- seccomp addfd — modo atómico.
- build ID — en las trazas de pila.
Memoria
- KCSAN valores — cambios observados.
- KUnit QEMU — soporte de máquina virtual.
- jump labels — tamaño variable.
Ficheros
- em86 fuera — se retira el binario de Alpha.
Herramientas y red
- perf annotate — opciones de traza.
- perf hybrid — topología híbrida.
- Bluetooth Lite-On — nuevo chip.
12. Qué viene después
La merge window de 5.15 se abre el 30 de agosto y cierra el 12 de septiembre. Ese ciclo traerá NTFS3, ksmbd, DAMON y la LTS de 2021; Linux 5.15 sale el 31 de octubre.
Para las distribuciones, 5.14 es la release del verano: Ubuntu 21.10 y Fedora 35 la adoptan, y las rolling la tienen en semanas. La LTS sigue siendo 5.10 hasta que 5.15 tome el relevo.
Las próximas releases mostrarán si memfd_secret se usa en navegadores y gestores de claves y si core scheduling convence a los proveedores de nube.
13. Referencias
- KernelNewbies: Linux 5.14 — inventario completo por subsistema.
- ChangeLog-5.14 — la lista completa de commits.
- LWN: The 5.14 kernel has been released — el anuncio.
- Phoronix: Linux 5.14 features — repaso de las novedades.
- kernel.org: releases — calendario y LTS.