Linux 5.15: NTFS3, ksmbd y un kernel con -Werror
El kernel estrena driver NTFS, servidor SMB en el árbol y DAMON para medir memoria. 12.377 changesets y un ciclo que arrancó con avisos de compilación.
Linux 5.15 se ha publicado hoy, 31 de octubre de 2021, con el nuevo driver NTFS3, un servidor SMB 3 dentro del kernel y DAMON para medir el acceso a memoria. El ciclo suma 12.377 changesets y 1.797 desarrolladores, y llega con nombre de Halloween: «Trick or Treat». Es la LTS de la serie 5.x.
Torvalds lo contó así: «This release may have started out with some -Werror pain, but it calmed down fairly quickly and on the whole 5.15 was fairly small and calm», según LWN. La release sale el domingo 31 de octubre de 2021, nueve semanas después de Linux 5.14 y dentro de la serie 5.x; la merge window de 5.16 se abre al día siguiente.
El ciclo es de actividad baja: 12.377 changesets, 1.797 desarrolladores y 251 novatos, según las estadísticas de LWN. El kernel crece en 332.000 líneas netas, y la participación baja respecto a ciclos anteriores y el proyecto sigue igual: el trabajo se reparte entre los mismos maintainers de siempre.
Hay tres claves. La primera es el almacenamiento: NTFS3 y ksmbd meten en el kernel dos protocolos que antes estaban en espacio de usuario. La segunda es la memoria: DAMON mide accesos y process_mrelease() libera la memoria de un proceso moribundo. La tercera es realtime: las primitivas de bloqueo de PREEMPT_RT entran en el tree.
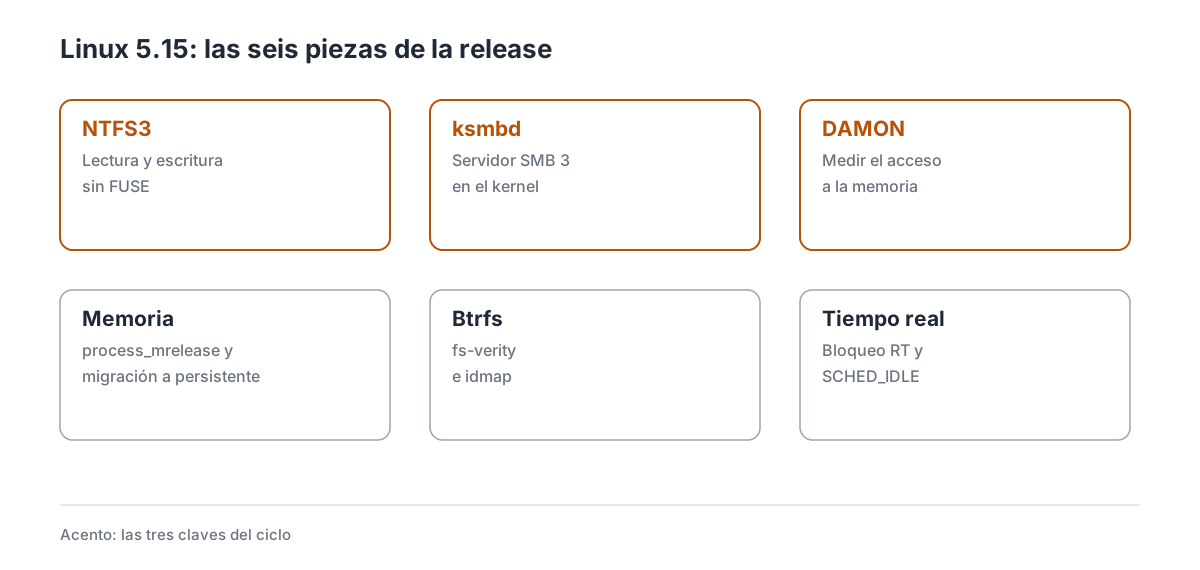
Las seis novedades del ciclo, con las tres claves marcadas en ámbar.
1. Las cifras de un ciclo con calma
| Dato | Valor |
|---|---|
| Fecha de release | 31 de octubre de 2021 |
| Versión anterior | 5.14 (29 de agosto de 2021) |
| Merge window | 30 de agosto al 12 de septiembre de 2021 |
| Release candidates | 7 |
| Changesets | 12.377 |
| Desarrolladores | 1.797 |
| Novatos | 251 |
El ciclo es de los más pequeños de la serie 5.x: 12.377 changesets, por debajo de los 14.190 de 5.16 y de los 13.000 habituales. La merge window cayó a finales de agosto, con medio proyecto de vacaciones, y el árbol se estabilizó en siete release candidates.
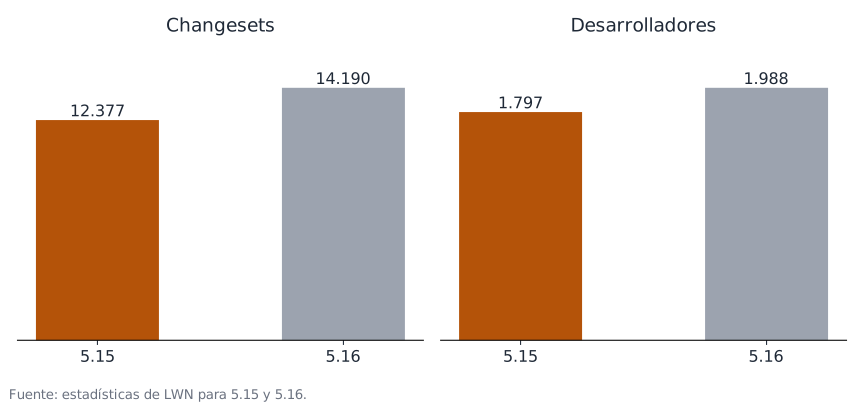
El ciclo de 5.15 comparado con 5.16, según las estadísticas de LWN.
La composición del ciclo también es conservadora: la mayor parte del trabajo son correcciones y drivers, con dos entradas grandes (NTFS3 y ksmbd) que explican buena parte del crecimiento. Lo que más crece son las líneas: 332.000 netas, un crecimiento moderado que refleja un ciclo de consolidación. NTFS3 añade bastante código, pero la retirada de drivers antiguos compensa parte.
2. NTFS3: el sistema de ficheros de Windows, dentro
NTFS es el sistema de ficheros de Windows y, hasta 5.15, Linux lo leía con ntfs-3g en espacio de usuario (FUSE) o con el driver antiguo, limitado y de solo lectura en la práctica. El nuevo NTFS3 entra en el kernel con lectura y escritura, y con el rendimiento de no pasar por FUSE.
El driver viene de Paragon Software, que lo mantenía fuera del tree, y su llegada fue una sorpresa para parte de la comunidad: un driver grande, con años de desarrollo comercial, que llega con maintainer propio y una base de código distinta al resto. La documentación de NTFS3 describe las opciones de montaje.
El driver implementa el registro de ficheros de NTFS, los flujos alternativos, los enlaces simbólicos y las compresiones más comunes.
Su código se apoya en el VFS y en el bloque, así que no necesita un demonio. El montaje es mount -t ntfs3 y las opciones incluyen uid, gid, umask y prealloc; el driver puede reproducir las compresiones y los flujos, pero no el cifrado EFS. El contexto ayuda a entender la entrada: ntfs-3g funciona, pero paga el coste de FUSE y su rendimiento con muchos ficheros pequeños es flojo; el driver antiguo del kernel solo escribía de forma experimental. NTFS3 llega con años de uso comercial en Windows y con rendimiento nativo. Quien comparte discos con Windows lo nota: un disco externo NTFS se monta con rendimiento nativo, sin instalar ntfs-3g ni pagar el coste de FUSE. La contrapartida es la confianza: un driver nuevo con escritura puede corromper datos si falla, y las pruebas de la comunidad tardaron en cubrir todos los casos.
Los límites: NTFS3 no implementa todas las funciones de NTFS (compresión, cifrado, cuotas) y compite con ntfs-3g, que sigue siendo la opción conservadora. La documentación de sistemas de ficheros recoge el estado.
3. ksmbd: un servidor SMB 3 en el kernel
El otro protocolo que entra es SMB. Hasta ahora, exportar ficheros por SMB desde Linux se hacía con Samba, un demonio de espacio de usuario; 5.15 añade ksmbd, un servidor SMB 3 implementado en el kernel, con soporte de SMB2 y SMB3, sesiones, leases y multichannel.
El objetivo es el rendimiento y la integración: como está en el kernel, ksmbd puede usar la caché de página y las estructuras del VFS sin copiar datos, y su configuración es más simple que la de Samba. La contrapartida es la superficie de ataque: un servidor de red dentro del kernel amplía lo que un fallo puede romper.
ksmbd se apoya en el mismo servidor de ficheros que Samba (smbd), pero sin el proceso de usuario: el kernel atiende las peticiones SMB y usa el VFS para leer y escribir. La configuración está en /etc/ksmbd y se gestiona con ksmbd.mountd, un pequeño demonio que habla con el kernel; el servidor en sí no abre puertos desde el kernel, lo hace el módulo a través de la pila de red. El módulo se puede cargar y descargar en caliente, y su espacio de nombres es independiente del de Samba: los dos pueden convivir en la misma máquina en puertos distintos. El código de ksmbd pasó por varias revisiones antes de entrar: se revisaron el manejo de sesiones, la validación de rutas y el soporte de leases, y se corrigieron fallos de seguridad en las release candidates. Ese trabajo explica por qué el driver llega con más de cien parches en su historia.
El debate rodeó al driver desde el principio: parte de la comunidad dudaba de que un servidor SMB deba vivir en el kernel, y Samba siguió siendo la opción recomendada para la mayoría. ksmbd se presenta como una alternativa para escenarios concretos, no como un sustituto.
Los límites: ksmbd no cubre todas las funciones de Samba (impresión, dominios, AD) y su seguridad se mira con detalle. La documentación de ksmbd describe la configuración.
4. DAMON: medir el acceso a la memoria
DAMON (Data Access Monitor) es un marco para medir qué páginas usa un proceso y con qué frecuencia, sin instrumentar la aplicación. El kernel muestrea las tablas de páginas y construye un mapa de accesos por región, que el espacio de usuario puede leer y usar para tomar decisiones.
En 5.15 entra la base de DAMON: el monitor, la interfaz de debugfs y los primeros algoritmos de muestreo. Las políticas (DAMOS) y el reclaim llegarán en 5.16, así que esta release es la infraestructura.
DAMON no necesita que la aplicación coopere: muestrea las tablas de páginas y deduce el acceso por la presencia de los bits de referencia. Ese detalle es lo que lo hace aplicable a cargas que no se pueden instrumentar. La interfaz de DAMON expone regiones, accesos y estadísticas por proceso, y el espacio de usuario puede leerlas con cat o con una biblioteca. En 5.15 no hay acciones automáticas: el monitor solo informa. El consumo de CPU del muestreo es ajustable, y por defecto es conservador: en un servidor con mucha memoria, el coste es bajo; en un móvil, se puede desactivar. DAMON también sirve para vigilar la memoria de un contenedor sin instrumentarlo: el monitor ve las regiones del proceso y puede decir qué parte de su working set está activa. Es una herramienta de análisis, no un sustituto de ps.
El caso de uso es la memoria por niveles: si el kernel sabe qué páginas se usan mucho y cuáles poco, puede mover las frías a memoria lenta y dejar las calientes en la rápida. DAMON es la pieza de medida que faltaba. La documentación de DAMON describe el modelo.
Los límites: el muestreo consume CPU y la interfaz es nueva; en 5.15 solo hay monitor, sin acciones automáticas.
5. process_mrelease: liberar la memoria de un proceso que muere
Cuando un proceso muere, el kernel libera su memoria, pero lo hace en el contexto del proceso que sale y puede tardar si hay mucha memoria o el sistema está ocupado. En un servidor con contenedores, eso deja memoria retenida mientras el exit termina.
process_mrelease(2) permite a otro proceso pedir que se libere la memoria de un proceso que ya está muerto, sin esperar a que termine su salida. El caso de uso es un orquestador que quiere recuperar la memoria de un contenedor cuanto antes.
La llamada se apoya en el pidfd, así que el proceso que la invoca tiene que haber abierto el descriptor del proceso objetivo, y el kernel comprueba que esté en estado de salida. La llamada devuelve un error si el proceso aún no ha muerto, y el kernel espera a que el exit esté en curso para liberar la memoria. El orquestador puede reintentar sin bloquear su propio hilo. El cambio es de latencia de recuperación: el OOM killer mata un proceso y la memoria se libera antes. La contrapartida es que hay que tener permisos sobre el proceso objetivo, y la API es nueva.
Los límites: process_mrelease() no sustituye al OOM killer ni arregla una fuga; solo acelera la liberación. La documentación de procesos recoge el contexto.
6. Migrar páginas a memoria persistente en lugar de descartarlas
La memoria persistente (Optane, CXL) es más lenta que la RAM pero más rápida que el disco, y guarda datos sin alimentación. El kernel puede usarla como swap o como extensión de memoria, y 5.15 añade la migración de páginas a memoria persistente en lugar de descartarlas.
La memoria persistente se presentó como el futuro del almacenamiento hace unos años y su adopción fue lenta: Optane desapareció y CXL llegó después. El código de 5.15 sigue siendo útil porque el modelo de niveles es el mismo, aunque el hardware haya cambiado. El cambio encaja con la memoria por niveles: en lugar de expulsar una página fría al disco, el kernel la mueve a un nivel más lento pero persistente, y la recupera con una falta de página normal. Es la base de lo que después se llamó demotion.
El kernel distingue entre memoria persistente y memoria normal con los nodos NUMA y las políticas de colocación; la migración usa el mismo camino que el resto de movimientos de página. El beneficio es la latencia de recuperación: una página en memoria persistente tarda microsegundos, no milisegundos. Los límites: necesita hardware con memoria persistente y una configuración explícita; en 2021 eso era un servidor de gama alta.
7. Btrfs: fs-verity y montajes con idmap
Btrfs añade fs-verity: un árbol de hashes por fichero que permite verificar cada bloque al leerlo, con la firma en el xattr. Es la base de las imágenes de solo lectura verificadas y de Android.
También admite montajes con idmap, con lo que un contenedor puede ver sus UIDs sin que el disco los guarde. Y suma correcciones de logging y de espacio libre.
El idmap de Btrfs se apoya en la infraestructura del VFS que llegó en 5.12, y el fs-verity usa el árbol de hashes de la capa genérica. El idmap de Btrfs permite que un contenedor con UIDs desplazados use instantáneas y reflinks sin romper los permisos, algo que antes obligaba a copiar. Las dos piezas apuntan a la integridad: fs-verity garantiza que el contenido no cambió, y el idmap garantiza que los permisos se ven como deben. Los límites: fs-verity es de solo lectura, y el idmap necesita que el sistema de ficheros lo soporte.
8. Tiempo real: las primitivas de bloqueo y SCHED_IDLE por cgroup
El trabajo de PREEMPT_RT avanza con la infraestructura de bloqueo: mutex con herencia de prioridad, semáforos y rtmutex que funcionan igual en un kernel normal y en uno con tiempo real. La idea es que el código sea el mismo y que la diferencia esté en la configuración.
Además, el scheduler añade soporte de cgroup para SCHED_IDLE: un grupo de tareas puede marcarse como «solo cuando no hay nada mejor», y el resto del sistema no compite con él. Es útil para trabajos de fondo y para contenedores de baja prioridad.
El trabajo de RT en 5.15 no cambia el comportamiento del kernel normal: las mismas primitivas se usan en los dos modos, y la diferencia está en si las secciones críticas se pueden dormir. El cambio es de aislamiento: las tareas realtime no se mezclan con las normales, y las de fondo no estorban. Los límites: PREEMPT_RT sigue fuera del tree en 5.15, y SCHED_IDLE no reserva CPU: si no hay otra carga, el grupo la usa.
9. DM IMA y afinidad asimétrica
Device Mapper gana mediciones con IMA: cada operación de un target puede registrarse en el log de integridad, con lo que un sistema de auditoría puede demostrar qué se escribió y cuándo. Es la base de la atestación remota de discos.
En el scheduler, la afinidad asimétrica permite que un proceso de 32 bits se ejecute en los núcleos que lo admiten dentro de una CPU heterogénea (por ejemplo, ARM big.LITTLE). Sin eso, el scheduler podía colocar la tarea en un núcleo que no podía ejecutarla.
La atestación de DM se integra con el sistema de mediciones de IMA, que ya se usaba para medir el arranque y los binarios; ahora también mide las operaciones de disco. En la práctica, la atestación de DM se usa en servidores con discos cifrados y políticas de integridad, no en un portátil; la afinidad asimétrica, al revés, es cosa de móviles y de placas ARM. Las dos piezas son de plataforma: una para auditar el almacenamiento, otra para que el scheduler entienda las CPU mixtas. Los límites: IMA necesita una política y claves; la afinidad asimétrica depende de que el firmware describa los núcleos.
10. El salseo: el ciclo que empezó con -Werror
El ciclo arrancó con dolor de compilación: el árbol activó -Werror para algunas configuraciones y los avisos del compilador se convirtieron en errores que rompían builds. Torvalds lo recordó en el anuncio: «this release may have started out with some -Werror pain».
El problema se arregló con prisas: se corrigieron los avisos y se relajó la política en los casos donde el compilador se equivocaba. No hubo pelea de maintainers, pero sí una lección: convertir un aviso en error solo funciona si el tree está limpio, y el árbol nunca lo está del todo.
El resto del ciclo fue con calma, con siete release candidates y una release puntual. El nombre «Trick or Treat» lo puso Torvalds por la fecha, no por el susto de los primeros días.
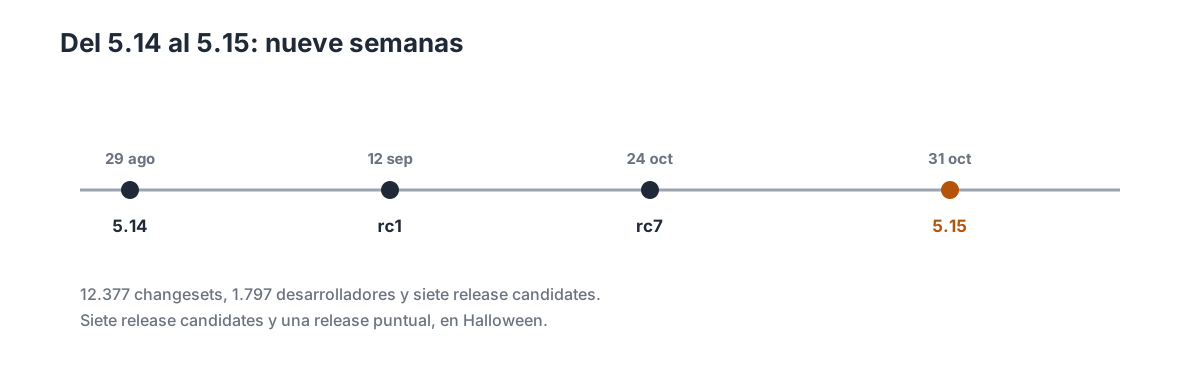
Nueve semanas de ciclo, con siete release candidates y una release en Halloween.
11. Por subsistemas
11.1 Core y herramientas
io_uring añade mkdir y linkat, el registro de descriptores existentes y el límite de trabajadores de io-wq. Los timeouts admiten CLOCK_BOOTTIME, y el mutex de tiempo real agrupa operaciones.
11.2 Sistemas de ficheros
XFS estrena la inactivación diferida de inodos, el pipelining de CIL y los atributos diferidos. Btrfs y F2FS suman correcciones, y el kernel retira NTLM y algoritmos débiles de CIFS.
11.3 Memoria
process_madvise() admite MADV_WILLNEED, el page pool gana páginas fragmentadas y SLUB se prepara para PREEMPT_RT. KCSAN añade el modo permisivo y las estadísticas de lruvec pasan a rstat.
11.4 Bloque
El bloque recicla bio para polling, mejora el throttling de IOPS y permite las ioctls de zonas sin CAP_SYS_ADMIN. Se retira el subsistema lightnvm.
11.5 Networking
El bonding añade XDP y lacp_active; el bridge gana MDB y contexto de host, y devlink controla dispositivos auxiliares. DSA puede descargar el forwarding de la bridge.
11.6 Virtualización
KVM expone histogramas lineales y logarítmicos, se añade una estadística de TLB remoto y VDUSE lleva vDPA a espacio de usuario. vfio_pci_core se separa como subsistema.
11.7 Arquitecturas y gráficos
AMD añade Cyan Skillfish, códecs para Yellow Carp y más IDs de RDNA2. Intel prepara Alder Lake y el kernel gana el driver DART de Apple M1.
11.8 Plataformas
Llegan virtio-gpio y virtio-i2c, el sensor térmico de Tegra30 y el driver de IOMMU de Apple. Los portátiles y placas SBC suman hardware nuevo.
12. Lo que no llega
NTFS3 y ksmbd son nuevos: el primero no cubre todas las funciones de NTFS y el segundo no sustituye a Samba. DAMON solo mide, sin actuar; el reclaim llega en 5.16. process_mrelease() necesita permisos y no arregla fugas.
La migración a memoria persistente necesita hardware y configuración, y el precio de Optane la hizo minoritaria. NTFS3 y ksmbd necesitan pruebas de la comunidad antes de que un administrador les confíe datos. PREEMPT_RT sigue fuera del tree, y la afinidad asimétrica depende del firmware. Y 5.15 es LTS, pero las distribuciones tardan meses en adoptarla: Ubuntu 22.04 la elige en abril y Debian 12 un año después, así que el usuario final la ve un año después.
13. Cambios menores
Core
- io_uring PAGE_SIZE — registro con páginas no de 4 KB.
- O_NONBLOCK — reintento si hay async.
- cpuset eventos — aviso de cambio de partición.
- GCC 5.1 — mínimo del compilador.
- módulos con EC — firmas con curva elíptica.
Ficheros
- XFS quotaoff — no puede desactivar la contabilidad.
- XFS feature flags — reescritura de los flags.
- XFS bigtime — se quitan los avisos de experimental.
Memoria
- KFENCE info — CPU y hora en cada asignación.
- kernfs locking — concurrencia mejorada.
Bloque y red
Virtualización
14. Qué viene después
La merge window de 5.16 se abre el 1 de noviembre y cierra el 14. Ese ciclo traerá futex_waitv(), folios, AMX y el scheduler de clústeres; Linux 5.16 sale el 9 de enero de 2022, y LWN cubrió la ventana de 5.15 en su primera parte.
Para las distribuciones, 5.15 es la LTS de 2021: Ubuntu 22.04, Debian 12 y las imágenes de servidor la usan durante años. Las rolling la adoptan en semanas, y las que congelan en primavera saltan a 5.17.
Las próximas releases mostrarán si NTFS3 y ksmbd se ganan la confianza de los usuarios y si DAMON se convierte en la base de la memoria por niveles. Tampoco hay fecha para que PREEMPT_RT entre del todo.
15. Referencias
- KernelNewbies: Linux 5.15 — inventario completo por subsistema.
- ChangeLog-5.15 — la lista completa de commits.
- Phoronix: Linux 5.15 features — repaso de las novedades del ciclo.
- kernel.org: releases — calendario y LTS.