Linux 5.16: futex_waitv, folios y AMX en el kernel
futex_waitv acelera los juegos en Wine, los folios cambian la memoria y AMX prepara las CPU Intel con matrices. 14.190 changesets y 1.988 desarrolladores.
Linux 5.16 se ha publicado hoy, 9 de enero de 2022, con futex_waitv() para esperar varios futex a la vez, la infraestructura de folios en la memoria y el soporte de AMX en las CPU Intel. El ciclo suma 14.190 changesets y 1.988 desarrolladores, el segundo mejor dato de la historia, y llega puntual tras ocho release candidates.
Torvalds cerró el ciclo sin sorpresas y con la vista puesta en el siguiente: la merge window de 5.17 se abrió al día siguiente. La release sale el domingo 9 de enero de 2022, diez semanas después de Linux 5.15 y dentro de la serie 5.x.
El ciclo es de actividad alta: 14.190 changesets, 1.988 desarrolladores y 296 novatos, según las estadísticas de LWN. Solo 5.13 tuvo más participantes, y el número de novatos está en la parte alta de la horquilla habitual. Los nombres más activos son los de siempre: maintainers de subsistemas con series grandes y refactorizaciones.
El ciclo también es el primero con la serie 5.x ya madura: no hay cambios de arquitectura de arranque ni migraciones de formato, y las distribuciones pueden adoptarlo sin dramas. Hay tres claves. La primera es la memoria: los folios dejan de ser un experimento y se convierten en la estructura sobre la que se construye el resto. La segunda es la CPU: AMX añade matrices al repertorio de instrucciones y el scheduler aprende a repartir tareas por clústeres. La tercera es la interoperabilidad: futex_waitv() reduce el coste de los juegos que se ejecutan sobre Wine y Proton.
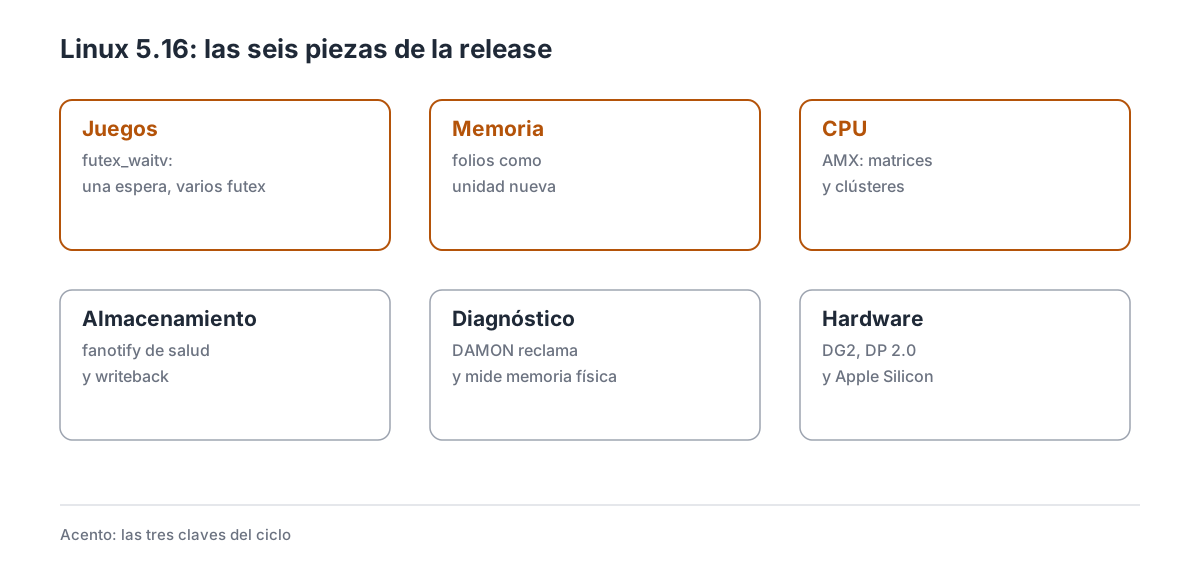
Las seis piezas que explican el ciclo, con las tres claves marcadas en ámbar.
1. Las cifras de un ciclo alto
| Dato | Valor |
|---|---|
| Fecha de release | 9 de enero de 2022 |
| Versión anterior | 5.15 (31 de octubre de 2021) |
| Merge window | 1 al 14 de noviembre de 2021 |
| Release candidates | 8 |
| Changesets | 14.190 |
| Desarrolladores | 1.988 |
| Novatos | 296 |
El ciclo vuelve a subir respecto a 5.15 (12.377 changesets) y se queda cerca de 5.13 en participación. La merge window cayó en noviembre, con el proyecto trabajando a ritmo normal, y las ocho rc bastaron para estabilizar un árbol con cambios profundos en memoria.
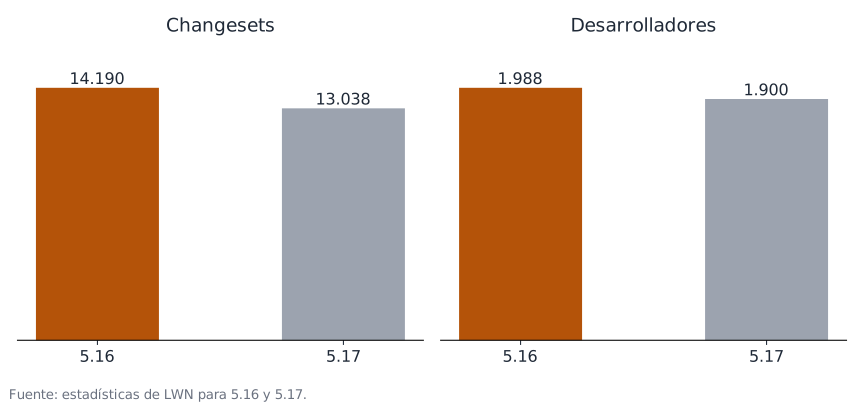
El ciclo de 5.16 comparado con 5.17, según las estadísticas de LWN.
El ciclo también confirma una tendencia: las releases impares de la serie 5.x son más grandes que las pares, porque caen después de una ventana de vacaciones o de un ciclo corto. En volumen, 5.16 es un ciclo medio-alto: más cambios que 5.15 y menos que 5.13, con una merge window que se abrió justo después de Halloween. Lo importante es que 5.16 mantiene la continuidad: 5.16 no trae un cambio de interfaz visible, pero sí la infraestructura que usarán las releases siguientes. Los folios y AMX son apuestas a largo plazo.
2. futex_waitv: esperar varios futex a la vez
Un futex es la primitiva con la que se construyen mutex, semáforos y variables de condición en espacio de usuario. El problema es que hay que esperar a cada futex por separado: un programa que necesita esperar a diez eventos tiene que hacer diez llamadas, o montar una estructura auxiliar.
futex_waitv() permite esperar a un array de futex y despertar cuando cualquiera de ellos cambia, con un solo syscall. El caso de uso más claro son los juegos de Windows sobre Wine y Proton: los emuladores de WaitForMultipleObjects necesitaban esperar a varios objetos y el coste se dejaba ver en el tiempo por fotograma.
La implementación reutiliza la maquinaria de futex existente: el array se copia al kernel, se valida y se encola en una lista de espera común. Cuando uno de los futex cambia, el kernel despierta al proceso y devuelve el índice del que lo hizo. El cambio se aprecia en la latencia, no en lo que hace el programa: el programa hace lo mismo, pero con menos viajes al kernel y menos CPU. La contrapartida es que la API es nueva y las aplicaciones tienen que adoptarla; en 5.16 la usan Wine y algunos runtimes, no todos.
Wine incorporó la llamada en su capa de sincronización, y las pruebas con juegos de Proton mostraron menos CPU en el hilo principal. Los límites: futex_waitv() no resuelve la prioridad inversa ni sustituye a una buena estructura de sincronización. La documentación de futex describe la interfaz.
3. Folios: la memoria cambia de unidad
Durante años, el kernel ha tratado la memoria como páginas de 4 KB. Cuando el hardware y las cargas pidieron bloques mayores, se añadieron «páginas compuestas» con reglas implícitas: la primera página es la cabeza, las demás son colas, y el código tiene que saber cuál es cuál. El resultado es un montón de comprobaciones que nadie recuerda.
Los folios son una estructura nueva que representa un bloque de memoria compuesto y garantiza que no es una página cola. Con eso, una función que recibe un folio sabe que puede tratar el bloque entero, y las conversiones dejan de depender de convenciones. La explicación de LWN sigue siendo la mejor introducción.
El folio no es un tipo opaco: es struct folio, con la misma cabecera que una página pero con la garantía de que representa el bloque entero. Las funciones que lo reciben pueden usar folio_order() y folio_size() sin comprobar si están en la cabeza o en la cola, y el compilador no deja pasar un struct page donde se espera un folio. La conversión no es superficial: cambia la firma de cientos de funciones y obliga a revisar cada uso de page en la caché y en los sistemas de ficheros. En 5.16 se hace la parte de infraestructura y se deja el resto para las releases siguientes. El cambio afecta al modelo de memoria, no al rendimiento inmediato: en 5.16 se convierte el código, no se activan folios grandes por defecto. El beneficio llega cuando el resto del kernel usa la nueva unidad y la caché de página puede trabajar con bloques mayores.
El cambio también prepara el terreno para folios grandes en la caché y para menos bloqueos en la asignación. Los límites: la conversión es enorme y convive con las páginas compuestas durante años; un folio mal usado puede romper la contabilidad. La documentación de memoria recoge el estado.
4. AMX: matrices en la CPU
Intel Advanced Matrix Extensions añade a x86 un bloque de registros para operar con matrices: ocho registros de 1 KB (tmm) y un conjunto de instrucciones para multiplicar y acumular. Es la base de las cargas de inteligencia artificial en CPU, y 5.16 añade el soporte del kernel.
El trabajo no está en las instrucciones, que ejecuta el programa, sino en el contexto: el estado de AMX ocupa unos 8 KB por hilo, y el kernel tiene que guardarlo y restaurarlo en cada cambio de contexto, en las señales y en los volcados. Por eso 5.16 incluye la optimización del frame de señal cuando el estado está en su valor inicial.
El kernel también tiene que decidir cuándo guardar el estado de AMX: si el hilo no lo usa, no se guarda; si lo usa, se guarda entero. Esa lógica se apoya en el soporte de estados extendidos de x86, que ya existía para AVX-512. El cambio prepara el hardware que estaba a punto de salir: Sapphire Rapids fue la primera CPU con AMX, y el kernel sale antes que las máquinas. La contrapartida es que el soporte de compiladores y bibliotecas tardó más: sin gcc/clang con intrínsecos y sin oneDNN actualizado, AMX no se usa.
En Linux, el estado de AMX se guarda con las mismas instrucciones que el resto de estados extendidos, así que el cambio no añade código de ensamblador específico. Los límites: AMX consume mucha potencia y compite con AVX-512 por el mismo espacio de estado; en portátiles no está. La documentación de x86 describe el modelo.
5. El scheduler descubre los clústeres
Los procesadores modernos agrupan núcleos en clústeres que comparten caché y dominio de frecuencia: los Apple M1 tienen clústeres de eficiencia y de rendimiento, y los Intel híbridos agrupan P-cores y E-cores. El scheduler trataba cada núcleo como una unidad suelta y no aprovechaba esa estructura.
5.16 expone la topología de clústeres y añade al scheduler la capacidad de repartir tareas dentro de un clúster antes de saltar a otro. Con eso, una tarea que migra se queda en el mismo dominio de caché, y el coste de la migración baja.
La topología de clústeres se expone en sysfs y en la información de depuración, de modo que las herramientas pueden verla sin adivinar. El clúster también sirve para las CPU con varios tipos de núcleo: el scheduler prefiere mover una tarea entre núcleos del mismo tipo antes que cruzar a otro. El efecto se aprecia en portátiles híbridos y en máquinas con clústeres heterogéneos: menos saltos entre tipos de núcleo y mejor uso de la caché compartida. El scheduler también aprende a no mover una tarea a un núcleo de otro tipo si la afinidad lo impide. Los límites: la información tiene que venir del firmware o del device tree, y en algunas plataformas es incompleta.
6. fanotify y la salud de los sistemas de ficheros
fanotify es el mecanismo con el que un programa de espacio de usuario recibe avisos de lo que pasa en un sistema de ficheros. Hasta ahora avisaba de accesos, aperturas y renombrados; 5.16 añade avisos de salud: errores de E/S, corrupción detectada y resultados de fsck.
Con eso, un demonio puede reaccionar a un fallo de disco sin esperar a que una aplicación falle: recibir el evento, marcar el sistema de ficheros como sospechoso y lanzar una comprobación. Es la pieza que faltaba para que el espacio de usuario pueda gestionar la salud del almacenamiento.
Los eventos de salud se pueden filtrar por tipo y por sistema de ficheros, y el consumidor recibe el identificador del montaje y el código de error. Con eso, un sistema de monitorización puede distinguir un error de disco de una corrupción lógica. La interfaz usa el mismo fanotify que ya conocen los antivirus, así que un consumidor existente puede suscribirse a los eventos nuevos con cambios pequeños. fanotify avisa de los problemas, pero no los repara: fanotify avisa, no arregla. La contrapartida es que hay que escribir el consumidor y que no todos los sistemas de ficheros emiten los mismos eventos.
El consumidor típico es un demonio de almacenamiento que ya monitoriza los discos y quiere enterarse antes que el dmesg. Los eventos de salud no sustituyen a smartctl: son la señal de que algo va mal, no el diagnóstico. Los límites: la interfaz necesita privilegios, y los eventos de salud son nuevos: las herramientas tardaron en adoptarlos. La documentación de fanotify describe el modelo.
7. DAMON aprende a reclamar y a medir memoria física
DAMON (Data Access Monitor) entró en 5.15 como un monitor: mide qué páginas usa cada región y con qué frecuencia. En 5.16 da el paso a la acción con el reclaim proactivo: un esquema puede decir «esta región se usa poco, libérala» y DAMON lo hace antes de que el sistema se quede sin memoria.
También llegan los esquemas de operación, que definen qué hacer con cada rango según su acceso, y la monitorización de memoria física, que permite vigilar direcciones de hardware en lugar de solo memoria virtual. Con eso, DAMON sirve para servidores con memoria por niveles y para máquinas con GPU o NPU.
Con la memoria física a la vista, un servidor con módulos CXL puede saber qué rangos se usan y con qué frecuencia, sin pasar por la traducción de direcciones. Los esquemas se definen en sysfs, con un rango de direcciones, un patrón de acceso y una acción; DAMON los evalúa periódicamente y aplica la que toca. La interfaz está pensada para que un demonio de espacio de usuario la configure. La configuración por sysfs sustituye al debugfs que se usaba en 5.15, y eso importa: debugfs no es estable ni está pensado para producción. Aquí el kernel aplica la política que declara el administrador: el administrador declara intenciones y DAMON las aplica con datos. La combinación con la memoria por niveles es la más prometedora: DAMON puede mover páginas frías a un nivel lento en lugar de expulsarlas. Los límites: mal configurado, puede enfriar páginas que sí se usaban; la interfaz aún es joven y su ajuste requiere pruebas.
8. Writeback: menos bloqueos cuando el disco no da abasto
El writeback vuelca a disco la memoria modificada, y cuando el dispositivo es lento la cola crece y las aplicaciones se bloquean. 5.16 mejora el throttling del writeback: el kernel mide mejor la velocidad del dispositivo y reparte las esperas entre los procesos que ensucian páginas, en lugar de bloquear al primero que llega.
La estimación de bandwidth se hace por dispositivo con una media móvil, y el kernel reparte las esperas entre los procesos que tienen páginas modificadas. En un disco USB lento, el resultado es que la copia grande no bloquea al editor. El cambio se apoya en los contadores de congestión que se retiraron y en una estimación de bandwidth por dispositivo. El reparto se hace por proceso: quien más ensucia, más espera, y el que solo escribe un poco no paga por el resto. Ese detalle es el que cambia la sensación de latencia en un escritorio. El efecto se ve en discos lentos y en sistemas con mucha escritura: menos picos de latencia y un reparto más equitativo.
El cambio se complementa con los controles por bdi que llegarán en releases posteriores. El trabajo se apoya en el modelo de congestión por bdi que el kernel ya tenía, y lo usa para decidir a quién frenar. Los límites: el throttling no arregla un disco que no da abasto; solo reparte la espera. La documentación de writeback explica los controles.
9. El salseo: los folios, una discusión de años
Los folios no llegaron de golpe: Matthew Wilcox los propuso hace un par de años como una forma de acabar con las reglas implícitas de las páginas compuestas, y la discusión se alargó durante años. Había quien los veía como un cambio demasiado grande y quien argumentaba que sin ellos la memoria seguiría siendo un laberinto.
El debate fue técnico y largo, con pruebas de rendimiento y conversaciones sobre el coste de mantener dos modelos. El debate también dejó claro que el problema no era solo técnico: cualquier cambio que toque la memoria afecta a todos los subsistemas, y los maintainers de sistemas de ficheros, bloque y virtualización tienen que aceptarlo a la vez. La conclusión fue que el kernel ya tenía páginas compuestas en todas partes, y que nombrarlas con una estructura nueva era mejor que seguir con convenciones. El debate dejó una lección de proceso: un cambio grande entra cuando el maintainer del área lo adopta, no cuando el autor lo defiende mejor. LWN lo siguió desde la primera propuesta, con pruebas de rendimiento y réplicas de los maintainers.
No hubo pelea personal ni episodio de CoC: el salseo del ciclo es el de una idea que tardó años en convencer. En 5.16 los folios entran en el tree, y las releases siguientes los extienden.
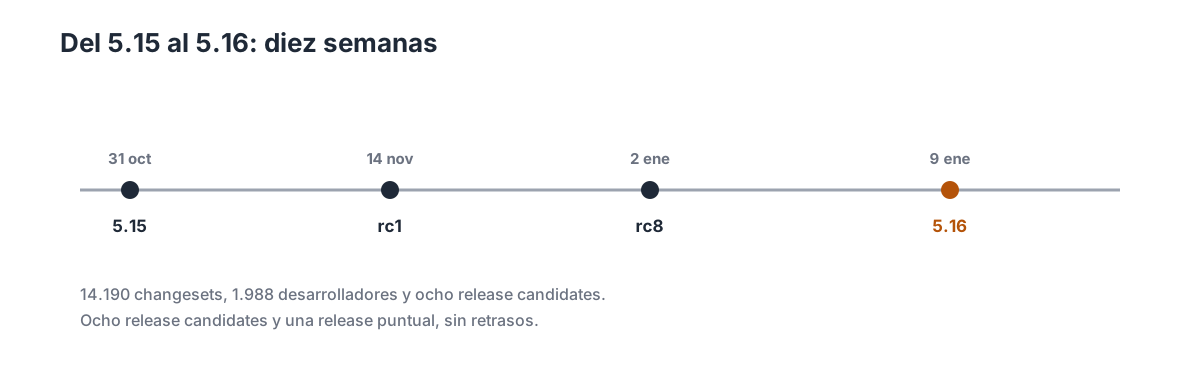
Diez semanas de ciclo, con ocho release candidates y una release puntual.
10. Por subsistemas
10.1 Core y herramientas
El ciclo también mejora el arranque: menos comprobaciones en el camino caliente y más información en fdinfo para depurar io_uring.
io_uring estrena el modo híbrido para peticiones con poll y expone más información en fdinfo. El scheduler añade estadísticas para RT y contabilidad de cfs_bandwidth, y el balanceo de newidle mejora su coste.
10.2 Sistemas de ficheros
Btrfs acumula optimizaciones de logging y prepara el protocolo send v2, que llegará en releases posteriores.
Btrfs mejora el checkpoint de fsync y el kernel retira el bloqueo obligatorio de ficheros. F2FS y Btrfs suman correcciones.
10.3 Memoria
La conversión a folios avanza por subsistemas y la contabilidad de memcg gana precisión en los límites.
La caché de página mantiene los inodos fuera de la LRU del shrinker, hugetlb admite la demotion de páginas y el arranque permite reservar CMA por nodo. memcg evita que las tareas moribundas excedan su límite.
10.4 Bloque
Los discos multi-actuador son la novedad de hardware del ciclo: dos brazos en un mismo disco, con el bloque repartiendo la E/S.
El bloque agrupa finalizaciones, admite discos multi-actuador y permite quiescing concurrente. Vuelve la prioridad de E/S en mq-deadline, y el polling pasa a un modelo basado en bio.
10.5 Networking
BPF sigue creciendo en herramientas de red: filtros de Bloom para búsquedas rápidas y llamadas a módulos desde programas.
Los mapas BPF estrenan filtros de Bloom, y el kernel puede llamar a funciones de módulos desde eBPF. Llegan bpf_get_branch_snapshot y el helper bpf_skc_to_unix_sock().
10.6 Virtualización
vDPA se consolida como la vía para exponer dispositivos virtuales con aceleración del host.
vDPA permite configurar MAC y MTU y estrena el driver de Alibaba ENI; virtio-mem añade memoria no accesible y ACRN expone interfaces HSM.
10.7 Arquitecturas
ARM64 suma placas de móvil y de desarrollo; x86 prepara Raptor Lake y limpia la lógica de mitigaciones.
ARM64 recibe el Fairphone 4, el Sony Xperia 10 III y los Qualcomm SM6350. En x86 llegan los Vortex y Raptor Lake, y se reescribe la lógica del retpoline.
10.8 Gráficos y plataformas
AMD e Intel preparan el hardware de 2022, y Apple Silicon gana piezas para que los portátiles funcionen mejor.
AMD añade DP 2.0 y el túnel de DisplayPort sobre USB4; Intel prepara DG2 y habilita GuC por defecto en DG1. Apple Silicon gana el driver de pinctrl y el kernel suma el sensor de CO2 SCD4x.
11. Lo que no llega
Los folios están, pero no se usan a plena capacidad: la conversión es progresiva y los folios grandes no se activan por defecto. AMX necesita hardware Sapphire Rapids y compiladores que lo emitan. El scheduler de clústeres depende de que la topología llegue bien descrita.
futex_waitv() necesita que las aplicaciones lo adopten, y fanotify de salud requiere un consumidor y privilegios. El writeback mejora el reparto, no la velocidad del disco. Y 5.16 no es LTS: la LTS es 5.15, que se mantiene durante años y recibe las correcciones de seguridad mientras las distribuciones la siguen usando.
12. Cambios menores
Core
- nohz balance — CPUs que acaban de quedarse libres.
- idle accounting — contabilidad de reposo.
- might_sleep RT — la comprobación entiende PREEMPT_RT.
- preempt dinámico — Kconfig para el modo por defecto.
- SMT asimétrico — balanceo con ASYM_PACKING.
- PR_SCHED_CORE — piezas de UAPI que faltaban.
Ficheros
- Btrfs zoned — soporte de namespaces por zonas.
- Btrfs inode logging — menos latencia.
- Btrfs directorios — logging más eficiente.
- Btrfs subpage — escritura comprimida.
- Btrfs send v2 — preparación del protocolo.
- XFS slabs — menos memoria en metadatos.
Memoria y bloque
- KCSAN — mejoras del detector.
- zstd 1.4.10 — el kernel actualiza el compresor.
- fscrypt 256 — claves maestras de 256 bits.
- contador — interfaz de character device para eventos.
13. Qué viene después
La merge window de 5.17 se abre el 10 de enero y cierra el 23. Ese ciclo traerá AMD P-State, montajes idmap anidados, BPF CO-RE y BLAKE2s; Linux 5.17 sale el 20 de marzo, y LWN cubrió la ventana de 5.16 en su primera parte.
Para las distribuciones, 5.16 es la release de invierno: Ubuntu 22.04 y Fedora 36 la adoptan, y las rolling la tienen en semanas. La LTS sigue siendo 5.15, que aguanta hasta 6.1.
Las próximas releases mostrarán si los folios se generalizan y si AMX encuentra software que lo use. Tampoco hay fecha para que el scheduler de clústeres cubra todas las topologías híbridas.
14. Referencias
- KernelNewbies: Linux 5.16 — inventario completo por subsistema.
- ChangeLog-5.16 — la lista completa de commits.
- Phoronix: Linux 5.16 Released — repaso de hardware y rendimiento.
- Phoronix: Linux 5.16 features — repaso de las novedades del ciclo.