Linux 5.17: AMD P-State, idmap recursivo y BLAKE2s
AMD estrena su propio driver de frecuencia, los montajes idmap se anidan y el RNG cambia SHA-1 por BLAKE2s. 13.038 changesets y una semana extra.
Linux 5.17 se ha publicado hoy, 20 de marzo de 2022, con un driver propio de frecuencia para los AMD Zen, montajes idmap que se pueden anidar y BLAKE2s en el generador aleatorio. El ciclo suma 13.038 changesets y 1.900 desarrolladores, y cierra con una semana extra que, según Torvalds, casi sobraba.
El anuncio lo deja claro: «So we had an extra week at the end of this release cycle, and I’m happy to report that it was very calm indeed», según LWN. La release sale el domingo 20 de marzo de 2022, diez semanas después de Linux 5.16 y dentro de la serie 5.x; la merge window de 5.18 se abre al día siguiente.
El ciclo es de actividad media: 13.038 changesets sin merges, 1.900 desarrolladores y 268 novatos, según las estadísticas de LWN. Intel firma 1.510 changesets (11,6 %), el trabajo sin empresa 975 (7,5 %), Red Hat 894 (6,9 %), Google 878 (6,7 %), AMD 490 (3,8 %) y Linaro 452 (3,5 %). Christoph Hellwig encabeza la lista individual con 168, por delante de Eric Dumazet, con 150.
Hay tres claves. La primera es la CPU: AMD P-State deja de depender del firmware para decidir la frecuencia. La segunda es el sistema de ficheros: los montajes con idmap se pueden anidar, y fscache se reescribe. La tercera es la seguridad: el RNG cambia SHA-1 por BLAKE2s y el kernel mitiga la especulación en línea recta.
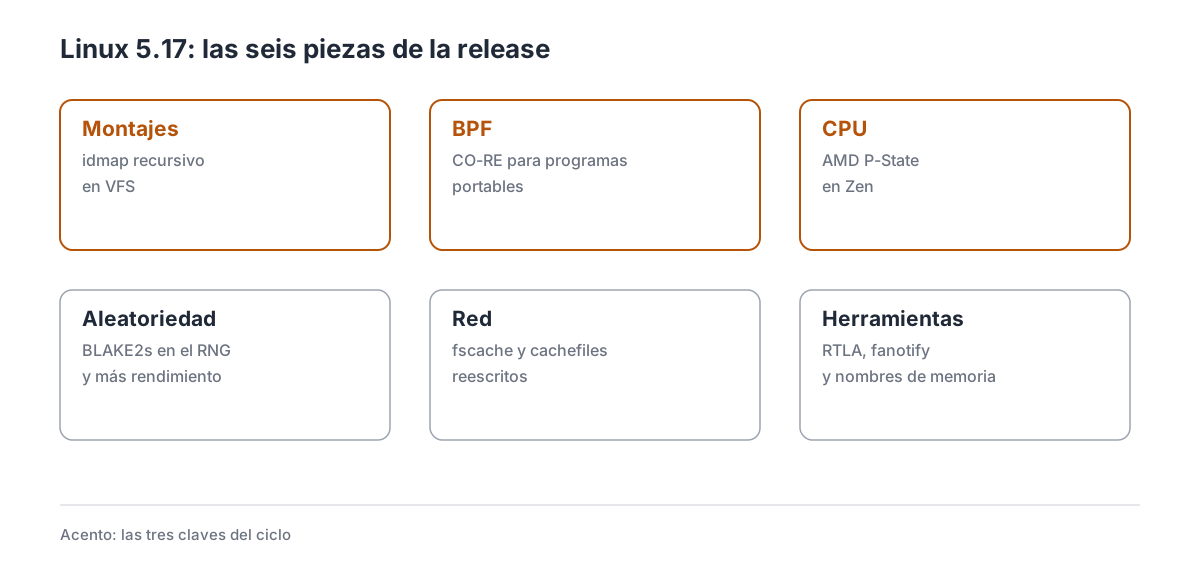
Las seis piezas que explican el ciclo, con las tres claves marcadas en ámbar.
1. Las cifras de un ciclo normal
| Dato | Valor |
|---|---|
| Fecha de release | 20 de marzo de 2022 |
| Versión anterior | 5.16 (9 de enero de 2022) |
| Merge window | 10 al 23 de enero de 2022 |
| Release candidates | 8 |
| Changesets | 13.038 |
| Desarrolladores | 1.900 |
| Novatos | 268 |
El ciclo baja respecto a 5.16 (14.190 changesets) y sube respecto a 5.15 (12.337): una release típica. El dato curioso es el calendario: Torvalds añadió una rc8 porque el árbol no terminaba de estabilizarse, y luego reconoció que la semana había ido con calma que se podría haber saltado.
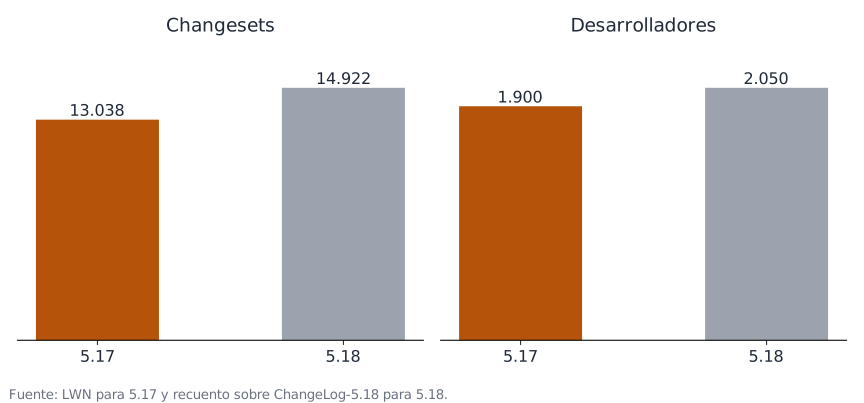
El ciclo de 5.17 comparado con 5.18.
La merge window de enero trajo menos cambios que la de 5.16, y las estadísticas de LWN lo atribuyen a un ciclo sin una novedad dominante: muchas mejoras pequeñas en drivers y redes, ninguna que arrastrara miles de líneas. La retirada de drivers antiguos explica parte del descenso: menos código que mantener y menos parches rutinarios. El ciclo también fue el de el regreso a la rutina después de las vacaciones: la merge window se abrió el 10 de enero, con medio proyecto volviendo de Navidad, y aun así llegaron 13.000 cambios. El reparto por empresas también refleja el momento: Intel y Red Hat siguen tirando de los drivers y de la infraestructura, mientras AMD sube con el trabajo de P-State y de las GPU. La cifra que importa para el lector es la de desarrolladores: 1.900 es la participación más baja desde 5.13, y confirma que el proyecto depende de una base estable de contribuidores mientras el número de cambios se mantiene.
2. Montajes idmap que se pueden anidar
Los montajes con idmap permiten montar un sistema de ficheros con los UIDs y GIDs desplazados: el proceso ve sus usuarios, pero el disco guarda otros. Es la base de los contenedores sin privilegios y de los sistemas de ficheros compartidos entre máquinas con rangos distintos.
5.17 extiende la infraestructura para que un montaje con idmap pueda montarse dentro de otro montaje con idmap. Hasta ahora, el VFS solo admitía un nivel: el montaje tenía que ir sobre un sistema de ficheros «normal». Con el cambio, un contenedor puede anidar capas y montar un idmap sobre otro sin trucos.
El cambio toca el VFS, no los sistemas de ficheros: la infraestructura de mapeo se extiende para que un vfsmount pueda tener un idmap distinto del de su padre, y las operaciones que cruzan montajes componen los dos. La ventaja se ve en los contenedores anidados y en los sistemas de ficheros en red, donde el rango de IDs del cliente y del servidor no coincide. La contrapartida es que el modelo es más complejo: cada nivel de idmap compone el siguiente, y un error de configuración deja ficheros con permisos que no son los que parecen.
Los límites: el montaje base tiene que admitir idmap, y las herramientas tienen que saber interpretar los rangos. La documentación del VFS describe el mecanismo.
3. BPF CO-RE: un programa, muchos kernels
Un programa BPF compilado contra una versión del kernel puede dejar de funcionar en otra porque la posición de un campo dentro de una estructura cambia. CO-RE (Compile Once, Run Everywhere) resuelve el problema con información de tipos: el programa se compila contra el BTF del kernel y, al cargarse, libbpf reescribe los accesos según la estructura real.
5.17 añade el soporte de CO-RE en el kernel y en libbpf, con relocalizaciones para campos, tipos y llamadas. También llega el bpf_loop(), que permite escribir bucles largos sin que el verificador tenga que desenrollarlos, y más helpers para sockets.
CO-RE no cambia el verificador: los programas siguen comprobándose al cargarse, pero las lecturas de campos se reescriben antes de esa comprobación. Si el campo no existe en el kernel de destino, la relocalización falla y el programa no se carga, en lugar de leer datos sin sentido. La otra pieza es el bpf_loop(): los bucles con muchas iteraciones obligaban al verificador a desenrollarlos, lo que limitaba el tamaño y el tiempo de carga; con el helper, el programa itera en tiempo de ejecución y el verificador solo comprueba el cuerpo. El efecto es que una herramienta de observabilidad puede distribuirse como binario y funcionar en kernels distintos, en lugar de compilarse en cada máquina. La contrapartida es la dependencia del BTF: si el kernel no lo expone, CO-RE no puede hacer su trabajo.
Los límites: CO-RE necesita un kernel con CONFIG_DEBUG_INFO_BTF, y las estructuras internas siguen cambiando: el programa se adapta a su posición, no a su semántica. La documentación de BPF recoge las APIs.
4. AMD P-State: la frecuencia deja de depender del firmware
Hasta 5.17, los procesadores AMD usaban acpi-cpufreq, que pide los cambios de frecuencia al firmware mediante ACPI. Ese camino funciona, pero añade latencia y limita lo que el sistema operativo puede decidir: el firmware tiene la última palabra.
AMD P-State cambia el modelo: el driver accede directamente al hardware mediante los registros MSR y el Collaborative Processor Performance Control, y el kernel decide la frecuencia con sus propias políticas. El resultado es menos latencia en los cambios, mejor respuesta a las cargas y la base para el control de energía que llegará después con EPP.
AMD P-State también deja preparado el camino para EPP (Energy Performance Preference), que llega con más fuerza en releases posteriores: el usuario podrá elegir entre rendimiento y eficiencia sin cambiar de gobernador.
La diferencia práctica se mide en latencia y en consumo: al no pasar por ACPI, el cambio de frecuencia tarda menos y el sistema puede reaccionar antes a una carga repentina. En un portátil, eso supone menos tirones al abrir aplicaciones; en un servidor, en una curva de potencia más fina. El driver expone los mismos gobernadores que acpi-cpufreq, así que las herramientas no cambian; lo que cambia es quién decide la frecuencia. En modo active, el kernel escribe los límites de rendimiento y el hardware los aplica; en passive, sigue pidiendo cambios por ACPI pero con más información. El cambio es de control, no solo de rendimiento: el scheduler y el driver de frecuencia pueden coordinarse, y el usuario puede elegir el modo con amd-pstate=active o passive. La contrapartida es que el driver depende de que el firmware declare bien las capacidades, y en algunos equipos hubo que esperar correcciones.
Los límites: AMD P-State necesita Zen 2 o posterior y un firmware que exponga CPPC; en 2022 no todas las distribuciones lo activaban por defecto. La documentación de cpufreq describe los modos.
5. BLAKE2s en el RNG
El generador aleatorio del kernel usaba SHA-1 para extraer entropía, y SHA-1 está roto como función de hash. 5.17 cambia el extractor a BLAKE2s, que es más rápido y ofrece 128 bits de seguridad en lugar de 80.
El cambio no afecta a la calidad de la aleatoriedad que ve el usuario: afecta a la resistencia del estado interno frente a un atacante que consiga leerlo. Con BLAKE2s, recuperar el estado anterior es más caro, y el coste de calcularlo baja, así que el sistema sale ganando por los dos lados.
El extractor es la parte del RNG que convierte la entropía acumulada en una semilla uniforme; cambiar SHA-1 por BLAKE2s no altera la interfaz, pero sí el rendimiento y la resistencia. El cambio tiene un efecto medible en el arranque: extraer entropía con BLAKE2s es más rápido que con SHA-1, y en máquinas virtuales el arranque deja de quedarse esperando al generador. El generador mantiene una estimación de la entropía disponible y mezcla las fuentes en un orden definido; el cambio de función de hash no altera esa contabilidad, solo la calidad del resultado. La migración es parte de un trabajo más largo: en 5.18 el RNG se reescribió a fondo, y 5.17 es el primer paso. La contrapartida es que el código de criptografía del kernel no puede usar bibliotecas externas, así que la implementación se revisa a mano.
Los límites: BLAKE2s protege el estado, no la entropía de entrada; si el hardware no aporta suficiente, el problema sigue ahí. La documentación del RNG tiene el modelo.
6. fscache y cachefiles se reescriben
La caché local es lo que hace usable un portátil con la carpeta compartida del trabajo: sin ella, cada apertura de fichero obliga a ir a la red y volver; con ella, el fichero se lee del disco y se valida contra el servidor. La caché local es transparente para la aplicación: el proceso abre el fichero y el kernel decide si lo lee del disco o de la red. Los sistemas de ficheros en red (NFS, CIFS, AFS, 9p) pueden cachear datos en disco local con fscache y cachefiles. El código llevaba años acumulando capas y era difícil de mantener: cada sistema de ficheros hablaba con la caché a su manera, y los fallos se manifestaban como corrupciones difíciles de detectar.
5.17 reescribe la capa con una interfaz común basada en folios, y porta CIFS al nuevo modelo. La caché gana claridad, y los sistemas de ficheros que la usan comparten el mismo camino para leer, escribir y validar.
La caché también gana herramientas: cachefilesd puede limitar el tamaño y el número de ficheros, y el estado se consulta en /proc/fs/fscache.
El modelo nuevo separa el volumen (dónde se guardan los datos) del índice (qué ficheros están cacheados) y permite que cada sistema de ficheros aporte su propia lógica de invalidación. La reescritura unifica también el volumen de la caché: fscache guarda los datos en ficheros de tamaño fijo, y cachefiles se encarga de la expulsión y de la coherencia. Con la interfaz nueva, un sistema de ficheros declara qué operaciones sabe cachear y la capa decide. La capa nueva también corrige un problema de raíz: la antigua mezclaba el almacenamiento con el índice, y un fallo en el índice podía dejar datos huérfanos que crecían sin límite. El cambio importa en escritorios y portátiles con NFS o SMB: la caché local hace que abrir un fichero remoto sea rápido, y una capa mal escrita podía corromperlo. La contrapartida es que la migración es grande y los sistemas de ficheros que no se portaron siguen con la interfaz antigua.
Los límites: la caché sigue necesitando espacio en disco y una política de expulsión; en un portátil con poco espacio, el beneficio puede no compensar. La documentación de fscache describe el modelo.
7. RTLA, fanotify y nombres para la memoria anónima
RTLA es la herramienta de análisis de tiempo real que entra con 5.17: un conjunto de comandos para medir la latencia de los temporizadores y del sistema, pensado para el trabajo de PREEMPT_RT. rtla timerlat mide cuánto tarda un temporizador en despertar, y rtla osnoise mide el ruido del sistema operativo.
En fanotify, el nuevo FAN_RENAME informa del nombre antiguo y el nuevo en una sola notificación, en lugar de obligar a correlacionar dos eventos. Es lo que necesitan los antivirus y los indexadores para seguir la pista de un fichero que se mueve.
El nombre no es un identificador de seguridad: cualquier proceso puede poner el que quiera a su propia memoria, y el kernel no lo usa para permisos. Y la memoria anónima se puede poner nombre con prctl(PR_SET_VMA, PR_SET_VMA_ANON_NAME): el nombre aparece en /proc/pid/maps y en smaps, así que un proceso puede etiquetar sus regiones y el administrador ve qué es cada malloc().
rtla timerlat también puede ejecutarse en modo top, que muestra la latencia en vivo, y rtla osnoise detecta el ruido que introduce el propio sistema operativo: interrupciones, softirqs y tareas del kernel. La herramienta nace del esfuerzo por llevar PREEMPT_RT al árbol: sin una forma de medir la latencia, el trabajo de tiempo real se queda en teoría. RTLA viene con el kernel (tools/tracing/rtla) y no necesita módulos: lee las trazas del kernel y presenta percentiles, no una lista de números. Fanotify y los nombres de memoria responden a la misma idea: dar contexto al que depura sin cambiar el comportamiento del sistema. Fanotify y los nombres de memoria comparten la misma idea: dar contexto al que depura sin cambiar el comportamiento del sistema. Las tres piezas son de diagnóstico: miden latencia, avisan de cambios y etiquetan memoria. Los límites: RTLA necesita hardware y configuración, fanotify requiere un consumidor que lo entienda y los nombres de memoria solo los pone el propio proceso.
8. Especulación en línea recta
Las CPU modernas especulan instrucciones para llenar sus unidades de ejecución, y esa especulación se puede usar como canal lateral. 5.17 añade mitigaciones para la especulación en línea recta, una variante que aprovecha que el procesador puede ejecutar instrucciones más allá de un salto incondicional.
La mitigación inserta una barrera en los caminos que pueden acabar en una instrucción especulada, con un coste pequeño en los casos afectados. LWN lo contó en Blocking straight-line speculation.
El nombre viene del patrón que explota: una secuencia de código sin saltos que el procesador ejecuta de forma especulativa más allá del punto donde debería parar. La barrera obliga a la CPU a detenerse en el límite. El trabajo se hizo en colaboración con los fabricantes de CPU, y las mitigaciones se activan solo en los procesadores afectados para no penalizar al resto. La mitigación se aplica en los puntos donde el compilador puede generar código especulable, como los saltos indirectos y las llamadas, y añade una instrucción de barrera que corta la especulación. En las CPU afectadas el coste es bajo, pero no cero. El patrón se repite en todas las variantes: el hardware especula, el software pone barreras y el rendimiento paga la diferencia. Los límites: la mitigación depende de la arquitectura y del compilador, y no cubre todas las variantes que aparecieron después.
9. El salseo: una semana de más
Linux 5.17 cerró con ocho release candidates en lugar de siete. Torvalds lo explicó en el anuncio: el árbol no terminaba de estabilizarse y prefirió una semana más antes que publicar con fallos que acabaran en las estables. Después, con la release en la mano, admitió que la semana había ido con tal calma que se podría haber saltado.
El anuncio de Torvalds también sirvió para agradecer el trabajo de los maintainers durante un ciclo que coincidió con la guerra en Ucrania y con la incertidumbre en la cadena de suministro; el proyecto siguió publicando sin cambiar el calendario. No hubo pelea de maintainers ni episodio de CoC: el salseo del ciclo se reduce a un proyecto que prefiere esperar y luego reconoce que quizá no hacía falta. La decisión tuvo un coste pequeño, y el calendario de 5.18 se movió un poco.
La rc8 también sirvió para colar correcciones que, de otro modo, habrían llegado a las estables como parches de emergencia. La rc8 también sirvió para colar correcciones que, de otro modo, habrían llegado a las ramas estables como parches de emergencia. La anécdota muestra cómo funciona el kernel: la fecha de una release no la fija un calendario, la fija el estado del tree. Y a veces el margen que se pide por precaución sobra.
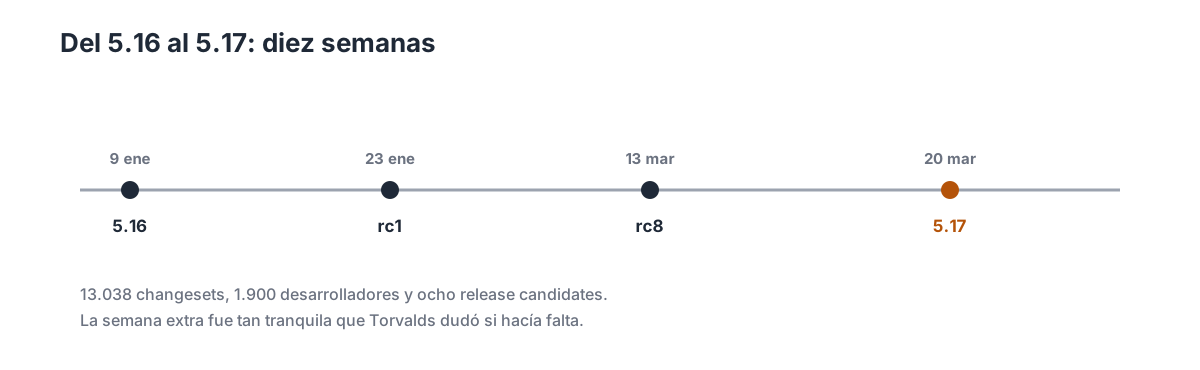
Diez semanas de ciclo, con ocho release candidates y una semana extra por precaución.
10. Por subsistemas
10.1 Core y herramientas
io_uring permite saltarse la publicación de CQE cuando el programa no las necesita, y las finalizaciones priorizadas dejan pasar primero las que importan. La contabilidad de referencias añade un detector de fugas en tiempo de ejecución, y el kernel puede descomprimir módulos para ahorrar espacio.
El objetivo es que un /dev mundano no pueda ejecutar binarios ni conservar privilegios. El cambio afecta a los sistemas que crean nodos en /dev al vuelo, como los de escritorio y los contenedores. devtmpfs se monta por defecto con noexec y nosuid, y delayacct contabiliza los retrasos de swapin y de compactación. El scheduler core gana contabilidad de tiempo forzado, y cpuacct incluye el tiempo de invitado y afina sus contadores.
10.2 Sistemas de ficheros
ext4 se pasa a la API de montaje nueva, Ceph estrena sintaxis de dispositivo y se retiran ioctls muertos que nadie usaba.
En almacenamiento, Btrfs reduce el trabajo de fsync en directorios y el árbol de espacio libre responde por tamaño, y CIFS se porta a la caché nueva. El balance pausado permite añadir un disco a un sistema montado y reanudar después, sin bloquear el arranque. Btrfs acelera el logging de directorios y el árbol de espacio libre, permite añadir dispositivos con un balance pausado y enviar con reubicación concurrente. CIFS se porta a la nueva caché, y XFS empieza a usar folios grandes.
10.3 Memoria
El cambio es preparatorio: el código se adapta, pero los folios grandes aún no se activan por defecto. La página de memoria se convierte a folios sin activarlos aún, y struct slab se separa de struct page. Llega set_mempolicy_home_node(), DAMON amplía sus estadísticas y KCSAN detecta barreras de memoria que faltan.
10.4 Bloque
La retirada de rsxx es una muestra de la limpieza del ciclo: hardware que ya nadie usa y código que estorba. El trabajo prepara la conversión de la caché de página, que llega en releases posteriores. El bloque y iomap reciben soporte de folios, md elimina la limitación de cola en RAID1 y RAID10, y se retira el driver rsxx.
10.5 Networking
El wifi avisa de las asociaciones que vuelven tras un corte, permite monitorizar el radar fuera de canal y separa las APIs de detección dedicada.
El resto de la pila recibe ajustes pequeños: menos bloqueos, más contadores y mejor reparto entre colas. TCP mejora el liberado de búferes y CAP_NET_RAW permite SO_PRIORITY y SO_MARK. BPF puede leer los tamaños de búfer, el bonding estrena arp_missed_max y las marcas de tiempo se propagan al dispositivo activo.
10.6 Virtualización
virtiofs admite DAX por fichero, con lo que un fichero concreto puede mapearse directamente en memoria en lugar de pasar por el host.
El objetivo es que un invitado pueda usar dispositivos con IOMMU sin emular el hardware. iommu/virtio admite dominios de identidad, virtio permite configurar el número de colas, Xen añade PVUSB y vDPA estrena driver_override.
10.7 Arquitecturas
El detector de race conditions gana cobertura en la arquitectura que más crece. ARM64 habilita KCSAN, y x86 suma el Smart Trace Buffer de AMD y el soporte de bancos MCA no uniformes. RISC-V y PowerPC reciben correcciones y plataformas nuevas.
10.8 Gráficos y plataformas
El soporte de plataforma sigue el ritmo de los portátiles nuevos, con teclados, sensores y retroiluminación. AMD añade el Smart Trace Buffer en GPUs y amplía la UAPI de amdkfd. Intel añade la clase privacy-screen y el soporte de Raptor Lake S, y los portátiles suman retroiluminación por VESA.
11. Lo que no llega
La release tampoco trae un cambio de formato ni una migración obligatoria: los sistemas de ficheros, los drivers y las interfaces siguen donde estaban. RTLA, por su parte, es una herramienta nueva: su interfaz cambió en releases posteriores y su documentación aún está en construcción. Quedan tres dependencias de hardware y configuración: el driver de frecuencia de AMD solo controla núcleos que exponen CPPC; CO-RE exige que el kernel de destino publique su BTF; y el anidamiento de idmap necesita que cada capa lo admita. Fuera de eso, la release no deja nada pendiente.
RTLA es una herramienta nueva y su interfaz cambió en releases posteriores. La mitigación de especulación en línea recta no cubre todas las variantes. Y 5.17 no es LTS: la LTS es 5.15, y la siguiente será 6.1.
12. Cambios menores
Core
- señales — reencolado de las no entregables.
Ficheros
- Btrfs defrag — interrumpible.
- Btrfs: caché antigua — se retira la caché de bloques.
- Ceph nopagecache — opción de montaje.
- SMB NTLMSSP — versión en el handshake.
Memoria
- memcg oom_group — evento al matar el grupo.
- hugetlb numa — estadísticas por nodo.
- vmalloc — asignaciones con restricciones.
Networking
13. Qué viene después
La merge window de 5.18 se abre el 21 de marzo y cierra el 3 de abril. Ese ciclo traerá IBT, user_events, DAMON por sysfs y el driver de Intel SDSi; Linux 5.18 sale el 22 de mayo, y el inventario de KernelNewbies tiene la lista de lo que llega.
Para las distribuciones, 5.17 es la release de primavera: Ubuntu 22.04 y Fedora 36 la adoptan, y las rolling la tienen en semanas. La LTS sigue siendo 5.15 hasta que 6.1 tome el relevo.
Las próximas releases mostrarán si AMD P-State se impone a acpi-cpufreq en los portátiles y si los montajes idmap anidados llegan a los contenedores sin privilegios. Tampoco hay fecha para que CO-RE funcione en kernels sin BTF.
14. Referencias
- KernelNewbies: Linux 5.17 — inventario completo por subsistema.
- ChangeLog-5.17 — la lista completa de commits.
- Phoronix: Linux 5.17 features — repaso de las novedades del ciclo.
- kernel.org: releases — calendario y LTS.