Linux 5.18: IBT, DAMON y el kernel con funciones de pago
IBT cierra el control de flujo en Intel, DAMON se gobierna por sysfs y Btrfs comprime la E/S. Además: el driver de Intel SDSi que abrió el debate.
Linux 5.18 se ha publicado hoy, 22 de mayo de 2022, con IBT para cerrar las llamadas indirectas en Intel, user_events para trazar desde el espacio de usuario y DAMON gobernado por sysfs. El ciclo suma 14.922 changesets y 2.050 autores, y llega puntual tras siete release candidates. También entra el driver de Intel SDSi, el primero que pone precio a funciones de la CPU.
Torvalds lo cerró sin sobresaltos: «No unexpected nasty surprises this last week, so here we go with the 5.18 release right on schedule», según LWN. La release sale el domingo 22 de mayo de 2022, nueve semanas después de 5.17 y dentro de la serie 5.x; la merge window de 5.19 se abre al día siguiente.
Las cifras de este post se cuentan sobre el ChangeLog de kernel.org, porque las estadísticas de LWN de este ciclo no están disponibles: 16.205 commits, de los que 1.283 son merges, y 2.050 autores distintos. Son cifras comparables a las de 5.19 si se aplica el mismo método, y sirven para situar el ciclo, no para compararlo con un récord.
El ciclo tiene tres claves. La primera es la seguridad: IBT añade una comprobación de hardware en cada llamada indirecta, y el memcpy() deja de aceptar tamaños que no puede verificar. La segunda es la memoria: DAMON estrena una interfaz en sysfs y DAMOS puede actuar sobre lo que mide. La tercera es el almacenamiento: Btrfs comprime y descomprime desde el espacio de usuario, y el reflink cruza montajes.
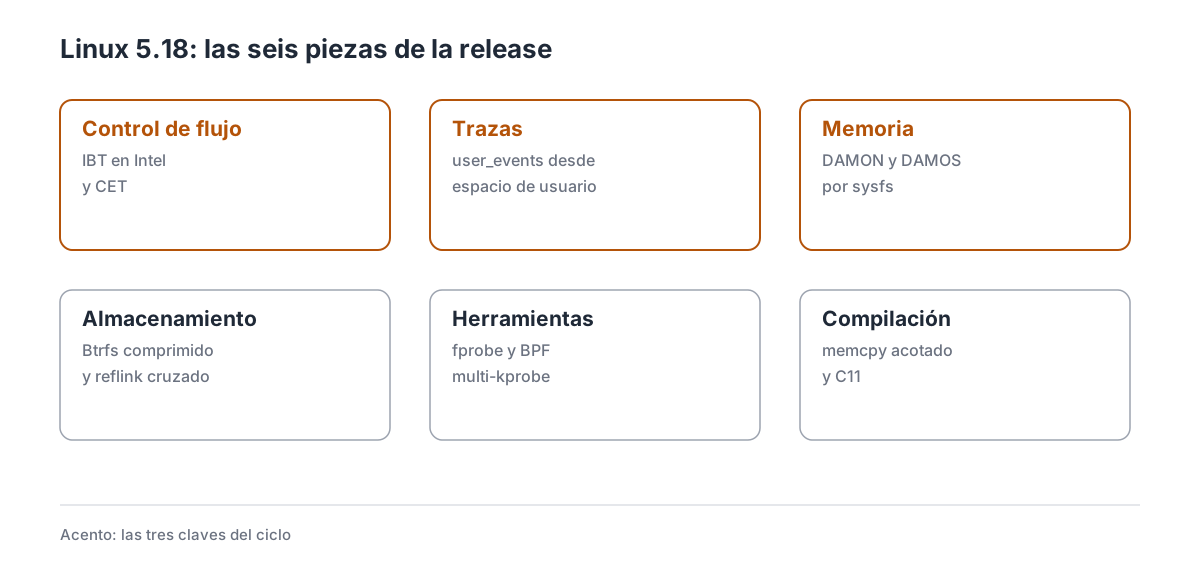
Las seis piezas que explican el ciclo, con las tres claves marcadas en ámbar.
1. Las cifras de un ciclo puntual
| Dato | Valor |
|---|---|
| Fecha de release | 22 de mayo de 2022 |
| Versión anterior | 5.17 (20 de marzo de 2022) |
| Merge window | 21 de marzo al 3 de abril de 2022 |
| Release candidates | 7 |
| Changesets | 14.922 |
| Commits totales | 16.205 |
| Autores | 2.050 |
El ciclo no bate récords: 14.922 changesets sin merges es una cifra media para la serie 5.x, y los 2.050 autores quedan lejos de los 2.086 de 5.19. Lo que sí trae es una release puntual, sin retrasos ni rc extra, y en 2022 eso no era frecuente.
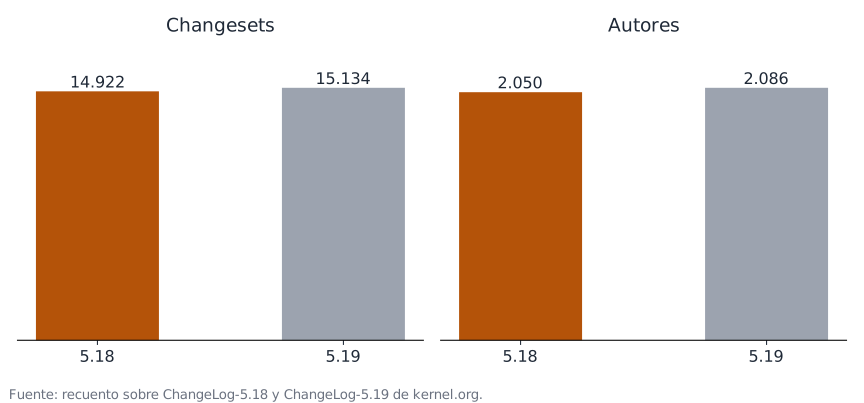
El ciclo de 5.18 comparado con 5.19, con el mismo método de recuento.
Falta el reparto por empresas: sin las estadísticas de LWN no hay reparto por empresas, y este post no lo inventa. El método tiene otro sesgo: el ChangeLog lista los commits que llegan a mainline, pero no las revisiones ni el trabajo descartado, así que las cifras sirven para comparar ciclos entre sí, no para medir esfuerzo. Quien lo necesite puede contar los Signed-off-by del ChangeLog, con el sesgo de que un mismo cambio puede llevar varios.
2. IBT: el control de flujo llega a Intel
Los ataques de programación orientada a retorno (ROP) y de llamadas indirectas (JOP) funcionan reutilizando código existente: en lugar de inyectar instrucciones, el atacante redirige una llamada o un retorno a una función que ya está en memoria. CET es la respuesta de Intel, y tiene dos mitades: la shadow stack, que protege los retornos, y el Indirect Branch Tracking (IBT), que protege las llamadas indirectas.
IBT funciona con una instrucción nueva: el compilador marca cada función válida con endbr64, y el procesador comprueba que el destino de una llamada indirecta empieza por esa marca. Si no, lanza una excepción. El atacante ya no puede saltar a mitad de una función ni a una instrucción arbitraria, porque el hardware lo detecta antes de ejecutarla.
La protección se activa por binario y por proceso: el kernel marca sus propias funciones, y el cargador comprueba que el ejecutable tenga la marca antes de habilitar CET para él. El kernel activa IBT cuando el hardware y el compilador lo permiten, y lo combina con la shadow stack cuando está disponible. La contrapartida es la cadena de herramientas: hace falta un compilador que emita endbr64, y el kernel tiene que marcar sus propias entradas. La documentación de x86 describe el modelo.
La marca endbr64 es también la señal que usa el cargador de binarios para saber que un ejecutable está preparado: si el primer byte no es la instrucción, el kernel no activa la protección para ese binario. El coste de IBT es pequeño: una instrucción de cuatro bytes al principio de cada función y una comprobación en el procesador que no añade ciclos visibles. Lo que sí cambia es el tamaño del código y la disciplina: cualquier función a la que se salte indirectamente tiene que llevar la marca, incluidos los stubs de ensamblador. Los límites: IBT necesita CPU Intel con CET, y en 2022 eso era hardware reciente; los binarios de espacio de usuario también se tienen que compilar con la marca. Sin las dos piezas, la protección no se activa.
3. user_events: trazas desde el espacio de usuario
El tracing del kernel ve lo que pasa dentro del kernel, y se queda ciego cuando el programa cruza al espacio de usuario. user_events cambia eso: un proceso registra un evento en tracefs y lo emite cuando quiere, y el kernel lo mezcla con el resto de trazas con el mismo formato y las mismas marcas de tiempo.
La interfaz user_events entra en 5.18 con un fichero por evento y una página compartida donde el proceso escribe los datos. El kernel se encarga de la sincronización y de exponer el evento a perf y a trace-cmd. LWN lo contó en User-space events.
La ventaja es que no hace falta inventar otro sistema de trazas: una base de datos o un servidor web puede emitir eventos que aparecen junto a los de sched y block, con la misma correlación temporal. Para el que depura, deja de haber dos relojes y dos formatos.
La página compartida tiene un formato fijo: un contador, el identificador del proceso y un espacio de datos que el programa rellena. El kernel lee esa página cuando el evento se activa y copia el contenido al búfer de traza, así que el proceso no puede escribir basura después. La interfaz también permite escribir desde una biblioteca sin pasar por una llamada al sistema por evento: el proceso compone la entrada en su página y el kernel la recoge cuando el evento se activa. Eso reduce el coste a unas decenas de nanosegundos por evento, suficiente para instrumentar bucles internos. Los límites: el proceso tiene que registrar el evento antes de usarlo, el formato es fijo una vez registrado y la escritura no es gratuita. En 5.18 la interfaz es nueva y las bibliotecas tardaron en adoptarla.
4. DAMON y DAMOS: la memoria se gobierna por sysfs
DAMON (Data Access Monitor) vigila qué páginas usa cada proceso y con qué frecuencia. Hasta 5.18 se configuraba por debugfs y sus políticas (DAMOS) eran limitadas; el ciclo estrena una interfaz en sysfs pensada para quedarse, con esquemas, regiones y estadísticas por fichero.
La otra mitad es la independencia del mecanismo: DAMON deja de depender de una implementación concreta de muestreo y separa el modelo de acceso de cómo se actúa sobre él. Con eso, DAMOS puede actuar sobre lo que mide: enfriar páginas, migrarlas o marcarlas para reclaim.
Se trata de que el administrador diga qué quiere y el kernel decida cómo: por ejemplo, «mantén calientes las páginas de esta región y enfría el resto». La contrapartida es que hay que entender el modelo y escribir la política, algo que en 2022 solo hacían los equipos con cargas muy medidas.
Un esquema de DAMON se define con un rango de direcciones, un conjunto de regiones, un intervalo de muestreo y una acción. El demonio (kdamond) recorre las regiones, mide los accesos y aplica la acción; el administrador puede cambiar el esquema en caliente escribiendo en sysfs. Los límites: DAMON consume CPU en el muestreo y su ajuste automático aún es joven; DAMOS no puede hacer magia con la memoria que no existe. La documentación de DAMON recoge la interfaz.
5. El scheduler y los CCD de AMD
Los procesadores AMD con varios CCD (chiplets) tienen un problema de topología: cada CCD agrupa varios núcleos con su propia caché L3, y una tarea que salta de un CCD a otro pierde la caché y la latencia sube. El scheduler trataba el paquete como una sola unidad y repartía tareas entre CCDs como si fueran equivalentes.
5.18 ajusta el desequilibrio NUMA para sistemas con varias LLC: el balanceo tiene en cuenta los dominios de caché y evita mover tareas entre CCDs cuando no hace falta. También corrige la topología en sistemas con nodos sin CPU, un caso que aparecía en máquinas con memoria CXL o con nodos vacíos.
El efecto se ve en cargas con muchos hilos y poca afinidad: una compilación, una base de datos o un servidor web reparten mejor el trabajo y pierden menos caché. El cambio afecta sobre todo a los EPYC con varios CCD y a los Ryzen con chiplets, donde la penalización de saltar de CCD podía ser del 10 % o más en cargas sensibles a la caché. En un portátil con un solo CCD no se nota. Los límites: el ajuste depende de que el firmware describa bien la topología, y en algunas placas la información es incompleta.
6. fprobe: una sonda para muchas funciones
Los kprobes permiten enganchar una función del kernel, y los kprobe multi permiten enganchar varias con un solo programa. 5.18 añade fprobe, una capa que usa los mecanismos de ftrace para hacer lo mismo con menos coste, y la conecta a BPF con el BPF_TRACE_KPROBE_MULTI.
La diferencia está en el coste: enganchar cientos de funciones con kprobes individuales multiplica las interrupciones y el trabajo de instrumentación; con fprobe, el kernel usa el mismo mecanismo que ftrace y comparte el trabajo entre todas las sondas. Para una herramienta que traza todas las funciones de un subsistema, eso decide si la herramienta sirve o no.
Se usa sobre todo para observar producción: en lugar de instrumentar una función, se instrumenta una familia y se filtra en el programa BPF. La contrapartida es que fprobe y los kprobes multi comparten limitaciones: no todas las funciones se pueden enganchar y el nombre tiene que existir en el kernel.
En las pruebas de la serie, enganchar cien funciones con kprobes individuales podía costar más que la propia carga que se quería medir; con fprobe, el coste se reparte y la distorsión baja. fprobe también se puede usar desde el propio kernel con la API de ftrace, sin BPF de por medio: un módulo puede registrar una función de entrada y otra de salida para un conjunto de símbolos. Es la vía que usan las herramientas de traza que no quieren depender del verificador. Los límites: la API de BPF para kprobe multi necesita una versión reciente de libbpf, y el coste, aunque menor, sigue existiendo. La documentación de ftrace describe el mecanismo.
7. Btrfs: E/S comprimida y reflink entre montajes
Btrfs lleva años con compresión transparente, y 5.18 añade la E/S comprimida desde el espacio de usuario: dos ioctls permiten leer y escribir datos comprimidos en bruto, sin que el kernel tenga que descomprimir y volver a comprimir. El caso de uso es un backup o una herramienta de deduplicación que ya tiene los datos comprimidos y quiere escribirlos tal cual.
El otro cambio es el reflink y dedupe entre montajes: hasta ahora, clonar un fichero con FICLONE exigía que origen y destino estuvieran en el mismo vfsmount; con el cambio, dos montajes del mismo sistema de ficheros pueden compartir extents. Eso simplifica los contenedores, donde el mismo Btrfs se monta en varios sitios.
Además, Btrfs acelera el fsync de directorios, el rename y el link y prepara el árbol de extensiones v2. Todo esto se aprecia en cargas con muchos ficheros pequeños, donde el logging de directorios dominaba el tiempo.
El cambio encaja con la dirección de Btrfs de los últimos años: menos capas, menos copias y más control para el espacio de usuario. La E/S comprimida es útil para un rsync que ya tiene los bloques comprimidos o para una herramienta de backup que quiere evitar la doble compresión. El kernel solo transporta los datos; la integridad la garantiza el checksum de Btrfs. Los dos ioctls usan el mismo formato de compresión que el resto de Btrfs (zstd, lzo o zlib) y devuelven el tamaño comprimido y el original, de modo que la herramienta puede validar lo que escribió. Los límites: la E/S comprimida necesita que la aplicación sepa el formato y es fácil corromper datos si se usa mal; el reflink cruzado requiere que los montajes sean del mismo sistema de ficheros.
8. memcpy acotado y C11
El memcpy() es una de las funciones más peligrosas del kernel: si el tamaño es mayor que el destino, se escribe fuera y el fallo puede pasar desapercibido. 5.18 añade comprobaciones estrictas en tiempo de compilación para la familia memcpy() bajo FORTIFY_SOURCE: cuando el tamaño es una constante y el destino es un objeto conocido, el compilador avisa y el kernel aborta la compilación.
El cambio tiene un efecto secundario interesante: obliga a revisar código antiguo que copiaba con tamaños calculados a mano y que nunca se había mirado. En el ciclo se arreglaron decenas de avisos, algunos con fallos reales detrás.
En paralelo, el kernel pasa a C11: deja de usar -std=gnu89 y adopta un estándar con declaraciones en medio del bloque, tipos anónimos y _Generic. No es una revolución, pero permite escribir código más limpio y alinea el kernel con lo que los compiladores ya admiten.
Las dos piezas apuntan al mismo sitio: menos errores silenciosos y menos dependencia de extensiones antiguas. C11 también permite usar static_assert en el kernel, que hasta ahora tenía su propia versión, y hace que las estructuras anónimas y los inicializadores designados se comporten igual en todos los compiladores. Los límites: FORTIFY_SOURCE no puede comprobar los tamaños que solo se conocen en ejecución, y C11 no arregla el código que ya estaba mal escrito.
9. El RNG se rehace
El generador de números aleatorios del kernel recibió en 5.18 una reescritura profunda de la mano de Jason Donenfeld. Los cambios rehacen la criptografía interna, usan RDSEED cuando está disponible y tratan la entropía del cargador y de la CPU con el mismo criterio. También dejan de guardar la clave del generador en la pila, donde podía acabar en un volcado.
Se busca que el RNG sea predecible: predecible en su funcionamiento, conservador en sus fuentes y sin estados intermedios que se puedan filtrar. La contrapartida es que el código cambia mucho y hay que revisarlo con cuidado, porque un error aquí afecta a todo el sistema.
El generador mantiene una clave por CPU y mezcla las fuentes en un orden definido; el cambio busca que un atacante no pueda forzar un estado conocido aunque controle parte de la entropía. El RNG nuevo también cambia la forma de arrancar: en lugar de bloquear hasta tener entropía, el kernel siembra con lo que hay y sigue mezclando. Para una máquina virtual clonada, el hipervisor debe aportar un identificador distinto; si no, dos instancias pueden compartir el estado inicial. Los límites: la calidad de la aleatoriedad depende de que el hardware y el firmware aporten entropía; en una máquina virtual clonada, dos instancias pueden arrancar con el mismo estado si el hipervisor no lo evita.
10. El salseo: Intel SDSi, funciones bajo licencia
5.18 incluye el driver de Intel Software Defined Silicon (SDSi), y con él llegó una discusión que sigue viva. SDSi permite a Intel vender licencias que activan funciones del procesador que el hardware ya tiene pero que están desactivadas: el cliente compra una capacidad y recibe un certificado que la habilita.
La comunidad lo interpretó como un paso hacia el «hardware como servicio»: compras la CPU, pero no todo lo que puede hacer. LWN lo analizó en Thoughts on software-defined silicon y señaló el riesgo de perder control sobre el hardware que ya has pagado. Intel defendió el modelo como una forma de vender configuraciones flexibles sin fabricar chips distintos.
En la lista, los maintainers aceptaron el driver porque la interfaz es pequeña y no cambia el resto del kernel; el debate fue sobre el modelo, no sobre el código. Intel publicó después una herramienta de usuario para gestionar las licencias, y el asunto volvió con más fuerza cuando puso precio a funciones en 2023. El driver en sí no toma partido; el modelo de negocio, sí: el kernel solo expone la interfaz para que el sistema operativo pueda hablar con el mecanismo. Aun así, la discusión dejó una pregunta que volvió en 6.2, cuando Intel puso precio a algunas funciones: hasta dónde puede llegar el software propietario dentro de un kernel libre. La historia completa está en Linux 6.2.
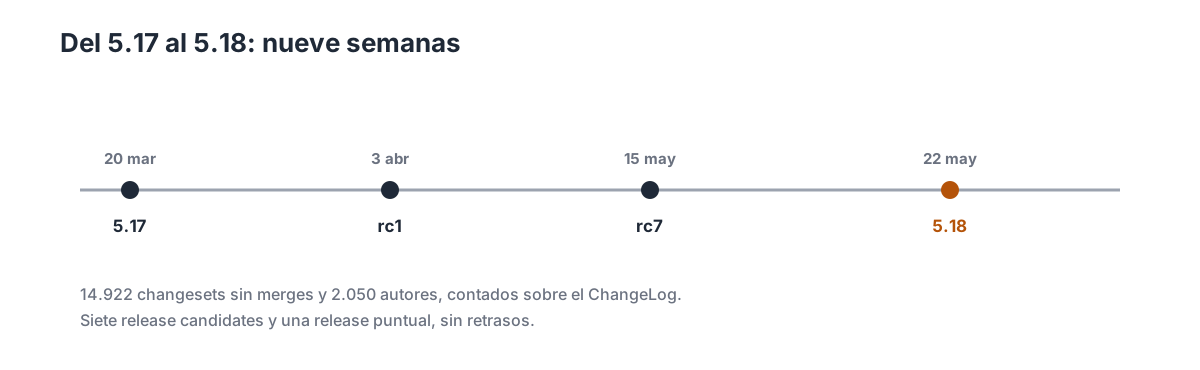
Nueve semanas de ciclo, con siete release candidates y una release puntual.
11. Por subsistemas
11.1 Core y herramientas
io_uring añade mensajes entre anillos y poll de NAPI sobre sockets, y la tabla de ficheros compartida se gestiona con menos contención. statx se declara estable, y el kernel puede volcar las pilas de todas las CPU en un pánico.
11.2 Sistemas de ficheros
Los sistemas de ficheros en red también se mueven: NFS gana el atributo de preservar el fichero tras el unlink, y Ceph expone la latencia media por operación. Btrfs añade DUP de metadatos en modo zoned y prepara el árbol de extensiones v2; F2FS estrena políticas de IPU y F2FS_UNFAIR_RWSEM, Además, se depreca ReiserFS.
11.3 Memoria
MADV_DONTNEED funciona en páginas hugetlb, KASAN puede etiquetar vmalloc, KFENCE se puede reactivar tras el arranque y memcg expone la memoria de kernel por grupo. El balanceo NUMA mejora la colocación en sistemas con niveles, y los folios siguen convirtiendo el código.
11.4 Bloque
El bloque admite E/S directa con fscrypt y blk-crypto, integridad de 64 bits y polling de bio en dm. Se retira el seguimiento de congestión y se depreca la carga por dev_t.
11.5 Red y virtualización
La virtualización también recibe la notificación de fork de la VM para que el RNG no repita estado, y el servicio akcipher para cifrado asimétrico en virtio-crypto. virtio-net gana RSS, vmgenid avisa al RNG del fork de una máquina virtual, y virtio-crypto estrena akcipher. KVM zapea solo las raíces obsoletas, y vDPA añade dos ioctls genéricos.
11.6 Seguridad
Además de IBT y FORTIFY_SOURCE, el RNG cambia su criptografía y añade aritmética saturante para size_t. Se desactiva HARDENED_USERCOPY_PAGESPAN, pendiente de reemplazo.
11.7 Arquitecturas
En ARM64, la lista de placas crece con modelos de Qualcomm, MediaTek y Rockchip, sobre todo para tablets y placas de desarrollo; el soporte de servidores sigue dependiendo del firmware. ARM64 recibe placas y SoC nuevos de Qualcomm, MediaTek y Rockchip, y RISC-V avanza con un marco para extensiones del ISA y perf con SBI PMU. En x86, además de IBT, entra el driver SDSi y se limpian parámetros de arranque antiguos.
11.8 Gráficos y plataformas
amdgpu activa FreeSync por defecto y i915 añade el subplataforma DG2-G12 y la migración acelerada. La Surface Pro 8 y la Surface Go 3 suman soporte de plataforma.
12. Lo que no llega
IBT necesita hardware CET y binarios compilados con endbr64: en 2022 eso era una minoría de equipos. SDSi necesita CPU Intel con el mecanismo y un certificado que se compra; sin licencia, las funciones siguen apagadas. user_events es nuevo y las bibliotecas tardaron en adoptarlo.
El reflink entre montajes tampoco resuelve la deduplicación entre sistemas de ficheros distintos: sigue siendo una operación dentro del mismo Btrfs. DAMON y DAMOS requieren configuración y conocimiento de la carga. El reflink entre montajes y la E/S comprimida de Btrfs solo funcionan en Btrfs, y con cuidado. Y 5.18 no es LTS: la LTS actual es 5.15, y la próxima LTS será 6.1.
13. Cambios menores
Core
- RT_MUTEXES — activos por defecto en PREEMPT_RT.
- -Warray-bounds — avisos de acceso fuera de rango.
- -Wzero-length-bounds — avisos de arrays vacíos.
- scheduler build — cabeceras que reducen el tiempo de compilación.
- DWARF5 + BTF — combinación permitida.
- -Werror en x86 — los avisos paran el build.
Ficheros
- Btrfs log — extents preparados antes del candado.
- Btrfs fsync — deja de copiar extents viejos.
- F2FS idmap — montajes con idmap.
- F2FS checkpoint — sysfs para forzarlo en
fsync(). - F2FS whint — se retira
whint_mode. - NFS 4.1 —
PRESERVER_UNLINKED. - ext4 fast_commit — más rendimiento y escalabilidad.
- Ceph getvxattr — atributos virtuales.
Memoria
- timer diferible — DAMON en sistemas con batería.
- tty memcg — objetos de tty contabilizados.
- memory.high — aplicación más estricta.
Networking
- rseq 32 bits — se corrige el layout de la UAPI.
- UAPI con Clang —
--targetpara cross-compilar.
14. Qué viene después
La merge window de 5.19 se abre el 23 de mayo y cierra el 5 de junio. Ese ciclo traerá SEV-SNP y TDX en el invitado, jumbogramas IPv6, LoongArch y el reclamo proactivo por memcg; Linux 5.19 sale el 31 de julio, y LWN cubrió la ventana de 5.18 en dos partes.
Para las distribuciones, 5.18 es la release de primavera: Ubuntu 22.10 y Fedora 36 la adoptan, y las rolling la tienen en semanas. La LTS sigue siendo 5.15 hasta que 6.1 tome el relevo.
Las próximas releases dirán si user_events sustituye a los mecanismos caseros de traza y si DAMON se usa fuera de los laboratorios. También se verá si el modelo de Intel SDSi se queda en un caso aislado o se copia en otras plataformas. Tampoco hay fecha para que IBT llegue a todos los equipos.
15. Referencias
- KernelNewbies: Linux 5.18 — inventario completo por subsistema.
- ChangeLog-5.18 — la lista completa de commits.
- Phoronix: Linux 5.18 Released — repaso de hardware y rendimiento.
- Phoronix: Linux 5.18 features — repaso de las novedades del ciclo.
- kernel.org: releases — calendario y LTS.