Linux 5.19: SEV-SNP, jumbogramas y una arquitectura nueva
SEV-SNP y TDX abren la virtualización privada, IPv6 estrena jumbogramas y LoongArch entra en el tree. La release que se retrasó una semana por Retbleed.
Linux 5.19 se ha publicado hoy, 31 de julio de 2022, con soporte de invitado para SEV-SNP de AMD y TDX de Intel, jumbogramas IPv6 de más de 64 KB y una arquitectura nueva, LoongArch. El ciclo deja 15.134 changesets y 2.086 desarrolladores, récord de participación, y llega una semana tarde por las mitigaciones de Retbleed. Es la última release de la serie 5: la siguiente se llamará 6.0.
Torvalds lo anunció desde un sitio poco habitual: «un MacBook Air con M2 y Asahi Linux», según The Register, que tituló la noticia con su descripción de Arm como plataforma «usable as a development platform». La release sale el domingo 31 de julio de 2022, diez semanas después de 5.18 y dentro de la serie 5.x; la merge window de 6.0 se abre al día siguiente.
El ciclo es el más concurrido desde 5.13: 15.134 changesets sin contar merges, 2.086 desarrolladores —récord absoluto— y 278 novatos, según las estadísticas de LWN. Intel firma 1.645 changesets (10,9 %), el trabajo sin empresa 1.135 (7,5 %), Linaro 862 (5,7 %), AMD 837 (5,5 %), Red Hat 792 (5,2 %) y Google 624 (4,1 %). Krzysztof Kozlowski encabeza la lista individual con 211, casi todo device trees; le siguen Christoph Hellwig, con 193, y Ville Syrjälä, con 175.
Hay tres claves. La primera es la virtualización privada: SEV-SNP y TDX llegan al invitado, con lo que una máquina virtual puede demostrar que el hipervisor no ve su memoria. La segunda es la red: IPv6 admite jumbogramas de hasta 1 MB en el host. La tercera es la arquitectura nueva: LoongArch entra en el tree con CPU, placas y toolchain.
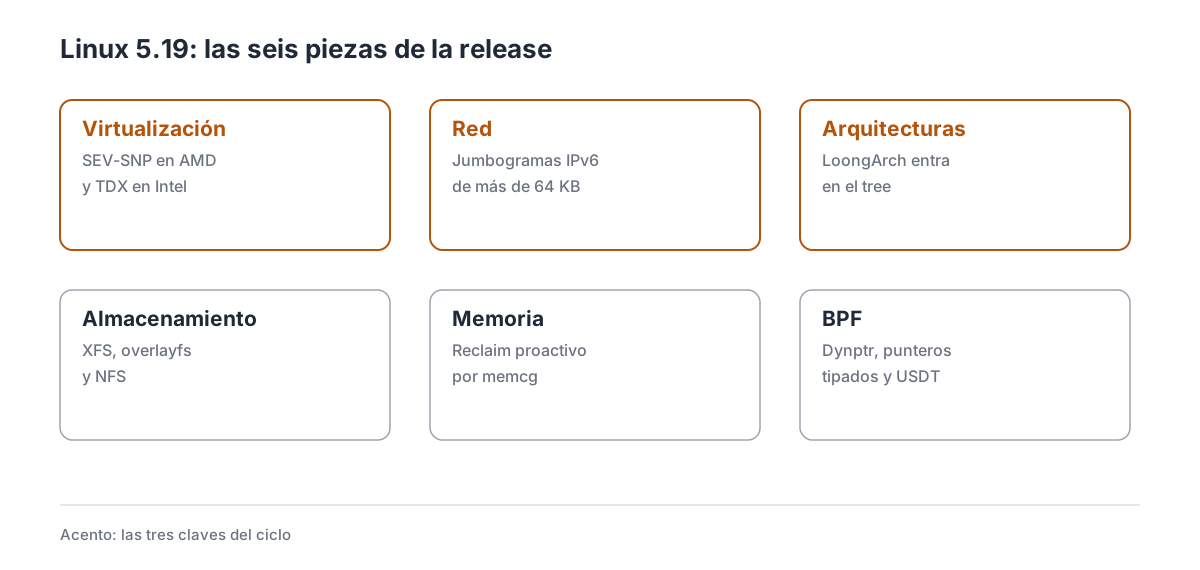
Las seis piezas del ciclo, con las tres claves marcadas en ámbar.
1. Las cifras de un ciclo récord
| Dato | Valor |
|---|---|
| Fecha de release | 31 de julio de 2022 |
| Versión anterior | 5.18 (22 de mayo de 2022) |
| Merge window | 23 de mayo al 5 de junio de 2022 |
| Release candidates | 8 |
| Changesets | 15.134 |
| Desarrolladores | 2.086 |
| Novatos | 278 |
| Líneas netas | +804.000 |
El ciclo añade 1.105.000 líneas y retira 301.000, casi todas de drivers viejos y de la arquitectura h8300, que desaparece. El resultado neto son 804.000 líneas más, una cifra que se debe al código nuevo de LoongArch y por las cabeceras de las GPU.
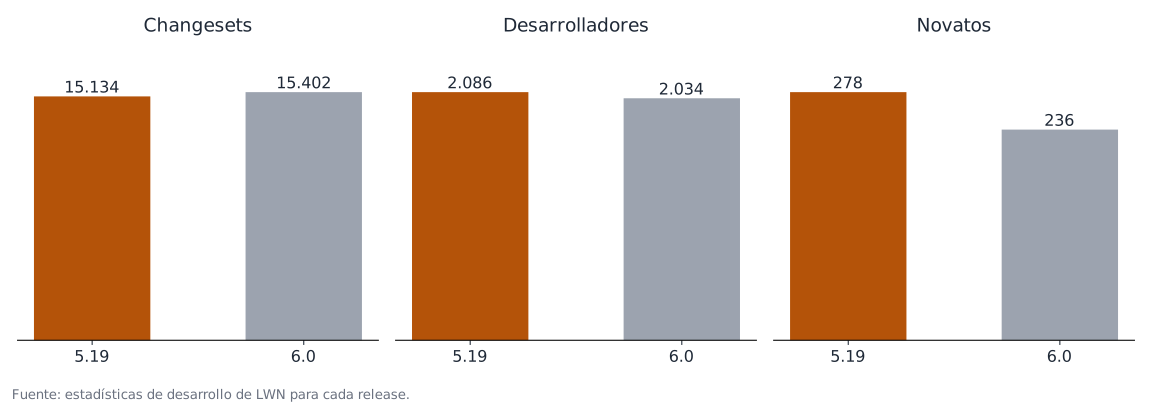
El ciclo de 5.19 comparado con 6.0, según las estadísticas de LWN.
La retirada de h8300 y de varios drivers antiguos explica el otro dato del ciclo: 301.000 líneas menos. Es una limpieza que no se ve en las notas de la release, pero que reduce el trabajo de compilación y de mantenimiento. Los 2.086 desarrolladores son el récord que 6.0 no alcanza: el ciclo de verano movilizó a más gente que el de otoño, y los 278 novatos confirman que el proyecto sigue atrayendo contribuciones nuevas. La contrapartida es que la revisión la siguen haciendo los mismos maintainers.
2. El salseo: Retbleed retrasa la release
Linux 5.19 no salió el 24 de julio, como tocaba. La causa fue Retbleed, una variante de Spectre que afecta a las predicciones de retorno en procesadores AMD e Intel y que obligó a reescribir parte de las mitigaciones a mitad de ciclo. Las correcciones llegaron tarde, el árbol no terminaba de estabilizarse y Torvalds prefirió una semana más de rc8 antes que publicar con prisas. LWN lo resume en la crónica del ciclo: «after a one-week delay to deal with the fallout from the Retbleed mitigations».
El otro ingrediente es menos técnico: Torvalds publicó la release desde un MacBook Air con M2 y Asahi Linux, la distribución que lleva Linux a Apple Silicon. No hubo ningún gesto publicitario: llevaba semanas usándolo como máquina principal y lo contó en el anuncio. La prensa lo tituló como un respaldo a Arm y a Asahi, y el proyecto lo celebró como una señal de que el port ya sirve para trabajar.
Retbleed tiene dos CVE, el 2022-29900 para AMD y el 2022-29901 para Intel, y las mitigaciones no son gratis: en algunos modelos cuestan entre el 5 % y el 30 % de rendimiento según la carga. El retraso de una semana sirvió para que las correcciones convivieran con el resto del ciclo sin romper el arranque en las máquinas afectadas.
El calendario también quedó marcado: la rc8 sirvió para probar las mitigaciones en máquinas reales, y las distribuciones que congelaban kernel en agosto se encontraron con la release y los parches de Retbleed a la vez. No hubo pelea de maintainers: el retraso se decidió, se comunicó y se aceptó. El salseo del ciclo junta una vulnerabilidad de CPU con un port de Apple Silicon que, hace dos años, no existía.
3. SEV-SNP y TDX: la memoria que el hipervisor no ve
La virtualización privada lleva años en el hardware y no acababa de llegar al kernel. 5.19 da el paso en los dos lados del mercado: AMD con SEV-SNP en el invitado e Intel con TDX. La idea es la misma: el invitado cifra su memoria con claves que el hipervisor no tiene, y el hardware impone reglas para que el host no pueda leerla ni modificarla sin que el invitado lo note.
El invitado arranca con una memoria que no es suya hasta que la acepta: el host le da páginas, el firmware las mide y el kernel del invitado decide cuáles incorpora a su dirección física. Ese intercambio es lo que permite que el host no pueda inyectar datos en el invitado sin que este lo sepa. SEV-SNP añade a SEV-ES una tabla inversa de páginas (RMP) que registra el estado de cada página del invitado. El kernel del invitado usa esa tabla para aceptar memoria, validar que una página sigue siendo suya y detectar ataques de replay o de reasignación. TDX hace lo equivalente con los módulos de confianza de Intel, y 5.19 incluye la base para arrancar un invitado TDX y gestionar sus páginas privadas.
El invitado también puede pedir un informe de atestación firmado por el hardware, que un servicio remoto valida antes de mandarle secretos. Ese informe incluye el hash del kernel y de los módulos cargados, así que el proveedor no puede cambiar el software del invitado sin que el servicio lo detecte.
El cambio afecta a la confianza, no al rendimiento: un banco que ejecuta una carga en una máquina virtual de un proveedor puede, en teoría, demostrar que el proveedor no ve los datos. La contrapartida es el coste: aceptar páginas, cambiar su estado y salir a pedir al host cada vez que el invitado necesita memoria nueva.
El modelo de amenaza tiene un supuesto incómodo: el hardware y el firmware del fabricante siguen siendo de confianza. La atestación demuestra que el invitado corre el software que dice, pero no que el propio procesador sea honesto; por eso la computación privada se presenta como una reducción de superficie, no como una garantía absoluta. Los límites: SEV-SNP necesita EPYC con la extensión y firmware actualizado; TDX necesita CPU Intel con el módulo y un hipervisor que lo soporte, y en 2022 eso era escaso. La documentación de SEV y la de TDX explican el modelo.
4. Jumbogramas IPv6: más de 64 KB por paquete
TCP tiene un límite histórico de 64 KB por trama, y en redes de 100 Gbps eso obliga a procesar millones de paquetes por segundo. BIG TCP lo rompe, pero hasta ahora solo en el camino de recepción y con limitaciones; 5.19 añade la segmentación de TCPv6 con super-segmentos mayores de 64 KB usando la cabecera de fragmentación de IPv6.
El resultado es que el host puede entregar a la tarjeta un bloque de hasta 1 MB, y la tarjeta lo segmenta en tramas del tamaño de la MTU. La pila procesa menos paquetes por byte y el coste por Gbps baja. La documentación de networking recoge las opciones.
El ajuste se hace con ip link, subiendo el tamaño máximo de GSO de la interfaz; el kernel comprueba que el hardware lo admite antes de aceptar el valor. El beneficio se ve en servidores grandes y en máquinas virtuales con virtio, donde el coste por paquete pesa. La contrapartida es que la red intermedia tiene que aguantar los fragmentos y que el ajuste se hace por interfaz, no de forma global.
El cambio también ahorra memoria en los búferes de la pila: menos skbs por megabyte, menos estructuras que reservar y liberar. En pruebas de la época, un flujo con jumbogramas reducía el coste de CPU por gigabit de forma notable en servidores con tarjetas de 100 Gbps. Los límites: BIG TCP necesita IPv6 y hardware que lo admita, y no todos los switches lo tratan igual. En una red con un salto que no lo admite, el rendimiento puede caer por debajo del de antes.
5. LoongArch: una arquitectura nueva en el árbol
LoongArch es la arquitectura de Loongson, sucesora de MIPS en sus procesadores. No es una variante de MIPS ni de RISC-V, sino un ISA nuevo, con instrucciones propias, y 5.19 añade el soporte básico para arrancar en hardware real y en emulación.
El código entra con lo mínimo: arranque, manejo de excepciones, MMU, tiempo, interrupciones y un conjunto de drivers de plataforma. También entra la toolchain, que en 2022 solo estaba en la rama de desarrollo de GCC y LLVM. La documentación de LoongArch describe el estado.
El soporte inicial cubre una CPU y una placa concretas, con UEFI y ACPI, y deja fuera a propósito todo lo que no estaba probado. Una arquitectura nueva es una apuesta a largo plazo: el kernel puede admitirla, pero hacen falta distribuciones, compiladores, bibliotecas y hardware asequible. LoongArch tiene ventaja sobre otras aventuras porque Loongson fabrica las CPU y financia el trabajo, y porque el diseño es más convencional que el de otras arquitecturas que fracasaron.
El modelo de arranque es UEFI con ACPI, más cercano a ARM64 que a MIPS, y el kernel elige entre varias páginas y modos de dirección. Esa familiaridad ayuda a que los drivers se porten, pero no evita el trabajo de escribir los que faltan. Los límites: en 5.19 no hay soporte de virtualización, ni de perf completo, ni de todos los periféricos. Quien tenga una placa Loongson se encontrará con un sistema que arranca y poco más.
6. XFS, overlayfs y NFS: los sistemas de ficheros
XFS acumula años de trabajo en metadatos y 5.19 le da dos piezas grandes. La primera es el recuento de extensiones ampliado: elimina los límites que impedían guardar cientos de millones de extensiones en un fichero, algo que aparecía en cargas con ficheros muy fragmentados. La segunda es el registro y replay de atributos, un cambio de fondo en cómo XFS modifica los atributos extendidos, que pasan por el log en lugar de escribirse en su sitio.
Overlayfs admite capas con idmap: un contenedor con un rango de UIDs distinto puede montar capas y ver los permisos correctos, sin trucos en el espacio de usuario. Es la pieza que faltaba para que las imágenes de contenedor con usuarios no root funcionen sin fricción.
En NFS, el servidor estrena el Courteous Server: en lugar de revocar el estado de un cliente que dejó de responder, espera y le deja reconectar, con lo que se evitan errores en clientes que se suspenden o cambian de red. La documentación de XFS y la de NFS tienen el detalle.
El registro de atributos de XFS es la parte más delicada del ciclo: durante años, los atributos se escribían directamente en el bloque y un fallo a mitad podía dejar el tree inconsistente; ahora pasan por el log como el resto de metadatos, y el replay los reconstruye. Lo que tienen en común es la escala: ficheros más grandes, contenedores con más usuarios y clientes que se mueven. El Courteous Server también reduce el ruido en los clientes: un portátil que se suspende y vuelve a la red ya no recibe errores de estado caducado, porque el servidor guarda su estado durante un tiempo configurable. Los límites: el idmap de overlayfs necesita que el sistema de ficheros base lo soporte, y el Courteous Server cambia el comportamiento ante clientes caídos.
7. Reclaim proactivo en los cgroups de memoria
El kernel reclama memoria cuando se queda sin ella: recorre las listas, expulsa páginas y, si hace falta, manda al swap. Ese modelo reactivo funciona, pero llega tarde: cuando el sistema empieza a reclamar, la latencia ya se ha resentido.
5.19 añade reclaim proactivo por memcg: un proceso de espacio de usuario puede pedir al kernel que libere una cantidad concreta de memoria de un cgroup, y el kernel lo hace en segundo plano. El caso de uso son contenedores con límites: en lugar de esperar a que el OOM killer actúe, el orquestador pide «libérame 200 MB» y el kernel reacciona.
La interfaz es un fichero por cgroup, memory.reclaim, en el que se escribe la cantidad a liberar; el kernel responde con la memoria que consiguió y el proceso decide si insistir. Lo que cambia es quién decide: antes, el kernel; ahora, el sistema que conoce la carga. La contrapartida es que hay que implementar el reclaimer en el espacio de usuario y elegir cuándo pedir, algo que Kubernetes tardó en adoptar.
El mecanismo encaja con la idea de que el kernel no siempre sabe qué va a pasar: un orquestador que va a lanzar un lote de trabajos puede liberar memoria antes, y una base de datos que va a hacer una carga grande puede pedir que no se toque su caché. Los límites: el reclaim proactivo no funciona en todos los tipos de memoria ni con todos los backends de swap, y pedir demasiado puede provocar más E/S de la que se quería evitar. La documentación de cgroups describe los ficheros.
8. BPF: dynptr, punteros tipados y USDT
BPF gana tres piezas que cambian lo que se puede escribir. La primera son los punteros dinámicos: un bpf_dynptr describe un búfer cuya ubicación y tamaño no se conocen al compilar, y el verificador comprueba los accesos. La segunda son los punteros tipados en los mapas, que permiten guardar un puntero a un tipo concreto y que el verificador sepa qué hay al otro lado.
Los punteros tipados resuelven un problema clásico: un mapa guardaba un void * y el programa tenía que saber a qué apuntaba; ahora el mapa declara el tipo y el verificador comprueba el acceso en cada uso. La tercera es libbpf con USDT: los puntos de traza que las aplicaciones declaran en su código, como los de Node.js o Python, se pueden enganchar sin escribir el código de instrumentación a mano. Con eso, una herramienta de observabilidad puede trazar funciones de usuario con la misma comodidad que las del kernel.
También llegan los enlaces LINK_CREATE para programas de tracing, kfuncs en programas de syscall, iteradores de enlaces y la posibilidad de desactivar la carga automática de programas. LWN cubrió los dynptr en Dynamic pointers for BPF.
USDT merece un párrafo aparte: muchas aplicaciones (Node.js, Python, Ruby, bases de datos) publican sondas con una nota ELF y un probe con argumentos; libbpf lee esa nota, genera el programa y engancha la sonda sin que el usuario escriba el offset. La tendencia no cambia: más expresividad, más trabajo para el verificador. La otra cara es la compatibilidad: un programa que usa dynptr necesita un kernel que lo soporte y una versión de libbpf que lo entienda, y el código de BPF no avisa si se carga en un kernel antiguo; simplemente falla el verificador. Los límites: los dynptr no sustituyen a la validación de la aplicación, y USDT depende de que el binario tenga las sondas declaradas y no esté ofuscado.
9. Firmware ZSTD, IFS y hardware nuevo
El firmware del kernel se comprime con XZ desde hace años, y 5.19 añade soporte de ZSTD: los ficheros .zst se descomprimen más rápido que XZ y ocupan algo más, un intercambio que importa en el arranque de móviles y de dispositivos embebidos. También se puede pedir la carga del firmware desde espacio de usuario, sin esperar a que un driver la solicite.
En x86, Intel estrena el driver de In Field Scan: ejecuta pruebas de los circuitos de la CPU en producción, algo pensado para flotas de servidores que quieren detectar fallos antes de que provoquen un crash. Y los split locks se penalizan: una aplicación que hace operaciones atómicas a caballo entre dos líneas de caché va a notar que el kernel la frena, porque esa operación bloquea el bus.
En almacenamiento, el kernel gana el driver nvme-apple, que da soporte al controlador NVMe de los Mac con Apple Silicon; es una de las piezas que Asahi necesitaba para que el disco funcionara a velocidad completa. La documentación de firmware recoge el modelo de carga.
El firmware comprimido con ZSTD se descomprime en el propio kernel con el descompresor que ya está en el tree, así que no hace falta cargar una biblioteca ni un usuario que lo haga. Son mejoras de plataforma: el usuario no las ve, pero explican por qué un portátil arranca antes o por qué un servidor detecta un fallo. El driver nvme-apple es la muestra de que el trabajo de Asahi entra en mainline por partes: primero el SoC, luego el disco, después la GPU. Cada pieza se revisa como cualquier otra y se queda en el tree cuando está lista. Los límites: ZSTD necesita firmware reempaquetado, IFS solo funciona en CPU Intel recientes y nvme-apple requiere hardware Apple.
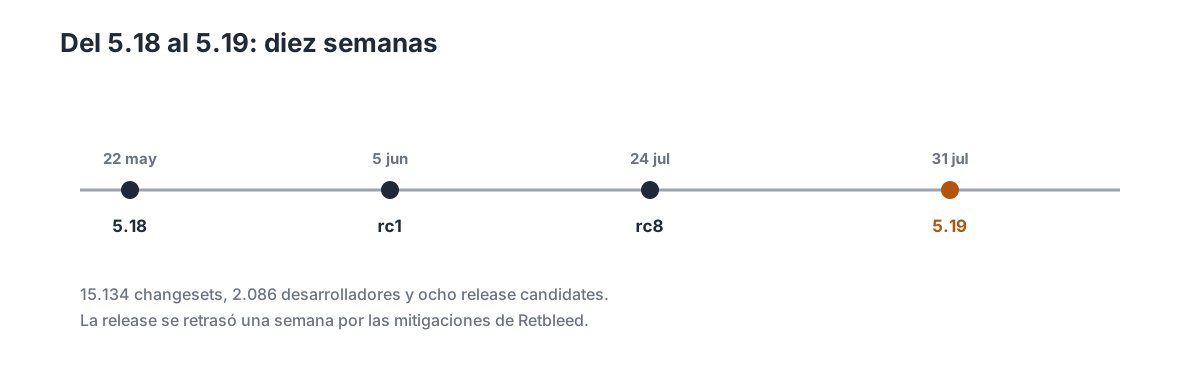
Diez semanas de ciclo, con ocho release candidates y una semana extra por Retbleed.
10. Por subsistemas
10.1 Core e io_uring
io_uring estrena multishot de poll, CQE grandes de 32 bytes, soporte de xattr, búferes dispersos y más tipos de cancelación. También llega el passthrough de NVMe, que permite mandar comandos al disco desde el anillo, y las operaciones socket(2).
10.2 Sistemas de ficheros
Btrfs mejora la E/S directa con nowait y el rendimiento de NOCOW, permite desfragmentar extents inline y admite más tamaños de página en subpage. También puede reclamar grupos de bloque automáticamente. EROFS añade lectura bajo demanda con fscache, y CIFS estrena la opción nosparse.
10.3 Memoria
Los folios siguen avanzando: conversión de alloc_pages_vma(), read_folio y zswap con contabilidad por cgroup. DAMON permite saber qué operaciones admite y ajustarse en línea, y mprotect() evita TLB flushes innecesarios. La serie de arreglos de COW cierra un problema de seguridad de años.
10.4 Bloque
virtio-blk admite polling de E/S y queue_rqs(), zram estrena el modo huge_idle para escribir a disco páginas enormes poco usadas, y loop puede usar particiones sin escanear. La ioctl de giro del CD-ROM queda obsoleta.
10.5 Red
Además de los jumbogramas, la pila añade razones de descarte a ICMP y a IP, la opción SO_RCVMARK, una segunda tabla de bind por puerto y dirección, y el sysctl skb_defer_max. MPTCP gana la base para un path manager en espacio de usuario.
10.6 Virtualización y seguridad
KVM añade aceleración de eventos de Xen, vDPA admite el VQ de control y Xen mejora dom0less. Landlock estrena el derecho LANDLOCK_ACCESS_FS_REFER para renombrar y enlazar con control, IMA puede incluir digests de fs-verity, las claves de confianza admiten CAAM de NXP y randstruct funciona con Clang.
10.7 Arquitecturas
ARM64 recibe el SoC Renesas RZ/V2M, el R-Car V4H, el MediaTek MT8195 y el NXP i.MXRT1050, además de decenas de placas. En x86 se retiran parámetros de arranque obsoletos como nosmap, noclflush y noexec, y desaparece la arquitectura h8300.
10.8 Gráficos y plataformas
i915 añade los PCI IDs de Raptor Lake-P y Raptor Lake-S, el soporte de Tile4 en DG2 y la descompresión de render y media, además de DRRS estático y HDR en DisplayPort. Surface Pro 8 y varios portátiles suman soporte de plataforma.
11. Lo que no llega
LoongArch arranca, aunque le falta mucho para ser una plataforma completa: faltan virtualización, perf y muchos drivers, y en 2022 no hay distribución que lo instale. SEV-SNP y TDX necesitan hardware y firmware concretos, y el soporte del host llega en releases posteriores. Los jumbogramas IPv6 dependen de la red intermedia.
El reclaim proactivo necesita un reclaimer en espacio de usuario; Kubernetes tardó en tenerlo. XFS sigue sin poder repararse en línea, y el Courteous Server cambia el comportamiento con clientes caídos. Y 5.19 no es LTS: la LTS actual es 5.15, y la siguiente será 6.1. Quien necesite una LTS tiene que esperar a diciembre o quedarse en 5.15, que sigue recibiendo correcciones.
12. Cambios menores
Core
- CQE descartada — io_uring avisa si pierde una completación.
- task_work sin IPI — señalización cooperativa.
MSG_WAITALL— ensend/sendmsg.- ticket spinlocks — locks justos y genéricos.
- console_lock — consolas que imprimen en paralelo.
Ficheros
- Btrfs tree-checker — comprueba el dueño del extent buffer.
- Btrfs num_devices — repara el superbloque.
- exFAT sys_tz — zona horaria del sistema.
- F2FS mmap — compresión en
compress_mode=user. - FAT statx — hora de creación.
Plataformas
- módulo texto/datos — asignación separada.
- ubicación física — sysfs para la posición del dispositivo.
- async_probe — comodín en la línea de órdenes.
- thermal tools — biblioteca y herramientas.
Herramientas
- objtool — reescritura de la interfaz.
W=e— el build aborta con avisos.- nolibc — más funciones y ficheros separados.
13. Qué viene después
La merge window de 6.0 se abre el 1 de agosto y cierra el 14. Ese ciclo traerá io_uring con búfer asíncrono, RV, Btrfs send v2, SGX2 y el cambio de número; Linux 6.0 sale el 2 de octubre, y LWN cubrió la ventana de 5.19 en su primera parte.
Para las distribuciones, 5.19 es la release de verano: Ubuntu 22.10 y Fedora 37 la adoptan, y las rolling la tienen en semanas. La LTS sigue siendo 5.15 hasta que 6.1 tome el relevo, así que muchas imágenes de servidor no verán 5.19.
Habrá que esperar a las siguientes releases para saber si LoongArch encuentra un ecosistema y si la virtualización privada se usa fuera de los hipervisores comerciales. Tampoco hay fecha para que el soporte de TDX en el host llegue al árbol.
14. Referencias
- KernelNewbies: Linux 5.19 — inventario completo por subsistema.
- ChangeLog-5.19 — la lista completa de commits.
- Phoronix: Linux 5.19 Released — resumen de hardware y rendimiento.
- Phoronix: Linux 5.19 features — repaso de las novedades del ciclo.
- kernel.org: releases — calendario y LTS.