Linux 5.3: pidfd, uclamp y las GPU Navi
Linux 5.3 añade pidfd con poll, utilization clamping en el scheduler y soporte para las GPU AMD Navi. 14.605 changesets y 1.882 desarrolladores.
581 changesets más que 5.2: Linux 5.3 trae pidfd con poll, utilization clamping en el scheduler y soporte para las GPU AMD Navi. El ciclo suma 14.605 changesets y 1.882 desarrolladores.
La release sale el domingo 15 de septiembre de 2019, diez semanas después de 5.2 y dentro de la serie 5.x. El árbol necesitó ocho release candidates, uno más de lo habitual.
Las cifras de este post son las de la tabla acumulada de LWN, publicada en sus estadísticas de 5.11: 14.605 changesets y 1.882 desarrolladores. Es el ciclo más grande de la serie hasta ese momento, con más parches que 5.2.
Hay tres claves. La primera es los procesos: pidfd gana poll y se prepara para gestionar servicios sin race conditions. La segunda es el scheduler: uclamp deja fijar un mínimo y un máximo de rendimiento por tarea. La tercera es el hardware: Navi y los procesadores Zhaoxin entran en el tree.
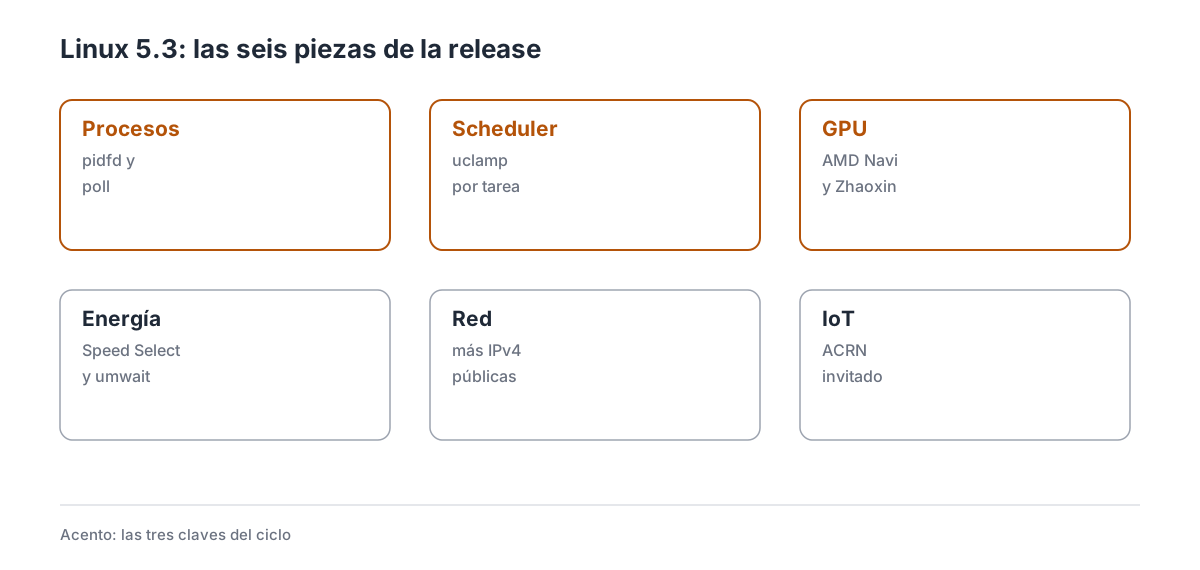
Las seis piezas que explican el ciclo, con las tres claves marcadas en ámbar.
1. Las cifras de un ciclo grande
| Dato | Valor |
|---|---|
| Fecha de release | 15 de septiembre de 2019 |
| Versión anterior | 5.2 (7 de julio de 2019) |
| Merge window | 8 al 21 de julio de 2019 |
| Release candidates | 8 |
| Changesets | 14.605 |
| Desarrolladores | 1.882 |
El ciclo supera en 581 changesets a 5.2 y en 80 desarrolladores, y se queda a 14 parches del récord de 5.4. Es un ciclo amplio, con drivers de GPU y plataformas nuevas, y con trabajo de scheduler y procesos.
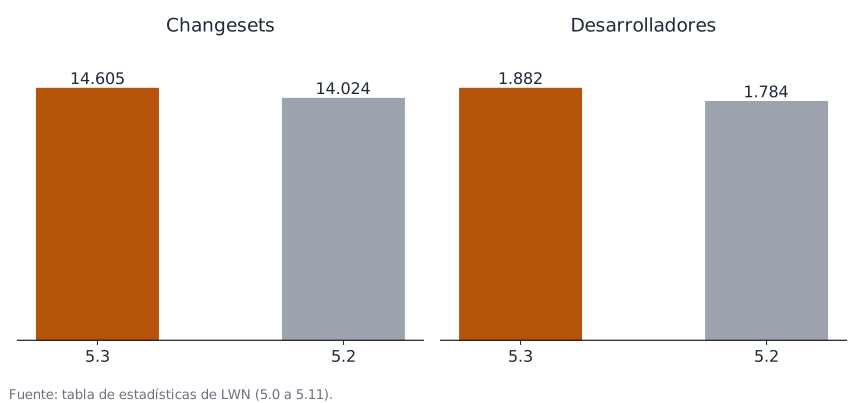
Las dos releases comparadas con la tabla de LWN, que no cuenta los merges.
El reparto por empresas sigue el patrón de la serie: Intel, Red Hat, Google, AMD y Linaro. El trabajo se reparte entre AMD con Navi y Intel con Speed Select y umwait.
2. pidfd: esperar un proceso sin race conditions
Un PID se puede reutilizar: si un proceso muere y el sistema asigna su número a otro, una señal enviada al PID antiguo acaba en el proceso equivocado. Los pidfd resuelven el problema porque identifican al proceso, no al número.
5.3 añade poll a los pidfd: un gestor de servicios puede esperar en varios pidfd a la vez con epoll, sin bloquearse ni sondear. Además, pidfd_open(2) permite obtener el descriptor de un proceso a partir de su PID, con lo que el gestor no necesita ser su padre.
El caso de uso son los sistemas de inicio y los contenedores: systemd y los runtimes pueden vigilar procesos sin waitpid ni señales. Los límites: pidfd_open necesita permisos sobre el proceso y el descriptor no evita que el proceso muera; solo identifica. La documentación de pidfd describe la API.
3. uclamp: mínimo y máximo de rendimiento por tarea
El scheduler reparte CPU según la utilización, pero no sabía que una tarea necesita un mínimo para cumplir su latencia ni que otra no debe pasar de un máximo para no gastar batería.
Utilization clamping añade dos valores por tarea: util_min y util_max, que el scheduler respeta al elegir frecuencia y núcleo. Una tarea interactiva puede pedir un mínimo; una de fondo, un máximo.
Android usa uclamp para dar a la interfaz un mínimo de rendimiento y limitar las tareas de sincronización; el scheduler lo combina con su modelo de energía para pedir la frecuencia adecuada. El beneficio se nota en móviles y portátiles: el sistema puede dar prioridad a la interfaz sin subir la frecuencia de todo, y limitar el consumo de un proceso de sincronización. Los límites: el clamping es una pista, no una garantía, y su configuración requiere conocer la carga. La documentación de uclamp describe el modelo.
4. AMD Navi y Zhaoxin
El ciclo añade soporte para las GPU AMD Navi (RDNA), la arquitectura que llegó con las RX 5700: el driver amdgpu reconoce los chips y cubre display y parte de cálculo. También entra el HDR por metadatos en DRM para AMD e Intel.
En CPU, el ciclo añade los procesadores Zhaoxin, basados en la arquitectura Centaur y usados en equipos de bajo consumo en China. También llega el Speed Select de Intel para ajustar la potencia por núcleo.
El ciclo también añade el soporte de AVX-512 BFLOAT16 para cálculo numérico y la topología multi-die, que el scheduler usa para no mover tareas entre dies. El patrón es el de siempre: el kernel reconoce el hardware antes de que llegue a las tiendas. Los límites: Navi necesita firmware actualizado y Mesa reciente; Zhaoxin es soporte de nicho. La documentación de DRM describe el modelo.
5. umwait: esperar sin gastar CPU
Las instrucciones umonitor, umwait y tpause de Intel permiten a un proceso esperar en espacio de usuario con un temporizador del hardware, sin entrar al kernel ni girar en un bucle.
5.3 las habilita con un control que decide si el proceso puede usarlas y cuánto tiempo máximo. El caso de uso son las bibliotecas de sincronización y los servidores de baja latencia: un spinlock puede esperar en el hardware en vez de quemar ciclos.
El beneficio es la eficiencia: esperar con umwait consume menos energía que un bucle y menos latencia que dormir. Los límites: necesita CPU Intel con la extensión y el sistema decide si la permite; en un servidor compartido puede no estar disponible. La documentación de x86 recoge las instrucciones.
6. Más direcciones IPv4 y ACRN
Dos piezas de red y virtualización. 5.3 permite usar 0.0.0.0/8 como rango válido, con lo que se recuperan millones de direcciones que estaban reservadas y se pueden usar en redes privadas.
ACRN es un hipervisor de tipo 1 para IoT: el ciclo añade el soporte de invitado, con lo que Linux puede ejecutarse en él en placas embebidas.
El rango 0.0.0.0/8 se reservó en los primeros días de IPv4 y muchas pilas lo tratan como inválido; 5.3 lo habilita para redes privadas y de laboratorio. Las dos amplían el espacio disponible: direcciones para redes y una plataforma para dispositivos. Los límites: usar 0.0.0.0/8 rompe suposiciones antiguas y requiere cuidado; ACRN es un hipervisor específico con su propia pila. La documentación de red describe el modelo.
7. iocost y el resto de almacenamiento
La documentación de cgroups recoge el controlador.
El bloque añade mejoras y los drivers siguen entrando. dm recibe correcciones, NVMe suma hardware y los sistemas de ficheros ajustan su comportamiento con dispositivos rápidos.
El ciclo no tiene una feature de almacenamiento que destaque: el trabajo se reparte entre correcciones y soporte de hardware, como corresponde a una release de mitad de año.
8. Ficheros: XFS, cgroup writeback y Btrfs
XFS estrena los ioctls BULKSTAT e INUMBERS, que devuelven los metadatos de muchos inodos en una sola llamada y con un formato que incluye las features del sistema de ficheros. Herramientas como xfs_quota o los backups dejan de recorrer inodo a inodo.
El ciclo también prepara los recorridos de inodos multihilo, con lo que un quotacheck grande puede usar varios núcleos, y añade writeback consciente del cgroup: la E/S sucia se carga al grupo que la generó, no al que la escribe.
Btrfs detecta la implementación rápida de CRC32C en todas las arquitecturas, con lo que la comprobación de bloques usa instrucciones del procesador donde existen.
Las piezas son de escala: menos llamadas, más hilos y contabilidad correcta. Los límites: BULKSTAT necesita herramientas adaptadas; el writeback por cgroup depende de la jerarquía. La documentación de XFS describe los ioctls.
9. Memoria: init_on_alloc y contabilidad
init_on_alloc e init_on_free permiten que el kernel ponga a cero la memoria al asignarla o al liberarla. Es una mitigación contra el uso de datos residuales: un malloc no puede leer lo que dejó otro proceso.
DEBUG_PAGEALLOC reduce su sobrecarga cuando está compilado pero inactivo, y dma-buf da a cada búfer un inodo propio, con lo que se puede auditar quién lo tiene abierto desde /proc.
El controlador de memoria añade memcg_slabinfo en debugfs para ver el slab de cada grupo.
Las cuatro son de higiene: cero al asignar, menos coste de depuración y más visibilidad. Los límites: init_on_alloc cuesta CPU; memcg_slabinfo es de diagnóstico. La documentación de memoria recoge las opciones.
10. Virtualización: virtio-iommu y virtio-pmem
virtio-iommu es un IOMMU paravirtualizado: el invitado describe sus mapeos al host y el host los aplica, con lo que una máquina virtual puede usar dispositivos con DMA de forma segura sin un IOMMU físico dedicado.
virtio-pmem expone memoria persistente al invitado, y virtio_net activa NAPI en transmisión por defecto, que mejora el comportamiento de TCP en invitados con muchas colas. vhost acelera el acceso a metadatos, con una mejora de alrededor del 24 % en paquetes por segundo.
Las piezas acercan la VM al rendimiento nativo: DMA seguro, memoria persistente y red más rápida. Los límites: virtio-iommu necesita un hipervisor que lo implemente; pmem exige hardware o emulación. La documentación de virtio describe el modelo.
11. Claves y seguridad: namespaces y TPM
Las claves y los llaveros se vuelven conscientes del namespace: un contenedor puede tener su propio llavero sin ver el del host, y las ACL sustituyen al modelo de permisos antiguo. Un keyctl permite mover un enlace entre llaveros de forma atómica.
En integridad, IMA mide la línea de comandos del arranque en kexec y el TPM expone los registros de eventos TCG2 en sistemas EFI.
El beneficio es el aislamiento: claves por contenedor y arranque medido. Los límites: las ACL de claves necesitan herramientas nuevas; el TPM depende del firmware. La documentación de claves describe el modelo.
12. Red: nexthop objects y multipath
El kernel estrena nexthop objects: un objeto que describe un siguiente salto y se puede compartir entre rutas, en vez de repetir la misma información en cada una. Después llega su uso en rutas IPv4 e IPv6.
El multipath añade el hash sobre la capa 3 interna, con lo que el reparto de flujos mejora en túneles y encapsulaciones.
Un nexthop puede agrupar varios saltos con pesos y banderas, y las rutas solo guardan su identificador; cambiar el grupo no obliga a recorrer la tabla de rutas. El beneficio es la gestión: cambiar un nexthop actualiza todas las rutas que lo usan. Los límites: las herramientas tienen que crear los objetos; el hash interno requiere drivers compatibles. La documentación de red describe el modelo.
13. Bloque: dm-crypt y snapshots
dm-crypt añade el modo EBOIV, un vector de inicialización basado en el desplazamiento cifrado que evita patrones en discos con muchos bloques iguales. Los snapshots de device mapper permiten liberar espacio con discard, y nbd admite redimensionar por netlink sin reiniciar.
Las tres son de mantenimiento: cifrado más fuerte, snapshots que no crecen y discos de red flexibles. Los límites: EBOIV es un modo concreto que hay que elegir; el discard en snapshots depende del dispositivo. La documentación de dm-crypt describe los modos.
14. Gráficos: MCDE, Ingenic y HDR
DRM suma dos drivers para pantallas de SoC: el MCDE de ST-Ericsson y el de los Ingenic JZ47xx, además del análisis de metadatos HDR en la capa común, AMD e Intel.
El driver de amdgpu expone contadores de PMU y el valor de MEM_LOAD en debugfs, con lo que se puede ver la presión de memoria de la GPU sin herramientas externas.
El beneficio es la cobertura: pantallas de placas y diagnóstico de GPU. Los límites: los drivers nuevos son para hardware concreto; los contadores dependen del bloque de la GPU. La documentación de DRM describe el modelo.
15. x86: arch_status, BFLOAT16 y multi-die
El kernel añade /proc/<pid>/arch_status para exponer información específica de la arquitectura, como el estado de las mitigaciones de especulación de ese proceso.
Se enumeran las instrucciones AVX-512 BFLOAT16, pensadas para aprendizaje automático, y se implementa la topología multi-die: el kernel distingue los dies de un paquete y los expone en sysfs, con lo que el scheduler y las herramientas pueden repartir mejor.
Las tres son de información: más datos del proceso, más instrucciones y mejor topología. Los límites: arch_status es específico de cada arquitectura; BFLOAT16 necesita compilador y aplicación. La documentación de mitigaciones recoge el estado.
16. ARM: MT8183, J721E, G12B y BMC
ARM suma SoC para portátiles, automoción y servidores: el MediaTek MT8183 de los Chromebooks, el TI J721E con DSP y NPU, el Amlogic G12B de las televisiones y placas, y nuevas plataformas Aspeed para servidores.
También entra el Kontron SMARC, un módulo con varias versiones de i.MX6.
El patrón es el de siempre: el kernel reconoce placas antes de que se vendan. Los límites: cada SoC necesita su árbol de dispositivos y su firmware. La documentación de ARM64 recoge el estado.
17. Perf y BPF: BTF, reuseport y cgroup
libbpf permite volcar BTF a C, con lo que se puede inspeccionar la definición de un tipo del kernel sin herramientas externas, y BPF puede propagar notificaciones de congestión desde cgroup a TCP.
Se añade SO_DETACH_REUSEPORT_BPF para desenganchar un programa de un grupo de sockets, y llega una nueva forma de recorrer mapas pensada para los programas de traza.
El beneficio es el control del socket y del mapa: menos código y más flexibilidad. Los límites: BTF necesita compilar con depuración; reuseport tiene que estar en uso. La documentación de BPF describe el modelo.
18. Drivers: audio, USB y watchdog
El HDA de Intel reconoce Elkhart Lake, y ASoC añade el códec Conexant CX2072X, habitual en portátiles económicos.
En USB, usbfs estrena un ioctl para obtener la información de conexión de un dispositivo, útil para herramientas de diagnóstico, y chipidea admite el i.MX7ULP. El watchdog permite fijar un plazo para abrir /dev/watchdog, de modo que un servicio que no arranca a tiempo no se cuelgue esperando, y hpwdt añade un timeout de kdump.
Las piezas son de plataforma: audio, USB y watchdog en placas nuevas. Los límites: cada códec y controlador necesitan su firmware; el plazo del watchdog es una política del sistema. La documentación de driver API recoge el modelo.
19. Almacenamiento: SCSI y NVMe
SCSI añade el envío por lotes de peticiones para reducir el coste por comando, y lpfc publica eventos de reescaneo del controlador. NVMe permite inyectar errores en comandos administrativos, una herramienta para probar el manejo de fallos, y megaraid_sas añade un parámetro de logs asíncronos.
El driver fdomain resucita para hardware antiguo que aún se usa en virtualización.
El beneficio es el diagnóstico: menos coste por comando y más formas de probar errores. Los límites: la inyección de errores es para desarrollo; los logs asíncronos consumen memoria. La documentación de SCSI describe el stack.
20. Por subsistemas
20.1 Core y herramientas
La documentación del proceso recoge el modelo.
La documentación de la API de drivers recoge el modelo.
pidfd con poll, uclamp y umwait son las novedades del core. El scheduler también recibe ajustes de balanceo.
20.2 Sistemas de ficheros
ext4, XFS y Btrfs reciben correcciones y mejoras; no hay cambios de formato.
20.3 Memoria
Mejoras de reclamación y de THP. El ciclo no introduce una política nueva.
20.4 Bloque
Correcciones y hardware nuevo. blk-mq sigue afinando su comportamiento.
20.5 Redes
0.0.0.0/8 y mejoras de la pila; los drivers de tarjetas y WiFi siguen entrando.
20.6 Virtualización
ACRN invitado y mejoras de KVM y virtio.
20.7 Arquitecturas
ARM suma placas; x86 añade Zhaoxin y Speed Select; RISC-V y MIPS siguen avanzando.
21. Lo que no llega
Navi es soporte inicial: faltan frecuencias y aceleración completa, que llegan en ciclos posteriores. Zhaoxin es nicho. umwait depende de la CPU y de la política del sistema.
pidfd_open necesita permisos. uclamp no garantiza rendimiento. Y 5.3 no es LTS: la LTS es 5.4, que llega en noviembre, según el calendario de kernel.org.
22. Cambios menores
Más detalle en la documentación de cpuidle.
Core
- pidfd —
poll. - uclamp — mínimo y máximo.
Hardware
- Zhaoxin — CPU.
- Speed Select — potencia.
- umwait — espera.
23. Qué viene después
El siguiente ciclo está en el inventario de KernelNewbies.
La merge window de 5.4 se abre el 16 de septiembre y cierra el 29 de septiembre. Ese ciclo traerá lockdown, virtio-fs y fs-verity; Linux 5.4 sale el 24 de noviembre y será la LTS de 2019.
Para las distribuciones, 5.3 es la base de Ubuntu 19.10 y Fedora 31, que llegan en octubre. Las rolling la adoptan en semanas. La LTS sigue siendo 4.19 hasta noviembre.
Las próximas releases mostrarán si uclamp se usa en Android, si Navi se completa y si pidfd sustituye a las señales en los gestores de servicios.
El ciclo consolida pidfd como la forma correcta de referirse a un proceso y lleva uclamp al scheduler, donde sigue siendo la base del reparto de rendimiento en Android. Navi fue el primer paso de RDNA en el kernel, y ACRN abrió la puerta a Linux como invitado en hipervisores de IoT. El resto es plataforma: más direcciones IPv4 y más SoC.
24. Referencias
- KernelNewbies: Linux 5.3 — inventario completo por subsistema.
- ChangeLog-5.3 — la lista completa de commits.
- Phoronix: Linux 5.3 features — repaso de las novedades.
- kernel.org: releases — calendario y LTS.