Linux 5.7: exFAT nuevo, presión térmica y pointer auth
Linux 5.7 estrena exFAT, lleva la presión térmica al scheduler y protege el kernel de ARM con pointer authentication. 13.901 changesets y 1.878 autores.
exFAT tenía un driver de staging y mala reputación; Linux 5.7, publicado el 31 de mayo de 2020, lo sustituye por una implementación nueva y añade presión térmica al scheduler, contabilidad de frecuencia en x86 y pointer authentication para el kernel de ARM. El ciclo suma 13.901 changesets y 1.878 desarrolladores, de los que 281 enviaban su primer parche.
La release sale el domingo 31 de mayo de 2020, nueve semanas después de 5.6 y dentro de la serie 5.x. La merge window se abrió el 30 de marzo y cerró el 12 de abril, y el árbol se estabilizó en siete release candidates.
Las cifras de este post son las de LWN, que cuenta changesets sin merges: 13.901 changesets y 1.878 desarrolladores. Los 281 novatos son la cifra más alta desde 5.0, un contraste con 5.6, que había tenido el mínimo desde 2013.
Hay tres claves. La primera es el scheduler: la presión térmica y la frecuencia entran en el cálculo de carga. La segunda es el sistema de ficheros: exFAT sale de staging con una implementación nueva. La tercera es la seguridad: ARM protege los punteros con PAC y BPF puede escribir políticas LSM.
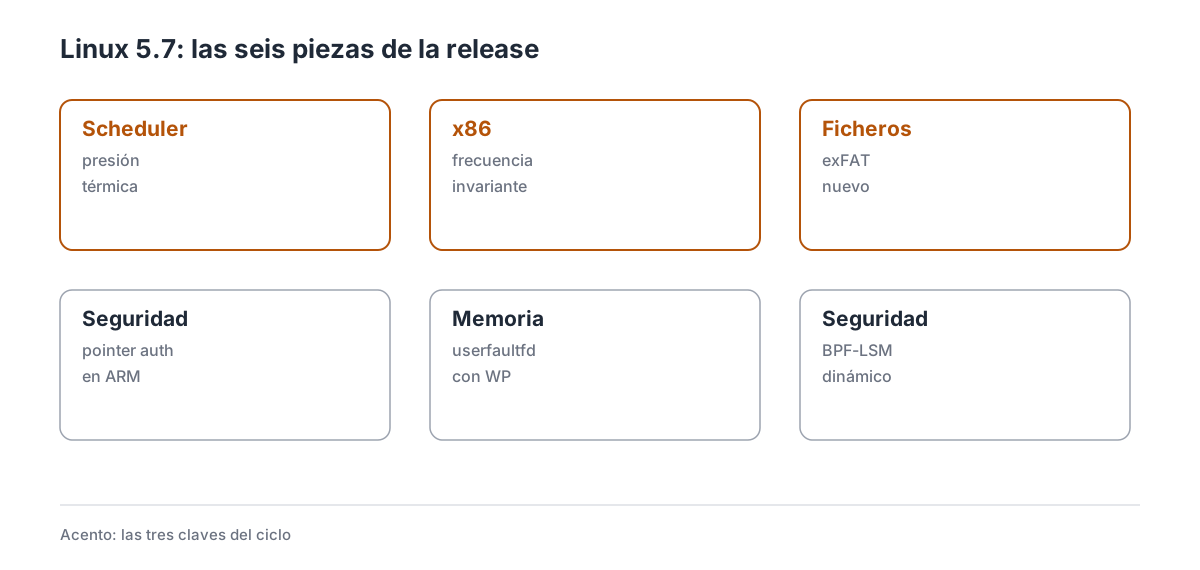
Las seis piezas que explican el ciclo, con las tres claves marcadas en ámbar.
1. Las cifras de un ciclo normal
| Dato | Valor |
|---|---|
| Fecha de release | 31 de mayo de 2020 |
| Versión anterior | 5.6 (29 de marzo de 2020) |
| Merge window | 30 de marzo al 12 de abril de 2020 |
| Release candidates | 7 |
| Changesets | 13.901 |
| Desarrolladores | 1.878 |
| Novatos | 281 |
El ciclo llega después de 5.6, el más pequeño de la serie, y vuelve a las cifras habituales. El ciclo está en la media de la serie: 13.901 changesets, por debajo de los 16.306 de 5.8 y por encima de los 12.665 de 5.6. Lo que más llama la atención son los 281 novatos, en pleno confinamiento.
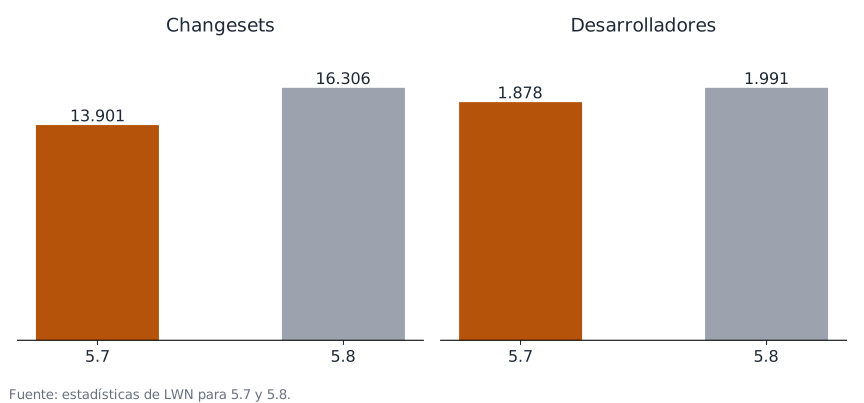
Las dos releases comparadas con las estadísticas de LWN, que no cuentan los merges.
El reparto por empresas y el trabajo por subsistemas siguen el patrón de la serie: Intel, Red Hat, Google, AMD y Linaro en cabeza, con los fabricantes empujando drivers y las empresas de infraestructura el core. No hay una feature de hardware que domine el ciclo.
El desarrollador más activo es Lee Jones, con limpieza de avisos, seguido de los nombres de siempre en i915, red y documentación. Es un ciclo de trabajo constante.
2. Presión térmica: el scheduler sabe cuándo la CPU se calienta
Un móvil o un portátil delgado no puede mantener la frecuencia máxima mucho tiempo: cuando el chip se calienta, baja el reloj y la capacidad real del núcleo cae. El scheduler, sin embargo, seguía midiendo la carga como si la capacidad fuera constante, y tomaba decisiones con datos falsos.
La presión térmica añade esa información al modelo: el kernel mide cuánta capacidad se pierde por temperatura y frecuencia, y la resta de la que usa para repartir tareas. El resultado se integra en PELT, el contador de carga por entidad.
El cálculo se hace por núcleo y por capacidad máxima, y se actualiza en cada tick del scheduler. El dato se integra en el contador de carga de cada tarea, así que una tarea que se ejecutaba en un núcleo limitado por temperatura cuesta más. Quien más lo nota son los dispositivos que se calientan: un móvil que baja de 2,8 a 1,8 GHz deja de recibir la misma carga, y el scheduler reparte mejor entre los núcleos que quedan. También evita migraciones que empeoran el calor.
Los límites: la medición depende de los sensores y del driver de frecuencia; en un servidor con refrigeración no cambia nada. La documentación del scheduler describe el modelo de energía.
3. Frecuencia invariante en x86
El mismo problema, visto desde la frecuencia: dos tareas con la misma utilización no cuestan lo mismo a 3 GHz que a 1,5 GHz. La contabilidad de carga debe escalar con la frecuencia para que el scheduler compare peras con peras.
5.7 implementa la contabilidad invariante en x86 para las CPU que exponen la frecuencia actual, y adapta intel_pstate para que el gobernador schedutil reciba la información correcta. Con eso, el gobernador puede pedir la frecuencia que la carga necesita.
La contabilidad se apoya en los contadores de frecuencia de aperfmperf, que el kernel ya usaba para otras métricas. El gobernador pide la frecuencia que la carga necesita, y el scheduler reparte entre núcleos sabiendo cuánto rinde cada uno a esa frecuencia. El beneficio es el rendimiento por vatio: en un portátil, schedutil deja de pedir la frecuencia máxima para una carga ligera y la sube cuando hace falta. En un servidor, el reparto entre núcleos es más justo.
Los límites: no todas las CPU exponen la frecuencia real, y la contabilidad no corrige un gobernador mal configurado. La documentación de la frecuencia recoge las fórmulas.
4. exFAT: el sistema de ficheros nuevo
exFAT es el sistema de ficheros de las tarjetas SD grandes y de las unidades extraíbles, y durante años el kernel solo tuvo una implementación de staging con mala fama. 5.7 estrena una implementación nueva, escrita por Samsung y revisada en las listas durante meses.
La implementación nueva admite ficheros de más de 4 GB, nombres largos, búsquedas más rápidas y un manejo de metadatos más robusto. Sustituye al driver de staging, que se retira.
El driver nuevo pasó por xfstests y por pruebas de interoperabilidad con Windows antes de entrar en el árbol. Antes de 5.7, exFAT solo existía como driver de staging, con un código que nadie quería mantener y que se quedaba fuera de los tests. La implementación nueva se revisó en las listas durante meses y pasó a ser la única. El beneficio es inmediato para quien comparte discos con Windows y cámaras: una tarjeta exFAT se monta con el driver del árbol, sin sorpresas, y el rendimiento mejora en directorios grandes.
Los límites: exFAT no tiene journal ni permisos POSIX, así que no es un sistema para el disco del sistema; y la implementación nueva necesitó correcciones en ciclos posteriores. La documentación de ficheros recoge el estado.
5. Split lock detection: cuando una instrucción bloquea el bus
Un split lock es un acceso atómico que cruza dos líneas de caché. El procesador lo resuelve bloqueando el bus durante cientos de ciclos, con lo que un solo proceso puede degradar a todos los demás. En un sistema realtime, es un desastre.
5.7 añade la detección en x86: el kernel activa la excepción de alineación para los split locks y, según el modo, avisa o mata al proceso. El parámetro split_lock_detect= permite elegir entre aviso, SIGBUS y desactivado.
La detección se apoya en la excepción #AC, que el hardware genera cuando el acceso atómico cruza una línea; el kernel la captura y decide qué hacer. Un split lock puede costar miles de ciclos y, en un sistema con muchos núcleos, degrada a todos los procesos que comparten el bus. En modo aviso, el kernel deja una línea en el log con el proceso y la instrucción, sin matarlo; en modo fatal, el proceso recibe SIGBUS. El caso de uso son los sistemas realtime y los de depuración: un servidor de bolsa o una máquina industrial no puede permitir que una aplicación mal escrita bloquee el bus. También ayuda a encontrar código que supone alineación.
Los límites: la detección no arregla el programa, y matar el proceso puede romper aplicaciones antiguas; en modo aviso solo deja una traza. La documentación de x86 recoge el parámetro.
6. Pointer authentication en ARM
ARMv8.3 introduce Pointer Authentication: los punteros llevan una firma criptográfica en los bits altos, y el hardware la verifica antes de usarlos. Un atacante que sobrescribe un puntero no puede falsificar la firma sin la clave.
5.7 añade el soporte para el kernel: las direcciones de retorno y los punteros sensibles se firman al guardarse y se verifican al cargarse, con lo que un desbordamiento que cambie un puntero provoca un fallo controlado en vez de un salto.
Las claves de firma se generan al arrancar y se guardan en registros que el código de usuario no puede leer; el kernel firma con PACIA y verifica con AUTIA. El soporte se activa por configuración y se puede desactivar por CPU si el firmware no lo anuncia bien. El beneficio es una mitigación de control de flujo en hardware, más barata que las sombras de pila y compatible con el código existente. Se combina con BTI, que llegó en 5.8.
Los límites: necesita CPU ARMv8.3 y un compilador que emita las instrucciones; el soporte de usuario y el del kernel se activan por separado. La documentación de arm64 describe la extensión.
7. userfaultfd con protección de escritura
userfaultfd permite que un proceso gestione sus propios fallos de página: cuando una página falta, el kernel avisa al proceso y este decide qué hacer. Es la base de la migración en vivo de máquinas virtuales y de CRIU.
5.7 añade la protección de escritura: el proceso puede marcar un rango como de solo lectura y recibir un aviso cuando alguien intenta escribir, sin usar mprotect() ni un manejador de SIGSEGV.
La protección de escritura se activa con UFFDIO_WRITEPROTECT y el aviso incluye la página y el motivo, sin recorrer la tabla entera. CRIU y QEMU son los dos usuarios clásicos: uno congela un proceso y copia su memoria, el otro migra una máquina virtual y necesita saber qué páginas cambian mientras copia. El beneficio es el rendimiento y la precisión: mprotect obliga a recorrer toda la tabla de páginas y el manejador de señal no distingue el motivo del fallo. Con userfaultfd, el aviso llega con la dirección exacta y el proceso decide sin salir del bucle.
Los límites: no cubre shmem ni hugetlbfs en esta versión, y el proceso debe estar preparado para gestionar los avisos sin bloquearse. La documentación de userfaultfd describe la API.
8. BPF-LSM: políticas de seguridad sin recompilar
Los módulos LSM (SELinux, AppArmor) implementan políticas de control de acceso, pero cambiar una política implica cambiar el módulo o su configuración. BPF-LSM, también conocido como KRSI, permite enganchar programas BPF a los hooks LSM y decidir en tiempo de ejecución.
El programa se engancha a hooks como file_open, inode_permission o task_kill y devuelve un veredicto, con lo que la política se queda en el espacio de usuario. La idea se discutió durante dos años en las listas, con dudas sobre si un programa BPF puede tomar decisiones de seguridad sin abrir un agujero. Los hooks cubren operaciones de fichero, de socket, de tarea y de módulo, y el programa puede auditar sin bloquear o denegar la operación. No compite con SELinux: SELinux etiqueta objetos y aplica una política estática, mientras que BPF-LSM decide en el momento con el contexto de la operación. El caso de uso es la auditoría y las políticas dinámicas: un programa puede permitir o denegar una operación según el contexto, y la política se actualiza sin reiniciar. También sirve para observar qué hooks se disparan y con qué argumentos.
Los límites: un programa BPF-LSM mal escrito puede abrir un agujero de seguridad, y su carga requiere privilegios; no sustituye a SELinux, se suma. La documentación de LSM describe el modelo.
9. clone3 en cgroups y perf por cgroup
Dos mejoras de control. clone3() acepta CLONE_INTO_CGROUP: el proceso nuevo nace directamente en el cgroup que indica un descriptor, sin que el padre tenga que moverlo después. Un gestor de servicios puede crear el servicio ya limitado y contabilizado.
En perf, cada muestra incluye el id del cgroup: se pueden perfilar varios grupos a la vez y ordenar el informe por cgroup. Antes solo se podía perfilar un grupo y no se sabía a cuál pertenecía cada muestra.
El proceso nuevo hereda el cgroup del descriptor y aparece contabilizado desde el primer instante, sin el pico de CPU que antes se colaba. Un servicio que arranca en un cgroup con CLONE_INTO_CGROUP no pasa por el estado intermedio en el que consumía CPU sin límite ni contabilidad. Las dos piezas cierran un hueco: una evita que un proceso corra sin límites entre clone y write al cgroup; la otra evita atribuir muestras al grupo equivocado. Los límites: clone3 con cgroup necesita un descriptor válido y permisos; perf por cgroup añade un campo a cada muestra. La documentación de cgroups recoge las interfaces.
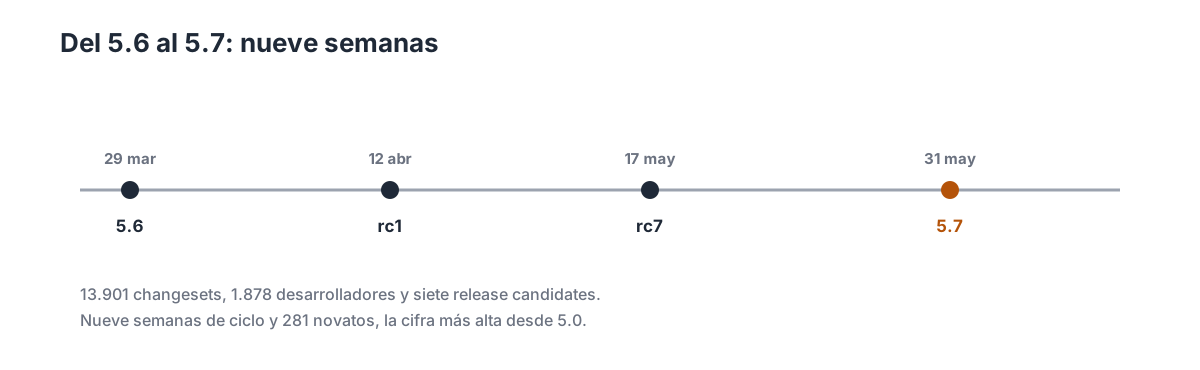
Nueve semanas de ciclo, con siete release candidates y 281 novatos.
10. Por subsistemas
10.1 Core y herramientas
mremap admite MREMAP_DONTUNMAP, que mueve un mapeo sin dejar el original, y la gestión de memoria gana MADV_FREE por página. io_uring reescribe su manejo de E/S asíncrona.
10.2 Sistemas de ficheros
Btrfs clona extents inline, acelera la resolución de referencias y añade BTRFS_IOC_SNAP_DESTROY_V2. exFAT llega al tree principal.
10.3 Memoria
Llega el aviso de páginas libres para que el host recupere memoria del invitado, la protección recursiva de memcg y mejoras de los fallos de página.
10.4 Bloque
dm-writecache añade limpieza gradual, dm-integrity admite discard y las estadísticas de disco miden mejor io_ticks.
10.5 Traza, perf y BPF
BPF-LSM es la novedad, junto con mejoras del informe de perf y de los helpers. También llega el soporte de BPF con PREEMPT_RT.
10.6 Networking
SO_BINDTODEVICE deja de necesitar root, MPTCP suma múltiples subflujos y llega el túnel bareudp. bind(addr, 0) elige puerto efímero si el indicado está ocupado.
10.7 Virtualización
vfio y vhost reciben correcciones, y virtio mejora su negociación de features. El aviso de páginas libres ayuda a los hipervisores a recuperar memoria.
10.8 Arquitecturas y drivers
ARM suma Snapdragon 865, MT8516, i.MX8M Plus y la placa sl28. x86 añade el arranque EFI mixto, y DRM suma paneles OLED y HDCP con SRM.
11. Lo que no llega
exFAT no tiene journal ni permisos POSIX: sirve para tarjetas y discos extraíbles, no para el sistema. La detección de split lock solo avisa o mata; no arregla el programa.
Pointer authentication necesita ARMv8.3 y compilador compatible. userfaultfd con protección de escritura no cubre shmem ni hugetlbfs. BPF-LSM no sustituye a SELinux.
El ciclo tampoco cambia formatos en disco: ext4, XFS y Btrfs siguen leyendo los mismos volúmenes, y exFAT solo añade un driver nuevo para el mismo formato. Y 5.7 no es LTS: la LTS es 5.4 hasta diciembre, según el calendario de kernel.org.
12. Cambios menores
Ficheros
Networking
- TCP — sysctls de congestión.
- IPv6 — RPL source routing.
- SO_BINDTODEVICE — sin root.
Drivers
13. Qué viene después
La merge window de 5.8 se abre el 1 de junio y cierra el 14 de junio. Ese ciclo traerá KCSAN, las notificaciones por pipe, SCS y BTI en arm64 y el cifrado inline, según el inventario de KernelNewbies; Linux 5.8 sale el 2 de agosto y batirá el récord de changesets.
Para las distribuciones, 5.7 es la base de Ubuntu 20.10 y Fedora 33, que llegan en otoño con exFAT y pointer auth. Las rolling la adoptan en semanas. La LTS sigue siendo 5.4.
El ciclo deja el árbol preparado para el verano de 2020, con más trabajo en energía y seguridad que en hardware nuevo. El ciclo deja el árbol preparado para el verano de 2020, con más trabajo en energía y seguridad que en hardware nuevo. Las próximas releases mostrarán si la presión térmica mejora los móviles, si exFAT se queda como el driver de referencia y si BPF-LSM se usa en producción.
14. Referencias
- KernelNewbies: Linux 5.7 — inventario completo por subsistema.
- ChangeLog-5.7 — la lista completa de commits.
- LWN: Thermal pressure — el diseño de la presión térmica.
- LWN: KRSI — the other BPF security module — BPF-LSM.
- Phoronix: Linux 5.7 features — repaso de las novedades.
- kernel.org: releases — calendario y LTS.