Linux 5.8: récord de parches, KCSAN y SCS en arm64
Linux 5.8 bate el récord de changesets, equilibra la memoria por coste de E/S y estrena KCSAN, notificaciones por pipe y SCS en arm64. 16.306 parches.
Nunca se habían mergeado tantos parches en un ciclo: Linux 5.8 se publicó el 2 de agosto de 2020 con 16.306 changesets y 1.991 desarrolladores, los dos récords de la serie 5.x. Incluye además un equilibrio de memoria que mide el coste de la E/S y dos herramientas para encontrar errores: KCSAN para race conditions y SCS para proteger la pila de retorno en arm64.
La release sale el domingo 2 de agosto de 2020, nueve semanas después de 5.7 y dentro de la serie 5.x. La merge window se abrió el 1 de junio y cerró el 14 de junio, y el árbol se estabilizó en siete release candidates.
Las cifras de este post son las de LWN, que cuenta changesets sin merges: 16.306 changesets, 92 más que el récord anterior de 4.9, y 1.991 desarrolladores, también un máximo. 304 enviaban su primer parche.
Hay tres claves. La primera es la memoria: el kernel deja de mirar solo la tasa de aciertos y empieza a medir el coste de traer de vuelta una página. La segunda es la depuración: KCSAN encuentra race conditions de datos que se escapan a los tests. La tercera es la seguridad: SCS y BTI añaden protección al código compilado para arm64.
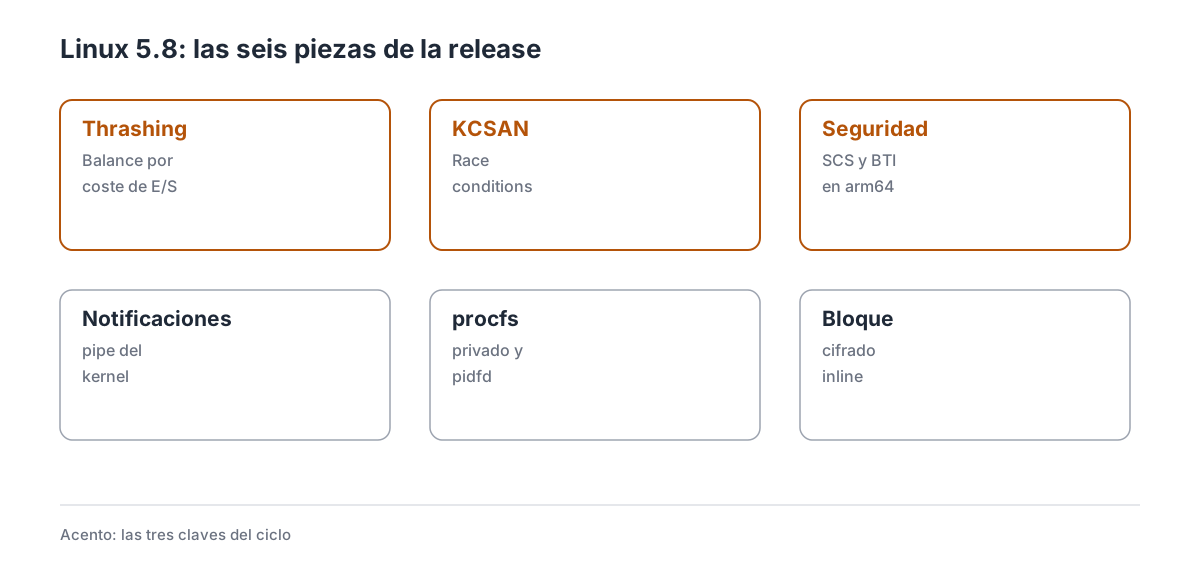
Las seis piezas que explican el ciclo, con las tres claves marcadas en ámbar.
1. Las cifras del récord
| Dato | Valor |
|---|---|
| Fecha de release | 2 de agosto de 2020 |
| Versión anterior | 5.7 (31 de mayo de 2020) |
| Merge window | 1 al 14 de junio de 2020 |
| Release candidates | 7 |
| Changesets | 16.306 |
| Desarrolladores | 1.991 |
| Novatos | 304 |
El récord anterior se mantenía desde 2016 y se superó por un margen mínimo, lo que muestra lo cerca que estaba el techo. Los 16.306 changesets superan en 92 al récord de 4.9, de diciembre de 2016, y los 1.991 desarrolladores son la primera vez que el kernel pasa de 1.990. El récord se reparte entre drivers, documentación y limpieza: no hay una sola serie de un millón de líneas, sino miles de parches pequeños. El ciclo es, en palabras de LWN, uno de los más ocupados que se recuerdan.
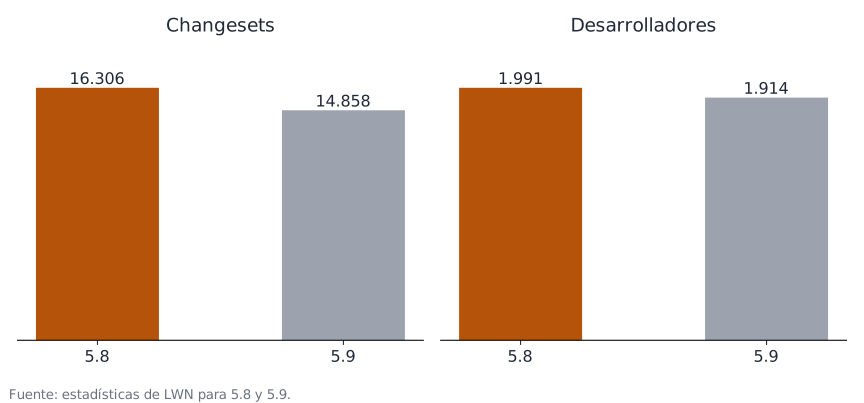
Las dos releases comparadas con las estadísticas de LWN, que no cuentan los merges.
El reparto por empresas y el volumen de código nuevo explican el récord: drivers de GPU, paneles y plataformas ARM, además de la limpieza habitual. Es un ciclo amplio, con muchas series pequeñas, más que un ciclo con una feature gigante.
El desarrollador más activo es Mauro Carvalho Chehab, con 549 changesets, casi todos de documentación y limpieza, y después figuran los nombres de siempre en i915, red y documentación. La consecuencia del récord es que el árbol tarda más en estabilizarse: siete rc y un ciclo de nueve semanas.
2. Thrashing: equilibrar la memoria por coste de E/S
Cuando el sistema tiene poca memoria, el kernel decide qué expulsar: páginas de caché de ficheros o páginas anónimas que van a swap. Durante años, esa decisión se basó en una heurística que funcionaba con discos lentos, pero que con SSD rápidos hace que la caché entre en thrashing sin tocar el swap.
El cambio de 5.8 usa el coste real: desde 3.15 el kernel mide los refaults, las páginas que vuelven a fallar tras haber sido expulsadas, y ahora compara ese coste con el de leer del dispositivo de swap. Con esa información, el balance entre las dos listas LRU se ajusta para minimizar la E/S total.
El kernel compara el coste de un refault con el de leer una página del swap, y ajusta las listas para que la E/S total sea la menor posible. Con swap en RAM, el coste de expulsar una página es una compresión en vez de una lectura de disco, y el equilibrio cambia por completo. El efecto se nota en equipos con zram o zswap: el swappiness se puede subir hasta 200, algo que antes no tenía sentido, porque el swap es memoria y no un disco. En un portátil con poca RAM, el sistema prefiere comprimir páginas anónimas antes que tirar la caché.
Los límites: el modelo depende de que el dispositivo de swap sea rápido y de que el swappiness esté bien ajustado; con un disco lento, subirlo puede empeorar. La documentación de memoria describe las listas y los contadores.
3. KCSAN: encontrar race conditions
Una race condition ocurre cuando dos hilos acceden a la misma variable sin sincronización y al menos uno escribe. El compilador puede reordenar, el hardware puede cachear y el bug aparece una vez cada millón de ejecuciones, justo en producción.
KCSAN instrumenta los accesos a memoria y usa watchpoints por muestreo: cuando un hilo escribe en una dirección, el detector marca un rango y comprueba si otro hilo accede sin la sincronización adecuada. No instrumenta todo, así que el coste es asumible en un kernel de pruebas.
KCSAN se activa con CONFIG_KCSAN y se integra en syzkaller; un test que corre durante horas puede encontrar un fallo que un test unitario nunca vería. No da falsos positivos: solo avisa cuando puede demostrar que falta una barrera o un lock, y distingue los accesos atómicos de los normales. Eso lo hace útil para integrarse en los tests y en syzkaller.
Los límites: el muestreo puede tardar en ver un fallo poco frecuente, y el detector solo cubre accesos instrumentados; el código en ensamblador queda fuera. La documentación de KCSAN explica el modelo.
4. Notificaciones del kernel por una tubería
Un proceso que quiere saber cuándo cambia una clave, un montaje o un watchdog tiene que sondear o esperar en un descriptor. El mecanismo de notificaciones de 5.8 usa una tubería en un modo especial: el kernel escribe mensajes en su búfer y el proceso los lee con read().
El dueño de la tubería declara qué fuentes quiere vigilar y puede poner filtros para ignorar tipos de evento. En 5.8 la única fuente son las claves y los llaveros —enlazar, desenlazar y cambiar atributos—, y el primer usuario es GNOME, que necesita saber cuándo cambian las claves de la sesión.
Los filtros se declaran con IOC_WATCH_QUEUE_SET_FILTER y permiten descartar, por ejemplo, los cambios de atributos que no interesan a la aplicación. GNOME quiere saber cuándo se añade o se quita una clave del llavero de la sesión para actualizar su interfaz sin sondear cada segundo. El diseño reutiliza lo que ya existe: una tubería, poll() y read(). No hay una API nueva que aprender, y el coste es el de una lectura normal.
Los límites: el búfer es limitado y el productor puede perder eventos si el consumidor no lee; y en 5.8 solo hay una fuente, así que el mecanismo es más una base que una herramienta completa. La documentación de watch_queue describe la API.
5. procfs privado y pidfd para namespaces
Dos cambios para contenedores y sistemas embebidos. El primero permite varios montajes de procfs en el mismo namespace de PID, cada uno con sus opciones. Así un supervisor puede dar a una aplicación un /proc que solo muestra sus procesos, o uno que oculta los inodos que no son de PID.
El segundo es setns() con un pidfd: en vez de abrir un fichero por cada namespace, se pasa el pidfd del proceso y una máscara con los namespaces a los que adjuntarse. La operación es atómica: o entra en todos o en ninguno.
La opción subset=pid deja un /proc sin los inodos que no son de procesos, y hidepid= oculta los procesos de otros usuarios. Los dos van en la misma dirección: menos privilegios y menos fallos de concurrencia. Un gestor de contenedores puede entrar en el namespace de red y de montaje de un proceso sin abrir cinco ficheros ni arriesgarse a que el proceso muera entre medias.
Los límites: procfs privado sigue necesitando privilegios para montarse, y setns con pidfd solo cubre los namespaces que ya soportaban setns. La documentación de procfs recoge las opciones.
6. SCS y BTI: proteger el control de flujo en arm64
Dos mitigaciones para ARM. La primera es Shadow Call Stack: el compilador guarda la dirección de retorno en una pila separada que el atacante no puede sobrescribir con un desbordamiento de la pila normal. Si las dos copias no coinciden, el kernel aborta.
La segunda es Branch Target Identification, parte de ARMv8.5: el hardware solo permite saltar a instrucciones marcadas como destino válido, con lo que un salto a mitad de una función falla. Se aplica al kernel, al vDSO y al código compilado con la extensión.
SCS reserva una pila por tarea y el compilador inserta la escritura y la comprobación en cada función; BTI marca los destinos válidos con una instrucción nueva, BTI c, que el hardware reconoce. Las dos son complementarias: SCS protege las direcciones de retorno; BTI, los saltos indirectos. Juntas cubren los dos vectores clásicos de un ataque de control de flujo.
Los límites: SCS necesita Clang y añade una reserva de memoria por tarea; BTI necesita hardware ARMv8.5, que en 2020 era escaso. La documentación de arm64 recoge las extensiones.
7. Cifrado inline en el bloque
El cifrado de ficheros con fscrypt cifraba en la CPU antes de enviar los datos al disco. El cifrado inline delega esa tarea al hardware del dispositivo: el kernel asocia un contexto de cifrado a cada petición y el controlador cifra o descifra al vuelo.
El contexto de cifrado incluye la clave, el algoritmo, el número de unidad y el tamaño, y viaja con la petición sin que el driver tenga que conocer los detalles. fscrypt sigue gestionando las claves y la política; lo único que cambia es dónde se cifra el dato, con lo que las aplicaciones no se enteran. El beneficio es doble: la CPU se libera y la clave no viaja por el bus en claro hasta el disco. Es el modelo que usan los móviles con almacenamiento cifrado por hardware.
Los límites: hace falta un dispositivo con soporte de cifrado inline y un sistema de ficheros que lo use; sin hardware, el kernel sigue cifrando en la CPU. La documentación de cifrado inline describe el stack.
8. CAP_BPF y CAP_PERFMON: menos privilegios para BPF
Durante años, cargar un programa BPF requería CAP_SYS_ADMIN, la capability más poderosa del sistema. Un servicio que solo quería contar paquetes tenía los mismos permisos que uno que podía montar discos.
5.8 parte esa capability en dos: CAP_BPF para crear mapas y cargar programas, y CAP_PERFMON para monitorizar el rendimiento. Las operaciones de red siguen pidiendo CAP_NET_ADMIN, y las más peligrosas, CAP_SYS_ADMIN.
Un contenedor con CAP_BPF puede cargar programas de observación, pero no montar sistemas de ficheros ni cambiar la configuración de red. La separación sigue el modelo de las capabilities de red: cada operación pide la capability mínima que necesita, y el administrador puede delegar solo esa. El beneficio es de mínimo privilegio: un contenedor puede usar BPF para observar sin recibir el control total del sistema. Es la misma lógica que separó las capabilities de red hace años.
Los límites: la partición no elimina el riesgo de un programa BPF malicioso, y las distribuciones tienen que actualizar sus políticas para usar las nuevas capabilities. La documentación de BPF describe los requisitos.
9. IPv6 MPLS y redundancia de anillo
En redes, el ciclo añade MPLS sobre IPv6: las etiquetas MPLS se pueden transportar en paquetes IPv6, con lo que las operadoras pueden extender sus túneles a redes que ya no tienen IPv4. También llega el Media Redundancy Protocol para los anillos de switches industriales, que necesitan reconectar en milisegundos cuando un enlace cae.
MRP funciona en anillos de switches industriales y detecta la rotura de un enlace en milisegundos, sin depender de STP. En una operadora, MPLS sobre IPv6 permite mantener los túneles y las etiquetas mientras la red de acceso migra a IPv6. Las dos piezas son de infraestructura: una amplía el transporte, la otra la resiliencia. Los límites: MPLS sobre IPv6 necesita que los routers del camino lo entiendan, y MRP es para topologías en anillo concretas. La documentación de MPLS recoge los parámetros.
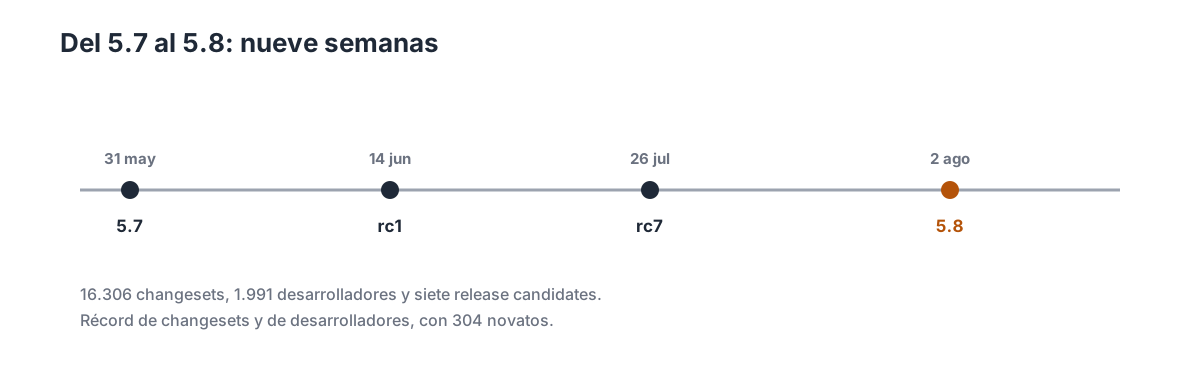
Nueve semanas de ciclo, con siete release candidates y un récord de parches.
10. Seguridad y plataformas
El ciclo mitiga SRBDS, otra variante de ejecución especulativa que filtra datos entre núcleos, y añade un hook LSM para setgid, con lo que una política puede filtrar los cambios de grupo. Los usuarios sin privilegios pueden consultar el estado de lockdown sin poder cambiarlo.
En red, ethtool y phylib ganan la infraestructura para probar el cable desde el driver, y en MIPS se reconocen los Loongson-2K. ARM añade placas Renesas y SoC Realtek para NAS.
Las piezas son de defensa y diagnóstico: menos fugas, políticas de grupo y pruebas de cable. Los límites: SRBDS cuesta rendimiento; la prueba de cable depende del PHY. La documentación de seguridad recoge el modelo.
11. Por subsistemas
11.1 Core y herramientas
io_uring añade tee(), statx directo y splice, y el scheduler mejora el despertar en topologías asimétricas. las notificaciones por eventfd se pueden activar y desactivar sobre un descriptor registrado.
11.2 Sistemas de ficheros
exFAT mejora la verificación de la región de arranque, Btrfs acelera la detección de raíces muertas y su send emite las capabilities tras el chown. El resto de sistemas recibe correcciones.
11.3 Memoria
El equilibrio por coste de E/S es la clave, y llega con mejoras de NUMA y de reparto de utilización. El swappiness admite valores hasta 200.
11.4 Bloque
El cifrado inline entra en el bloque y en fscrypt, y los drivers NVMe y SCSI suman hardware. El ciclo también mejora las estadísticas de los dispositivos y las colas.
11.5 Traza, perf y BPF
perf añade restricciones de grupos de métricas y mejora el informe con símbolos ausentes. BPF gana bpf_sk_assign y mejoras de los helpers de socket.
11.6 Networking
MPLS sobre IPv6 y MRP son las novedades, junto con mejoras de la pila y de los drivers. Las tarjetas WiFi 6 y los switches industriales reciben soporte.
11.7 Virtualización
Llega el soporte de dispositivos vDPA, vfio añade SR-IOV y virtio-net incorpora RSS y RSC. Hyper-V actualiza su protocolo PCI.
11.8 Arquitecturas y drivers
ARM recibe SCS, BTI y nuevos SoC; x86 suma modelos de CPU y correcciones de mitigaciones; RISC-V y PowerPC siguen avanzando. Se retira el exFAT de staging, sustituido por el del tree principal.
12. Lo que no llega
El equilibrio por coste de E/S depende del dispositivo de swap: con un disco lento, subir swappiness empeora. KCSAN muestrea y no ve todos los fallos de concurrencia. Las notificaciones por pipe solo cubren claves en 5.8.
SCS necesita Clang y BTI necesita ARMv8.5. El cifrado inline necesita hardware compatible. CAP_BPF no hace seguro un programa BPF, solo reparte permisos. El ciclo tampoco cambia el formato de los discos ni rompe interfaces: las llamadas nuevas son aditivas y las viejas siguen funcionando. Y 5.8 no es LTS: la LTS es 5.4 hasta diciembre, según el calendario de kernel.org.
13. Cambios menores
Core
- faccessat2 — la llamada POSIX con flags.
- utimensat —
AT_EMPTY_PATH. - whiteout — sin privilegios.
Ficheros
Drivers
- Thunderbolt — Tiger Lake.
- EDAC — familia 17h modelo 60h.
- hwmon — energía de AMD.
14. Qué viene después
La merge window de 5.9 se abre el 3 de agosto y cierra el 16 de agosto. Ese ciclo traerá la memoria anónima en la lista inactiva, el slab compartido, la compactación proactiva y close_range, según el inventario de KernelNewbies; Linux 5.9 sale el 11 de octubre.
Para las distribuciones, 5.8 es la base de Ubuntu 20.10 y Fedora 33, que llegan en otoño con KCSAN y SCS. Las rolling la adoptan en semanas. La LTS sigue siendo 5.4 hasta diciembre.
Las próximas releases mostrarán si el nuevo equilibrio de memoria mejora los portátiles con zram, si KCSAN encuentra fallos de concurrencia reales en el tree y si BTI llega al hardware de consumo.
15. Referencias
- KernelNewbies: Linux 5.8 — inventario completo por subsistema.
- ChangeLog-5.8 — la lista completa de commits.
- LWN: Concurrency bugs should fear the big bad data-race detector — el diseño de KCSAN.
- LWN: A kernel event notification mechanism — las notificaciones por pipe.
- Phoronix: Linux 5.8 features — repaso de las novedades.
- kernel.org: releases — calendario y LTS.