Linux 5.9: memoria anónima, slab compartido y FSGSBASE
El kernel cambia cómo trata la memoria anónima, comparte el slab entre cgroups y estrena close_range, FSGSBASE y compactación proactiva. 14.858 changesets.
Tres cambios profundos en la memoria y dos en el arranque: Linux 5.9 se publicó el 11 de octubre de 2020 con la memoria anónima en la lista inactiva, el slab compartido entre cgroups y la compactación proactiva, además de close_range(), FSGSBASE y el primer soporte de las GPU RDNA 2. El ciclo suma 14.858 changesets y 1.914 desarrolladores.
La release sale el domingo 11 de octubre de 2020, diez semanas después de 5.8 y dentro de la serie 5.x. Es el primer ciclo que pasa de las nueve semanas desde 5.4, y el árbol necesitó ocho release candidates para estabilizarse.
Las cifras de este post son las de LWN, que cuenta changesets sin merges: 14.858 changesets y 1.914 desarrolladores. 306 de ellos enviaban su primer parche, la cifra más alta desde 4.12.
Hay tres claves. La primera es la memoria: las páginas anónimas nuevas entran en la lista inactiva y el slab se comparte entre cgroups. La segunda es la latencia: la compactación proactiva evita que una asignación de páginas grandes pague la defragmentación. La tercera es el contexto: FSGSBASE acelera los cambios de contexto en x86.
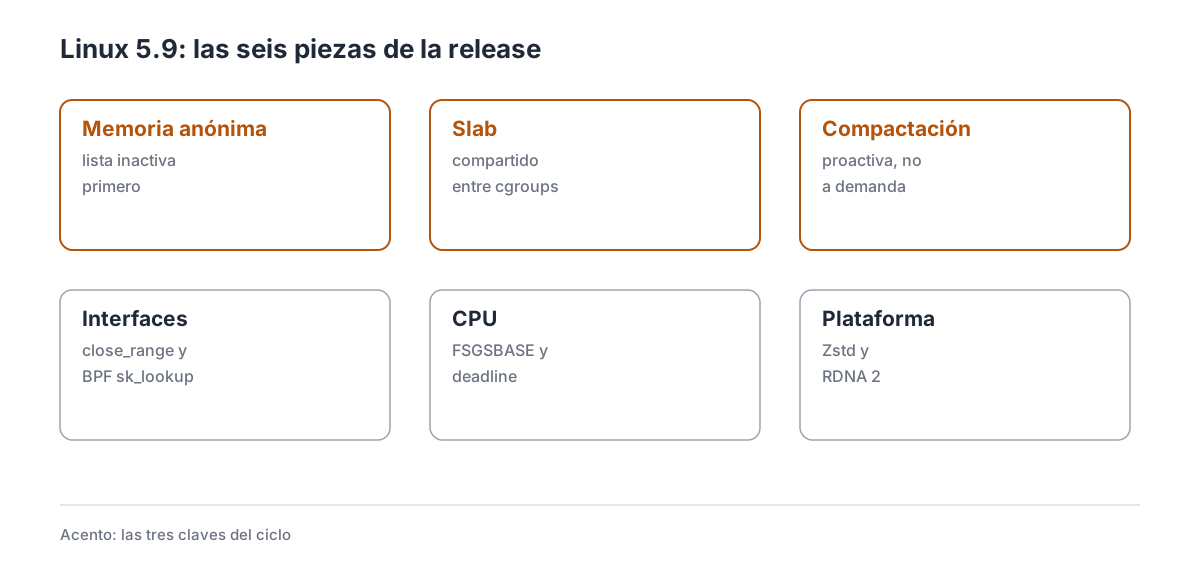
Las seis piezas que explican el ciclo, con las tres claves marcadas en ámbar.
1. Las cifras de un ciclo de diez semanas
| Dato | Valor |
|---|---|
| Fecha de release | 11 de octubre de 2020 |
| Versión anterior | 5.8 (2 de agosto de 2020) |
| Merge window | 3 al 16 de agosto de 2020 |
| Release candidates | 8 |
| Changesets | 14.858 |
| Desarrolladores | 1.914 |
| Novatos | 306 |
5.8 había batido el récord de changesets y de desarrolladores; 5.9 baja de esos números pero tarda más. El rc8 llegó al final del ciclo y la release se fue al 11, con lo que el ciclo se estiró a diez semanas. El ciclo es más corto que 5.8 en cambios (14.858 frente a 16.306) pero más largo en tiempo: diez semanas y ocho rc. Los 306 novatos son la mejor cifra desde 4.12, y la señal de que la comunidad sigue incorporando gente aunque el volumen de parches baje.
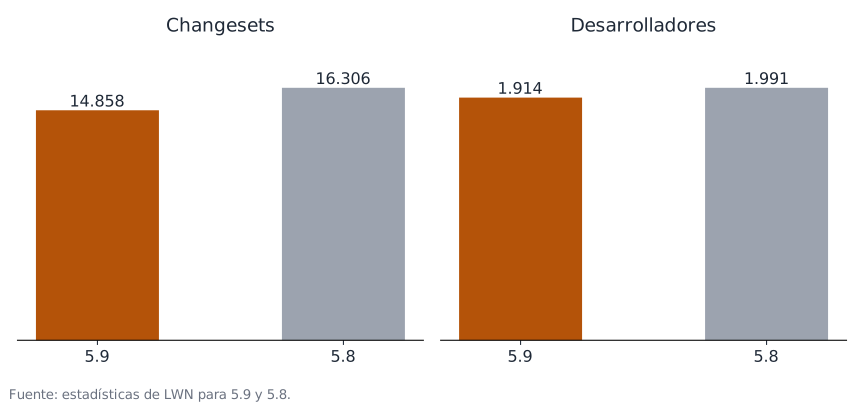
Las dos releases comparadas con las estadísticas de LWN, que no cuentan los merges.
El reparto por empresas, entre 207 empresas, lo encabezan Intel (9 %), Red Hat (6,8 %), AMD y Linaro (5,7 %) y Google (4,5 %), con el patrón habitual: con los fabricantes de silicio detrás de sus drivers y las empresas de infraestructura en el core. El ciclo no tiene un titular de hardware, sino varios cambios de fondo en memoria y scheduler.
El desarrollador más activo vuelve a ser Lee Jones, con limpieza de avisos, seguido de los nombres de siempre en i915, io_uring y red. Es un ciclo de fine-tuning: menos parches que 5.8, más tiempo de estabilización.
2. Memoria anónima: la lista inactiva primero
El kernel reparte las páginas de memoria en dos listas, activa e inactiva. Cuando hay presión, mueve páginas de la activa a la inactiva y las desmapea; si vuelven a usarse, se recuperan con un fallo suave antes de ir a swap.
Hasta 5.9, una página anónima recién creada o recuperada de swap entraba directamente en la lista activa. Eso podía desplazar a la lista inactiva páginas que sí se estaban usando, con lo que el sistema expulsaba lo caliente para hacer sitio a lo nuevo.
El cambio invierte el orden: las páginas anónimas nuevas empiezan en la inactiva y solo suben a la activa cuando se referencian lo suficiente. Además, el detector de workingset se extiende a la lista anónima para decidir mejor qué expulsar.
El detector de workingset mira si una página se referencia antes de que se expulse: si vuelve a usarse, el kernel la marca como parte del conjunto de trabajo y la protege. Con la lista anónima incluida, esa señal también vale para la memoria de malloc. El efecto se nota en cargas que usan malloc intensivamente: un proceso que arranca y llena la memoria ya no desplaza el conjunto de trabajo de los demás. En un servidor con varios servicios, eso se traduce en menos fallos y menos swap.
Los límites: el cambio favorece a las cargas ya establecidas frente a las que arrancan, y en un sistema con un solo proceso puede tardar más en calentar. La documentación de memoria describe las listas LRU.
3. Slab compartido entre cgroups
El controlador de slab por memcg replicaba las estructuras del allocator para cada cgroup: cada grupo tenía sus propias cachés y no compartía páginas con los demás. Con systemd creando decenas de cgroups, el desperdicio se multiplicaba.
El nuevo controlador comparte las páginas de slab entre cgroups y contabiliza cada objeto al grupo que lo pidió. En Facebook midieron ahorros de cientos de megas a varios gigabytes por host, con una reducción media del 35–45 %; en un Fedora de 16 GB, entre el 45 y el 50 % justo después de arrancar.
La contabilidad se hace por objeto: cada asignación recuerda a qué cgroup pertenece, y el cobro se descuenta cuando el objeto se libera. Así el grupo paga por lo que usa aunque la página sea compartida. Se recupera memoria sin tocar las aplicaciones: los objetos siguen separados por cgroup para la contabilidad y el aislamiento, pero las páginas se llenan con objetos de varios grupos.
Los límites: la contabilidad es más compleja y el aislamiento no es perfecto, porque una página compartida puede contener objetos de dos grupos; el controlador sigue siendo opt-in en algunos kernels. La documentación de cgroups describe los ficheros.
4. Compactación proactiva: defragmentar antes de necesitarlo
Las páginas grandes reducen los fallos de TLB y mejoran el rendimiento, pero necesitan memoria contigua. Cuando el sistema lleva días funcionando, la memoria está fragmentada y conseguir un bloque grande obliga a compactar en ese momento, con lo que la asignación paga la defragmentación.
La compactación proactiva cambia el momento: el kernel compacta en segundo plano cuando detecta fragmentación, antes de que haga falta un bloque grande. El nuevo sysctl vm.compaction_proactiveness decide cuánto esfuerzo se dedica.
El trabajo lo hace kcompactd, un hilo por nodo NUMA que duerme cuando no hay nada que hacer y despierta con el nivel de fragmentación. Mejora la latencia de las asignaciones: un mmap de 2 MB o un THP no esperan a que el compactador recorra la memoria. También reduce el riesgo de que el sistema entre en reclaim directo.
Los límites: compactar gasta CPU y puede competir con las aplicaciones; el valor por defecto es conservador y hay que ajustarlo según la carga. La documentación de THP explica el modelo.
5. close_range y BPF en la búsqueda de sockets
Dos interfaces nuevas. La primera es close_range(2): cierra un rango de descriptores de una vez, incluido «todos menos los tres primeros». Lo necesitaban los gestores de servicios, los runtimes de contenedores y las libc, que hasta ahora recorrían el rango llamando a close(). Se coordinó con FreeBSD, que también la tiene.
La segunda es BPF_PROG_TYPE_SK_LOOKUP: un programa BPF que se ejecuta cuando la pila busca el socket que debe recibir una conexión o un paquete. Sirve para superar los límites de bind() y repartir tráfico a un socket concreto según la IP o el puerto.
En un contenedor, close_range(3, ~0U) sustituye un bucle de hasta 1.048.576 llamadas y evita que un descriptor se escape por una carrera con exec. Las dos piezas quitan trabajo al espacio de usuario: una evita un bucle de syscalls, la otra evita mover sockets entre procesos. Los límites: close_range no puede cerrar descriptores que otro hilo esté usando sin coordinación, y sk_lookup solo decide el destino, no reescribe el paquete. La documentación de BPF describe el programa.
6. SCHED_DEADLINE con capacidad de CPU
La clase SCHED_DEADLINE garantiza a una tarea una cantidad de CPU antes de su plazo. Hasta 5.9 trataba a todos los núcleos como iguales, aunque en un sistema con núcleos grandes y pequeños (o con frecuencia variable) no lo son.
La capacidad entra en la ecuación: el scheduler mide cuánta CPU puede dar cada núcleo y ajusta la admisión y el reparto. Una tarea que necesita 30 % de un núcleo grande no se puede meter en uno pequeño sin incumplir el plazo.
La capacidad se calcula con la frecuencia máxima, el estado de la CPU y la presión térmica, y se actualiza cuando cambian. El beneficio es para los sistemas heterogéneos, como los móviles y los portátiles con P-cores y E-cores, donde una tarea realtime puede acabar en el núcleo equivocado. También mejora la admisión: el sistema rechaza una tarea cuando no hay capacidad real, no cuando hay un núcleo libre sobre el papel.
Los límites: la capacidad se estima y cambia con la frecuencia y la temperatura; y la clase deadline sigue siendo para tareas con plazos explícitos, no para todo. La documentación de deadline describe el modelo.
7. FSGSBASE: contexto más rápido en x86
En x86 de 64 bits, los registros FS y GS apuntan a la base del almacenamiento local del hilo. Cambiar esa base obligaba a una llamada al sistema, porque las instrucciones que la escriben estaban reservadas al kernel.
FSGSBASE habilita las instrucciones WRFSBASE y WRGSBASE en modo usuario: un programa puede cambiar su base sin entrar al kernel. En la práctica, los cambios de contexto de bibliotecas como las de los lenguajes con hilos y los sandboxes se ahorran una syscall.
Las instrucciones estuvieron desactivadas durante años por miedo a los ataques de especulación sobre SWAPGS, y 5.9 las habilita tras resolverse ese problema con barreras en los puntos delicados. El beneficio se mide en llamadas cortas y frecuentes: un setjmp/longjmp o un cambio de fibra deja de pagar el peaje del kernel. El kernel también usa la instrucción para su propio GS, con lo que el cambio de contexto se simplifica.
Los límites: hace falta una CPU con FSGSBASE (Ivy Bridge en adelante) y el soporte se puede desactivar con nofsgsbase; el ahorro depende del patrón de la aplicación. La documentación de x86 recoge el modelo.
8. NFS con atributos extendidos y Zstd
Dos cambios de plataforma. NFS v4.2 admite atributos extendidos de usuario, definidos en la RFC 8276: un cliente puede leer y escribir user.* en un fichero remoto, algo que hasta ahora solo funcionaba en local. El soporte incluye cliente y servidor.
El segundo es Zstd para el kernel, el initramfs y el initrd: el compresor de Facebook llega al arranque con una relación de compresión mejor que gzip y una velocidad mucho mayor que xz. Las distribuciones pueden elegir el algoritmo sin cambiar el resto del sistema.
En un directorio compartido por NFS, los xattrs permiten guardar metadatos de herramientas como las de archivos y SELinux sin una base de datos aparte. Zstd no sustituye a gzip por decreto: el cargador prueba los algoritmos y el usuario elige al compilar el kernel o la imagen. Las dos piezas amplían lo que se puede hacer sin trucos: una lleva metadatos que antes se perdían al cruzar la red, la otra acorta el arranque y el tamaño de las imágenes. Los límites: los xattrs de NFS dependen del servidor y de la versión del protocolo; Zstd necesita un cargador que lo entienda. La documentación de NFS recoge las opciones.
9. Gráficos: RDNA 2, Rocket Lake y DG1
El ciclo es el primero con soporte para las GPU RDNA 2 de AMD: los chips sienna_cichlid y navy_flounder reciben IDs de dispositivo y soporte de display, además de las piezas de firmware y gestión de energía que necesitan. Es soporte inicial: arranca y muestra imagen, pero las funciones avanzadas llegan en ciclos posteriores.
En Intel, el ciclo habilita Rocket Lake y da los primeros pasos con DG1, la GPU discreta que Intel estaba preparando. También llegan paneles nuevos para las placas ARM y soporte de rotación y escalado en varios drivers.
El soporte de display de RDNA 2 cubre ya los modos básicos, pero la aceleración 3D completa depende de firmware y de Mesa. Rocket Lake y DG1 llegaron a las tiendas en 2021, meses después de que el kernel los reconociera; el soporte de RDNA 2 se completó en 5.10 y 5.11. El patrón es el de siempre: el kernel reconoce el hardware antes de que se venda y las distribuciones tardan meses en tener la versión que lo usa. Los límites: sin firmware actualizado, una RDNA 2 no pasa de un framebuffer; y DG1 necesitaba piezas que aún no estaban en el árbol. La documentación de DRM describe el modelo.
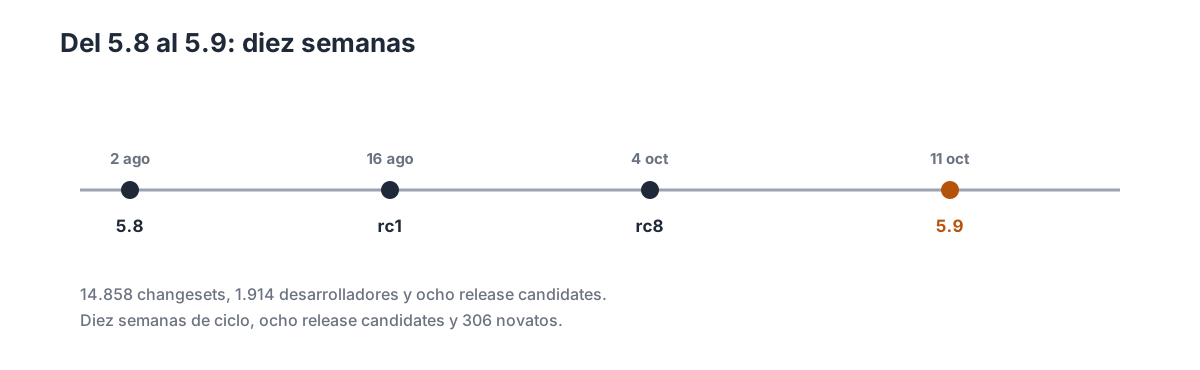
Diez semanas de ciclo, con ocho release candidates y el primer rc8 desde 5.4.
10. Por subsistemas
10.1 Core y herramientas
io_uring estrena lecturas con búfer asíncronas sin depender de un hilo del kernel, y seccomp añade addfd y EPOLLHUP para el notificador. Los pidfd permiten adjuntarse a namespaces de tiempo, y llega la capability CAP_CHECKPOINT_RESTORE.
10.2 Sistemas de ficheros
Btrfs agrupa sus opciones de recuperación en rescue=, ext4 lee por adelantado el mapa de bloques y XFS hace asíncrona la reclamación de inodos. zonefs admite capacidad de zona distinta del tamaño.
10.3 Memoria
La lista anónima y el slab son las claves, y a su alrededor llegan los preparativos de THP en la caché de página, contadores de migración de THP sin split y un vm_committed_as más escalable. slub_debug acepta varios bloques en el parámetro.
10.4 Bloque
dm-crypt mejora su latencia y su rendimiento y admite dispositivos por zonas. blk-cgroup muestra las estadísticas globales en el cgroup raíz y los dispositivos zoned exportan sus límites por sysfs.
10.5 Traza, perf y BPF
BPF añade un evento de text poke para registrar los cambios del código del kernel, un bpf_link para XDP y un hook de liberación de socket. Los iteradores de mapas permiten recorrer elementos desde un programa.
10.6 Networking
MPTCP añade DATA_FIN en el cierre y opciones de socket, la pila mejora DSACK y el UDP segmentation offload. nftables acepta cadenas anónimas.
10.7 Virtualización
VirtualBox mejora la negociación de capacidades del invitado y KVM recibe correcciones. El bloque de cifrado inline también sirve a los discos virtuales.
10.8 Arquitecturas y drivers
ARM suma MStar, Sparx5, Keem Bay, Alpine v3 y SDM630; PowerPC añade spinlocks en cola y un ABI de syscall más rápido. Se retira la arquitectura unicore32.
11. Lo que no llega
La memoria anónima cambia de política, no de tamaño: el beneficio depende de la carga, y un sistema con un solo proceso puede tardar más en calentar. El slab compartido gana memoria pero pierde aislamiento perfecto entre cgroups.
La compactación proactiva gasta CPU y su valor por defecto es conservador. close_range y sk_lookup necesitan que el software las use. FSGSBASE requiere CPU moderna y se puede desactivar.
RDNA 2 es soporte inicial: sin firmware no hay imagen. Y 5.9 no es LTS: la LTS es 5.4, hasta que 5.10 tome el relevo en diciembre, según el calendario de kernel.org.
12. Cambios menores
Ficheros y bloque
Drivers
13. Qué viene después
La merge window de 5.10 se abre el 12 de octubre y cierra el 25 de octubre. Ese ciclo traerá ext4 fast commit, restricciones de io_uring, process_madvise y static calls, según el inventario de KernelNewbies; Linux 5.10 sale el 13 de diciembre y será la LTS de 2020.
Para las distribuciones, 5.9 es la base de Ubuntu 20.10 y Fedora 33, que llegan en octubre con FSGSBASE y Zstd. Las rolling la adoptan en semanas. La LTS sigue siendo 5.4 hasta diciembre.
El ciclo cierra la serie de 2020 con dos releases de transición antes de la LTS. Las próximas releases mostrarán si la memoria anónima cambia de comportamiento en producción, si el slab compartido se nota en escritorios y si RDNA 2 llega a las tiendas con soporte completo.
14. Referencias
- KernelNewbies: Linux 5.9 — inventario completo por subsistema.
- ChangeLog-5.9 — la lista completa de commits.
- LWN: The 5.9 kernel has been released — el anuncio.
- LWN: Proactive compaction for the kernel — el diseño de la compactación.
- Phoronix: Linux 5.9 features — repaso de las novedades.
- kernel.org: releases — calendario y LTS.