Linux 6.0: el número no cambia el kernel, pero io_uring sí
Linus cambia el major por comodidad, no por una ruptura: io_uring, RV, Btrfs send v2 e Intel SGX2 son lo que de verdad llega en 6.0.
Linux 6.0 se ha publicado hoy, 2 de octubre de 2022, y el número es lo de menos: el kernel no rompe interfaces ni cambia de modelo. Lo que sí trae es io_uring con E/S con búfer y cero copias, el sistema de verificación en ejecución RV, Btrfs con send v2 y soporte de Intel SGX2. El ciclo deja 15.402 changesets y 2.034 desarrolladores.
Torvalds lo dejó claro en el anuncio: «the major version number change is more about me running out of fingers and toes than it is about any big fundamental changes». La release sale el domingo 2 de octubre de 2022, nueve semanas después de 5.19 y dentro de la serie 6.x; la merge window de 6.1 se abre al día siguiente con Rust en la cola.
El ciclo no es un récord de participación: 15.402 changesets, 2.034 desarrolladores y 236 novatos, según las estadísticas de LWN. Intel firma 1.724 changesets (11,2 %), Google 1.191 (7,7 %), el trabajo sin empresa 1.019 (6,6 %), Linaro 999 (6,5 %), AMD 934 (6,1 %) y Red Hat 835 (5,4 %). Sean Christopherson encabeza la lista individual con 326, casi todo KVM.
El ciclo tiene tres claves. La primera es la E/S: io_uring madura con escrituras con búfer asíncronas, cero copias y cancelación explícita. La segunda es la confianza: RV comprueba en ejecución que el kernel cumple sus propias reglas, y SGX2 permite cambiar la memoria de un enclave. La tercera es el almacenamiento: Btrfs estrena send v2 y XFS deja de tomar el candado en las búsquedas de búfer.
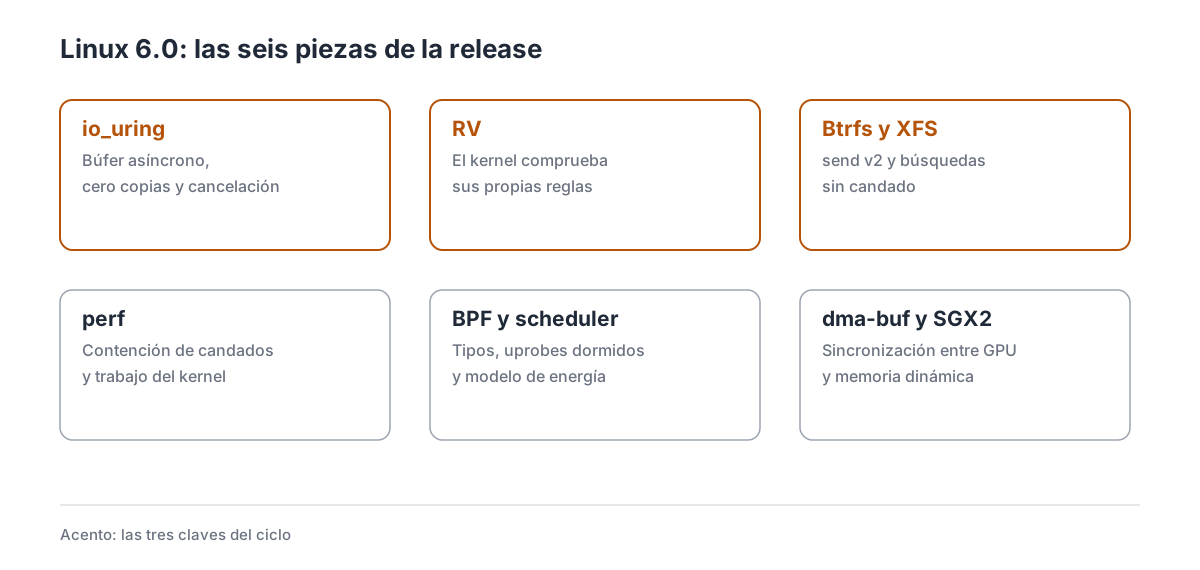
Las seis piezas que explican el ciclo, con las tres claves marcadas en ámbar.
1. Las cifras de un ciclo normal
| Dato | Valor |
|---|---|
| Fecha de release | 2 de octubre de 2022 |
| Versión anterior | 5.19 (31 de julio de 2022) |
| Merge window | 1 al 14 de agosto de 2022 |
| Release candidates | 7 |
| Changesets | 15.402 |
| Desarrolladores | 2.034 |
| Novatos | 236 |
| Líneas añadidas | 1.100.000 |
Las 15.402 changesets añaden algo más de 1,1 millones de líneas, un salto que se explica por las cabeceras de registro de las GPU de AMD, no por código nuevo de verdad. Si se descuentan esos ficheros, el crecimiento es el habitual de un ciclo de nueve semanas. El número de desarrolladores se queda a 52 del récord de 5.19, y los 236 novatos son la cifra más baja en dos años: el ciclo cayó en agosto, con medio proyecto de vacaciones.
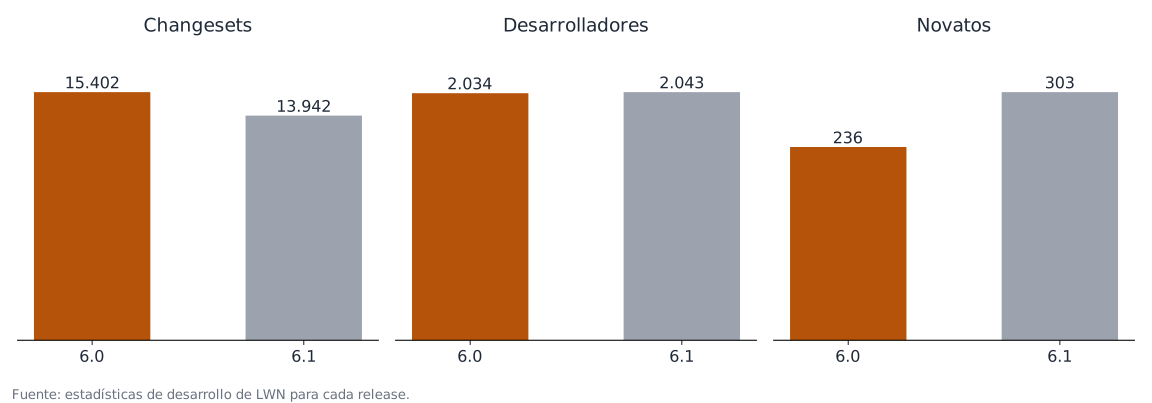
El ciclo de 6.0 comparado con 6.1, según las estadísticas de LWN.
La merge window de 6.0 fue corta y sin sobresaltos: Torvalds cerró la rc7 el 25 de septiembre y publicó la release una semana después, sin retrasos. La cifra que de verdad cuenta es cero: cero interfaces rotas por el cambio de 5.19 a 6.0. El kernel mantiene la compatibilidad binaria con el espacio de usuario desde hace décadas, y un major nuevo no es una excepción. Quien tenga un binario compilado para 5.19 lo ejecuta igual en 6.0.
2. Seis punto cero: el número no es una feature
Cada cierto tiempo, Torvalds decide que el número de versión se ha vuelto incómodo y lo cambia. Pasó con 3.0 en 2011, con 4.0 en 2015, con 5.0 en 2019 y vuelve a pasar con 6.0 en 2022. En el anuncio de 5.19 dejó caer que el siguiente sería 6.0 «since I’m starting to worry about getting confused by big numbers», y LWN lo recogió junto a las estadísticas del ciclo.
El argumento tiene que ver con la contabilidad, no con la ingeniería: con 5.19 a la vista, el siguiente número de la serie menor era 5.20, y después 5.21, y así hasta que el segundo dígito dejara de ser cómodo. Cambiar a 6.0 reinicia el contador de la parte menor y deja margen para veinte releases más. No hay una lista de cambios incompatibles detrás del 6.0, porque el kernel no usa el versionado semántico al estilo de una biblioteca: un major no marca una ruptura, y un minor no marca una feature.
El cambio también obliga a las distribuciones a decidir cómo lo empaquetan: un usuario que compara 5.19 y 6.0 con un sort -V obtiene el orden correcto, pero el que compara la cadena 6.0 con 5.19.1 necesita una herramienta que entienda versiones. La historia de los majors lo confirma: 1.0 llegó en 1994, 2.0 en 1996, 2.2 en 1999, 2.4 en 2001, 2.6 en 2003, 3.0 en 2011, 4.0 en 2015, 5.0 en 2019 y 6.0 en 2022. Entre 2.6 y 3.0 pasaron ocho años y cientos de releases; entre 5.0 y 6.0, tres años y medio. El número no ha predicho nunca el tamaño del cambio. Para contrastar con un esquema que sí promete algo con cada dígito, el blog tiene versionado semántico.
El salseo del ciclo es este: no hubo una decisión técnica detrás, sino una de comodidad, anunciada en la lista y aceptada sin votación. Hubo debate sobre si el cambio confundiría a las distribuciones y a los scripts que comparan versiones, y Torvalds respondió con la frase de los dedos. No hubo pelea de maintainers ni episodio de CoC; el único roce fue el de siempre, el de un número que se lee como si significara algo.
3. io_uring: búfer asíncrono, cero copias y cancelación
io_uring empezó como una forma de hacer E/S de disco sin llamadas al sistema y se ha convertido en una interfaz general. En 6.0 llegan cuatro piezas que cambian lo que un servidor puede hacer con ella.
La primera son las escrituras con búfer asíncronas: hasta ahora, una escritura a un fichero con búfer podía acabar en el hilo de trabajo del kernel, y el rendimiento se resentía. El ciclo añade el camino para que se complete dentro del anillo, con una mejora que KernelNewbies cifra en tres veces para ciertas cargas.
La segunda es el envío con cero copias: un programa puede registrar un búfer y pedir que se envíe por la red sin copiarlo al kernel. La tercera es la cancelación explícita a través de io_uring_register(), para retirar operaciones pendientes sin esperar a que terminen. Y la cuarta son las lecturas multishot, que dejan una operación armada y reciben datos varias veces con una sola petición.
Además, la caché de asignaciones para sendmsg/recvmsg y los pasos de descriptores directos reducen el trabajo por operación. El diseño detrás de todo esto es el mismo: el anillo de envío y el de completación están en memoria compartida entre el proceso y el kernel, y las operaciones se encolan sin una llamada al sistema por cada una. Con IORING_SETUP_SQPOLL, un hilo del kernel se encarga de consumir el anillo, y el proceso solo tiene que leer el anillo de completación. Con esto, io_uring se acerca a lo que prometía: E/S de red y disco con menos llamadas, menos copias y menos esperas.
Los límites: el cero copias exige que el búfer esté registrado y que el driver lo admita, y la API crece tan rápido que las bibliotecas van por detrás. Tampoco hay una forma portable de saber qué operaciones soporta el kernel en tiempo de ejecución: el programa tiene que probar y caer al camino clásico, y esa lógica se repite en cada cliente de io_uring. La página de manual de io_uring recoge las operaciones.
4. RV: el kernel se comprueba en ejecución
El runtime verification no es un test ni un depurador: es un conjunto de monitores que observan eventos del kernel y comprueban que se cumplen las reglas del modelo. Si una regla se rompe, RV lo detecta y deja constancia, con el contexto de lo que estaba pasando.
RV entra en 6.0 como una interfaz dentro de tracefs: se elige un monitor, se activa y se leen los resultados. Los primeros monitores cubren reglas de sincronización y de tiempo, y el diseño permite añadir otros sin tocar el núcleo del sistema. La documentación de RV describe los monitores disponibles.
Cada monitor se describe con un autómata o una fórmula, y el kernel lo alimenta con eventos de trace. Cuando la propiedad se cumple, no pasa nada; cuando se rompe, RV deja constancia del evento y del contexto. La diferencia con un test es el momento: un test comprueba lo que el autor pensó; RV comprueba lo que el kernel hace en producción, con las combinaciones de hardware y carga que nadie reprodujo en un laboratorio. La contrapartida es el coste: cada monitor añade comprobaciones y el sistema no es gratis.
El cambio de número tampoco altera la compatibilidad de los módulos: un módulo compilado para 5.19 no carga en 6.0 porque el kernel no promete eso entre releases, pero un binario de espacio de usuario sí sigue funcionando.
Los primeros monitores se eligen con el parámetro rv_monitors y se activan por tracefs, y cada uno declara qué eventos necesita. Esa separación entre el modelo y el mecanismo es lo que permite añadir monitores sin tocar el núcleo de RV; el trabajo pendiente está en escribir modelos útiles, no en la infraestructura. Los límites: los monitores son pocos en esta primera versión, la interfaz es nueva y el análisis de los resultados requiere conocer el modelo. Tampoco hay una herramienta que traduzca los eventos de RV a un diagnóstico legible: el usuario ve la propiedad rota y el contexto, y a partir de ahí toca investigar. La documentación de tracing describe el ecosistema completo. RV no sustituye a KASAN ni a lockdep; los complementa con una capa de propiedades.
5. Btrfs send v2 y XFS sin candados
Btrfs estrena el protocolo send v2, compatible hacia atrás y con comandos nuevos. send es lo que usan las copias incrementales y las réplicas: el sistema compara dos instantáneas y emite un flujo con los cambios, que receive aplica en otro sitio. La versión 2 permite escribir ficheros por debajo del tamaño de bloque, algo que antes obligaba a reenviar bloques enteros, y mejora el tratamiento de los renombrados y de los extents compartidos.
Con send v2, una réplica incremental deja de reenviar bloques enteros cuando cambia un byte: el flujo describe el rango modificado y el receptor lo aplica. En el mismo ciclo, Btrfs reduce el trabajo de los elementos retrasados y sube el límite de E/S directa de lectura a 256 sectores, con una mejora de hasta tres veces en una carga de muestra. También puede reparar todos los espejos conocidos cuando encuentra un bloque corrupto.
XFS ataca otro cuello de botella: las búsquedas de búfer sin candado. Cada operación de metadatos busca un búfer en una tabla hash, y hasta ahora lo hacía con un candado global. El cambio usa búsquedas lockless con un mecanismo de referencia, y la mejora de escalabilidad de CIL reduce la contención al confirmar transacciones.
El efecto se mide en servidores con muchos hilos: dos copias de Btrfs a la vez, o un XFS con decenas de escritores, dejan de serializarse en un candado. En XFS, el cambio de las búsquedas de búfer se apoya en un contador de referencias por búfer y en un bit de «muerto» que permite liberar sin candado; el precio es que el código de liberación es más delicado y las pruebas de estrés tardaron en cubrirlo. Los límites: send v2 necesita que el receptor lo entienda, así que un receptor antiguo sigue obligando al emisor a usar la versión 1; y las búsquedas lockless de XFS son un cambio interno que no cambia la interfaz, pero que hay que probar con cargas de metadatos intensas antes de confiar en él.
6. perf: contención de candados y trabajo del kernel
perf gana dos herramientas que responden a preguntas que antes exigían instrumentación propia. La primera es perf lock contention: usa los tracepoints de contención de candados y BPF para decir qué candado frena a qué proceso, con el tiempo de espera y el número de veces. En una máquina con una base de datos, eso convierte «va lento» en «espera en este mutex».
La segunda es perf kwork, que mide el tiempo que pasa el kernel en trabajo diferido: softirqs, workqueues y tareas similares. Si el sistema pierde CPU en tareas de fondo, esta herramienta lo muestra por tipo y por duración, en lugar de obligar a leer /proc/softirqs y cruzar los dedos.
perf lock contention funciona con los tracepoints lock:contention_begin y lock:contention_end, que el kernel activa cuando detecta espera en un candado; con BPF, además, puede capturar la pila de llamadas de quien espera y de quien tiene el candado. perf kwork se apoya en los eventos de trabajo diferido para separar softirq, workqueue y tasklet, y ordena el resultado por tiempo acumulado. Las dos herramientas comparten la idea: medir el coste oculto, el que no aparece en el top.
En una máquina con cientos de hilos, perf lock contention puede generar un volumen de eventos que hay que filtrar; la opción de ordenar por tiempo acumulado ayuda, pero no sustituye a saber qué se busca. perf kwork distingue entre softirq, workqueue y tasklet, y puede filtrar por duración para quedarse con los casos que importan; en un sistema con mucho tráfico de red, los softirqs suelen llevarse la mayor parte. Los límites: perf lock contention necesita que el kernel tenga los tracepoints activados y que el usuario tenga permisos; perf kwork depende de la configuración de tracing. La documentación de perf y la de ftrace tienen los detalles.
7. BPF, scheduler y DAMON
BPF añade la comprobación de tipos para consultar qué tipo tiene un objeto en el verificador, el soporte de enums de 64 bits y las uprobes dormidas, que pueden dormir y usar helpers bloqueantes. También entra el enganche LSM por cgroup para aplicar políticas a los sockets de un grupo de procesos, no solo al sistema entero. La documentación de BPF recoge las APIs.
El scheduler mejora el modelo de energía: los cálculos de utilización (PELT) se corrigen para que la elección de frecuencia y de núcleo no penalice a las tareas pequeñas, y se retira código que confundía las métricas. Además, las llamadas de afinidad dejan de pedir capacidades cuando la operación no las necesita, y select_idle_cpu() busca menos en sistemas saturados.
DAMOS es la parte de DAMON que actúa: hasta ahora podía vigilar y avisar, y con esta release puede pedir que una región se mueva a la lista activa o a la inactiva. El caso de uso es un servidor con memoria de sobra y procesos que tocan datos una vez: la LRU clásica los mantiene calientes y DAMOS los enfría. En memoria, DAMON aprende a ordenar las listas LRU con DAMOS: en lugar de limitarse a vigilar el acceso, puede mover páginas entre las listas activa e inactiva para que la LRU refleje mejor el uso real. Es el primer paso para que el kernel decida con datos en lugar de con heurísticas fijas.
Los límites: el ajuste de energía depende de que el hardware exponga los dominios correctos, y DAMON necesita configuración y seguimiento. Ninguna de las tres cosas cambia el comportamiento por defecto de forma radical.
8. dma-buf y SGX2
dma-buf es el mecanismo con el que varios dispositivos comparten un búfer: una GPU lo llena, otra lo lee o lo muestra. El problema es la sincronización: hasta ahora, el proceso tenía que esperar con poll() o con una operación de la GPU, y las APIs modernas como Vulkan quieren algo mejor.
6.0 añade una API para exportar sync files: el kernel crea un descriptor que representa una operación de sincronización, y otro proceso o dispositivo puede esperar sobre él con las interfaces estándar. Es la pieza que faltaba para que la sincronización entre GPU y CPU no dependa de un driver concreto.
La diferencia entre sincronización implícita y explícita es la clave: con la implícita, el driver espera por su cuenta y el proceso no puede hacer nada; con la explícita, el proceso recibe un descriptor y decide cuándo esperar. Vulkan y los compositores llevan años pidiendo lo segundo. En Intel, SGX2 añade la gestión dinámica de memoria de los enclaves: hasta ahora, el tamaño del enclave se fijaba al crearlo; con SGX2, el proceso puede añadir y quitar páginas, cambiar sus permisos y aceptar memoria sin reiniciar el enclave. La contrapartida es que requiere hardware y firmware con SGX2, y que el modelo de amenaza de SGX sigue siendo objeto de discusión.
En SGX2, el flujo típico es crear el enclave vacío, añadir páginas con EAUG, aceptarlas con EACCEPT y cambiar permisos con EMODPE, todo desde el proceso que controla el enclave. Eso permite cargar código y datos a demanda, en lugar de reservar el pico de memoria al arrancar. Los límites: dma-buf necesita que los drivers implementen la exportación, y SGX2 solo está en las CPU Intel que lo admiten. La documentación de dma-buf describe el modelo.
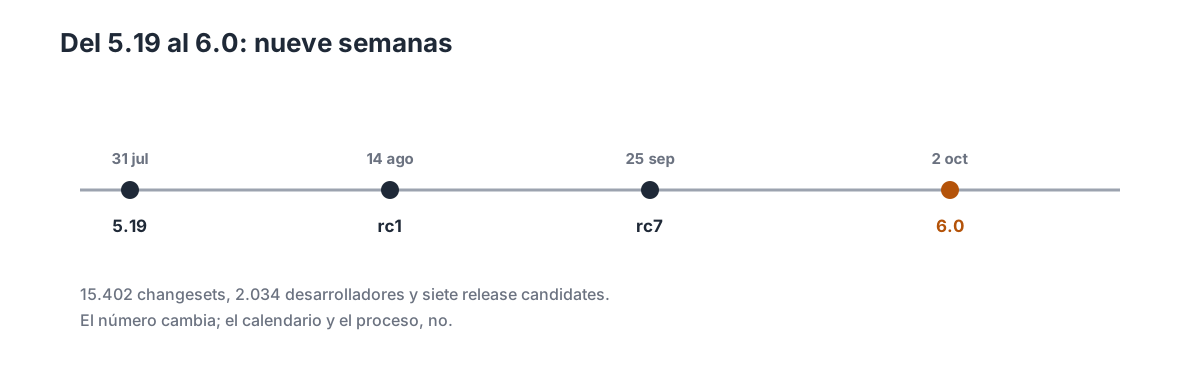
Nueve semanas de ciclo, con siete release candidates y sin retrasos.
9. Por subsistemas
9.1 Core y herramientas
El kernel gana un parámetro hostname para fijar el nombre en el arranque, y fanotify estrena FAN_MARK_IGNORE para ordenar el comportamiento de las marcas. Los montajes con idmap tienen un tipo propio que añade seguridad de tipos, y ublk permite servir dispositivos de bloque desde espacio de usuario. io_uring añade el anillo de descriptores y reduce la contención de las tareas diferidas.
9.2 Sistemas de ficheros
Btrfs permite exportar el tamaño de chunk por sysfs, anuncia soporte de zonas y retira las features MIXED_BACKREF y BIG_METADATA. NFSD reescribe su caché de ficheros, NTFS3 admite FALLOC_FL_INSERT_RANGE, EROFS prepara los folios, FAT acepta RENAME_EXCHANGE y AFS usa folios multipágina.
9.3 Memoria
smaps expone Pss_Dirty, hwpoison admite páginas de 1 GB y mprotect() intenta evitar fallos de escritura en páginas anónimas exclusivas. Los shrinkers tienen interfaz en debugfs, page_pool publica contadores y el código de swap sigue convirtiéndose a folios.
9.4 Bloque y almacenamiento
El bloque alinea la E/S directa con DMA, y dm-verity puede usar tasklets para calcular checksums. UFS suma los controladores FSD y R-Car, y se retira el driver dpt_i2o, una tarjeta de los noventa.
9.5 Networking
Bluetooth estrena sockets isócronos para audio LE, y af_unix pasa a una tabla hash por namespace con una disposición optimizada. El rate limit de los challenge ACK se puede configurar por netns, el bonding añade prioridad por puerto y IPv6 filtra GARP y NA no solicitados. ip6mr gana RTM_GETROUTE.
9.6 Virtualización y seguridad
virtio admite el reset del anillo, virtio_net estrena coalescencia de notificaciones, e ifcvf/vDPA puede consultar el espacio de configuración. VDUSE registra memoria de rebote, KVM expone el pid de los vCPU por debugfs y Xen añade vectores de evento. En seguridad, memfd_secret etiqueta sus inodos anónimos, setgroups() gana hook LSM, uring_cmd también, y LoadPin puede cargar desde dm-verity.
9.7 Arquitecturas
ARM64 recibe la familia Broadcom BCM63178, el NXP i.MX93, el Snapdragon 8cx Gen 3, el Allwinner H616 y el BMC Nuvoton NPCM8XX. En x86, Intel añade Raptor Lake y Meteor Lake, AMD prefiere MWAIT sobre HLT y se activa STIBP para Retbleed. POWERPC gana KASAN en BOOK3E.
9.8 Gráficos y drivers
amdgpu añade DCN 3.2, P2P entre GPU, coredump de dispositivo y la interfaz de perfilado HMM. El panel gana API de orientación, y la criptografía suma HCTR2 y ARIA.
10. Lo que no llega
Rust no está en 6.0: el soporte entra en 6.1, y en este ciclo solo hay discusiones y parches en la lista. Quien leyera el titular del número nuevo y esperara un kernel con Rust se llevó una decepción.
El número 6.0 no arregla nada por sí solo: las distribuciones siguen comparando versiones a su manera, y un script que asuma que 6.0 es «más nuevo» que 5.19 acierta, pero uno que asuma que un major implica cambios incompatibles se equivoca. RV tiene pocos monitores y SGX2 depende del hardware. XFS sigue necesitando el candado en otras rutas.
El cambio de número tampoco cambia el proceso: las correcciones siguen llegando por la rama estable, y las distribuciones siguen eligiendo qué kernel empaquetan. La lectura práctica es que 6.0 es una release de transición: sirve para validar el hardware nuevo y las mejoras de E/S, y deja el relevo a 6.1 en diciembre. Y 6.0 no es LTS: la serie 6.1, que llega en diciembre, es la que se mantiene durante años. Quien instale un servidor en octubre se queda en 6.0 hasta que su distribución salte.
11. Cambios menores
Core y herramientas
- Btrfs commit stats — estadísticas de las confirmaciones.
- ext2 sin nobh — se retira el modo sin buffer-heads.
- slabinfo en debugfs — la herramienta lee los ficheros nuevos.
- ublk sin integridad — se retira
UBLK_IO_F_INTEGRITY.
Memoria
- hugetlb write-fault — fallos de escritura en mapeos compartidos.
- cacheinfo — la topología de caché sale de ahí.
- folios en vma_alloc — conversión del camino de asignación.
Ficheros
- Ceph session notify — aviso de sesión ya abierta.
Networking
- Bluetooth bt_status — estado del adaptador por netlink.
- TCP abort TIME_WAIT —
tcp_abort()alcanza esos sockets. - TLS desde la cola TCP — descifrado sin copia.
- WiFi 7 MLO — más piezas de multi-link.
- tun sin carrier — se puede no activar la portadora.
Virtualización
- vmxnet3 v7 — nueva versión del dispositivo.
- vdpasim suspend — suspensión del dispositivo simulado.
- vhost scsi colas — número de virtqueues configurable.
Plataformas y criptografía
- Surface Laptop Go 2 — soporte del portátil.
- Alder Lake N PMC — contadores de potencia.
- RSA CRT — clave privada más rápida.
- ARCH_RANDOM fuera — se retira la configuración.
12. Qué viene después
La merge window de 6.1 se abre el 3 de octubre y cierra el 16. Ese ciclo traerá Rust al árbol, MGLRU, el maple tree y KCFI; Linux 6.1 sale el 11 de diciembre y se convierte en la LTS de la serie, según el inventario de KernelNewbies. LWN cubrió la ventana de 6.0 en su primera parte.
El relevo de LTS tampoco es inmediato: 5.15 sigue recibiendo correcciones hasta 2026, según kernel.org, así que un servidor puede vivir años sin pasar por 6.0 ni por 6.1. Para las distribuciones, 6.0 es la release de otoño: Ubuntu 22.10 y Fedora 37 la adoptan, y las rolling la tienen en semanas. La LTS sigue siendo 5.15 hasta que 6.1 tome el relevo, así que muchas imágenes de servidor no verán 6.0.
La merge window de 6.1 además llega con una novedad que 6.0 no tiene: el primer código en Rust. Lo que no se sabrá hasta las siguientes releases es si RV se usa fuera de los laboratorios y si dma-buf cambia la sincronización de los drivers gráficos. Tampoco hay fecha para que el cero copias de io_uring llegue a todas las tarjetas.
13. Referencias
- KernelNewbies: Linux 6.0 — inventario completo por subsistema.
- ChangeLog-6.0 — la lista completa de commits.
- Phoronix: Linux 6.0 Released — repaso de hardware y rendimiento.