Linux 6.1: Rust entra en el kernel y la memoria cambia
La primera LTS con Rust dentro: MGLRU, maple tree, KMSAN y KCFI cambian la memoria y la seguridad. 13.942 changesets y 2.043 desarrolladores.
Linux 6.1 se ha publicado hoy, 11 de diciembre de 2022, con el primer código en Rust dentro del árbol, MGLRU para la memoria y un árbol nuevo, el maple tree, que sustituye al rbtree en las estructuras de memoria virtual. El ciclo deja 13.942 changesets y 2.043 desarrolladores, y llega una semana tarde porque Torvalds prefirió no cerrarlo con prisa. Es la LTS de la serie 6.x.
Torvalds lo contó así en el anuncio: «So here we are, a week late, but last week was nice and slow, and I’m much happier about the state of 6.1 than I was a couple of weeks ago». La release sale el domingo 11 de diciembre de 2022, once semanas después de Linux 6.0 y dentro de la serie 6.x; la merge window de 6.2 se abre al día siguiente, con las vacaciones por medio.
El ciclo no es el más grande de la historia, pero sí uno de los que más cambia por dentro: 13.942 changesets y 2.043 desarrolladores, de los que 303 son novatos, según las estadísticas de LWN. Huawei firma 1.281 changesets (9,2 %), Intel 1.254 (9,0 %), el trabajo sin empresa 1.097 (7,9 %), Google 917 (6,6 %) y Linaro 837 (6,0 %). Krzysztof Kozlowski es el primero de la lista individual, casi todo device trees y limpieza de drivers.
Hay tres claves. La primera es Rust, que deja de ser un experimento fuera del tree. La segunda es la memoria: MGLRU cambia la forma de decidir qué se expulsa, y el maple tree cambia la estructura que guarda los mapeos. La tercera es la seguridad: KMSAN encuentra usos de memoria sin inicializar y KCFI cierra el control de flujo con Clang 16. Además hay hardware nuevo, Btrfs más rápido y una retirada sonada.
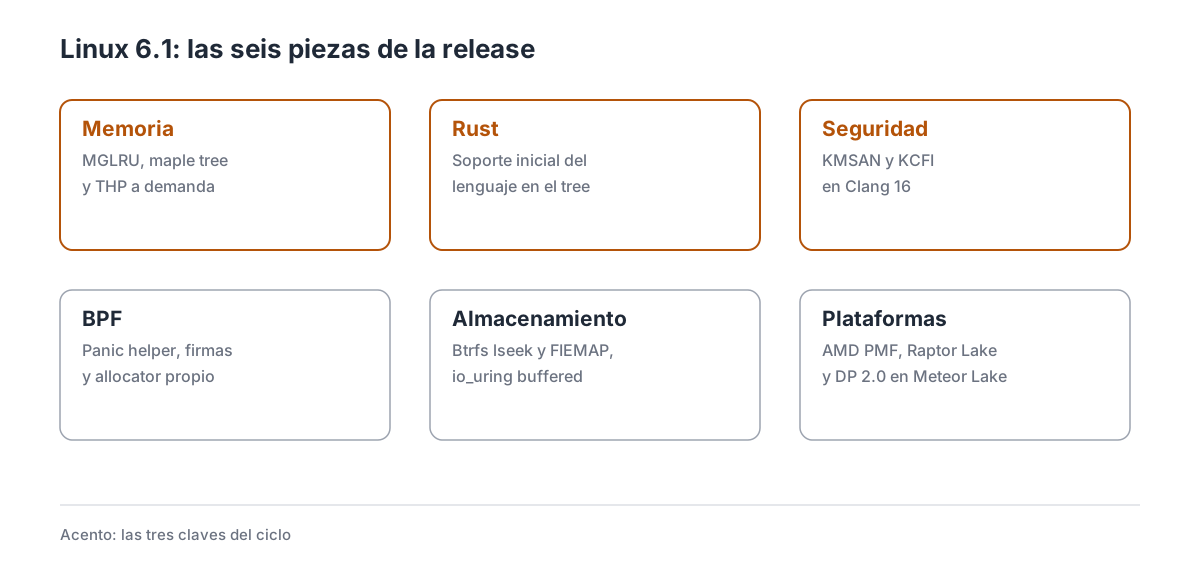
Las seis piezas que explican el ciclo, con las tres claves marcadas en ámbar.
1. Las cifras de una LTS con Rust
| Dato | Valor |
|---|---|
| Fecha de release | 11 de diciembre de 2022 |
| Versión anterior | 6.0 (2 de octubre de 2022) |
| Merge window | 3 al 16 de octubre de 2022 |
| Release candidates | 8 |
| Changesets | 13.942 |
| Desarrolladores | 2.043 |
| Novatos | 303 |
| Líneas añadidas | 412.000 |
Las 13.942 changesets añaden 412.000 líneas al kernel, según el recuento de LWN. No es un ciclo récord en volumen —6.2 lo superará en febrero—, pero sí por lo que cambia por dentro: MGLRU y el maple tree son cambios de estructuras que llevaban años discutiéndose, y Rust entra con código revisado durante meses.
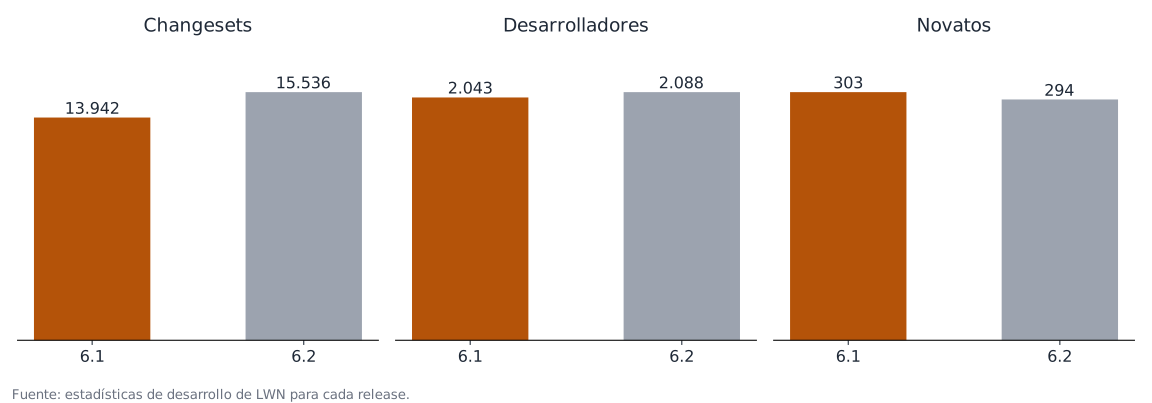
El ciclo de 6.1 comparado con 6.2, según las estadísticas de LWN.
La cifra que de verdad importa es otra: 6.1 es la LTS de la serie 6.x. Greg Kroah-Hartman la mantendrá durante años, y el proyecto Civil Infrastructure Platform la usa como base de sus versiones de diez años. Quien instale un servidor con una distribución LTS acabará en 6.1, no en 6.2. Y quien compile su propio kernel tiene un motivo más para probarla: es la primera release con Rust dentro, aunque no haya nada escrito en Rust que usar.
2. Rust: el primer código en el árbol
Rust llega al kernel después de dos años de discusión, y lo hace de la forma más conservadora posible: el compilador, las abstracciones básicas y un sample que no hace nada útil. No hay drivers en Rust, no hay subsistemas convertidos y no hay promesa de que la API sea estable. Lo que hay es la infraestructura para que un driver se pueda escribir sin C.
El argumento es la seguridad de memoria: Rust detecta en compilación los accesos fuera de rango, los punteros colgantes y las race conditions que en C acaban en CVE. El kernel no puede usar la biblioteca estándar ni el allocator del sistema, así que el tree trae su propio alloc, sus tipos Arc y Box y unas reglas estrictas sobre lo que un módulo puede hacer. La documentación de Rust describe el modelo, y LWN contó el camino en Next steps for Rust in the kernel.
Lo que entra es soporte, no algo terminado: CONFIG_RUST, el compilador rustc en la cadena de herramientas y el rustdoc para generar documentación. Compilar el kernel con Rust exige Clang, bindgen y una versión concreta de rustc, y ninguna distribución lo activa por defecto en ese momento.
Los límites son los de un lenguaje nuevo en un proyecto viejo: la API de Rust cambia con cada release, los maintainers de subsistemas no tienen por qué aceptar código en Rust y la integración con el resto del kernel sigue siendo manual. Lo prometido es a largo plazo; el código, por ahora, es una muestra.
3. MGLRU: la memoria se ordena por generaciones
La LRU clásica mantiene dos listas, activa e inactiva, y mueve páginas entre ellas cuando se acceden. Funciona bien en cargas uniformes y mal cuando el patrón cambia: una página que se usó una vez hace una hora puede quedar por delante de otra que se usa cada segundo. El resultado son expulsiones equivocadas, más E/S y ese síntoma de «el sistema va lento» que aparece cuando la memoria aprieta.
La multi-generational LRU sustituye las dos listas por varias generaciones. Cada generación agrupa páginas con una edad parecida, y el kernel promociona o degrada páginas entre generaciones según se acceden. Cuando hay que expulsar, empieza por la generación más vieja, así que las páginas calientes se quedan y las frías se expulsan sin recorrer listas enteras.
El cambio se nota en cargas con memoria justa: escritorios con muchas pestañas, servidores que ejecutan bases de datos y contenedores, y máquinas con poca RAM y mucho intercambio. Google lo probó en servidores y en Android antes de proponerlo, y LWN lo siguió durante años, desde la primera propuesta hasta el diseño final.
El envejecimiento es periódico: una página que no se toca pasa a la generación siguiente, y una que se toca vuelve a la más joven. min_ttl_ms decide cuánto tiene que vivir una página antes de ser candidata, y las estadísticas de /sys/kernel/debug/lru_gen dicen cuántas páginas hay en cada generación. El coste está en el escaneo: MGLRU recorre páginas para envejecerlas, y en un sistema con mucha memoria y poco movimiento eso se nota en CPU. Por eso el ajuste permite desactivarlo por completo o limitarlo a las páginas anónimas. Se activa con CONFIG_LRU_GEN y se ajusta en /sys/kernel/mm/lru_gen/enabled; la documentación de MGLRU explica los modos. Los límites: consume algo de CPU en el escaneo, el ajuste automático no es perfecto y en máquinas con memoria de sobra no cambia nada perceptible.
4. Maple tree: el árbol que sustituye al rbtree
Los mapeos de memoria de un proceso están en un árbol rojo-negro desde hace décadas. Es un árbol equilibrado, razonable para insertar y buscar, pero no para recorrer rangos ni para leer sin candados: cada operación toca punteros que otro hilo puede estar modificando.
El maple tree es un B-tree pensado para rangos y seguro con RCU. En lugar de un nodo por mapeo, guarda intervalos en nodos anchos, con lo que un recorrido toca menos caché y una lectura concurrente no necesita bloquear a los escritores. El primer usuario es la estructura de memoria virtual (mm_struct), y está previsto mover también el intervalo de inodos y otras estructuras que hoy usan rbtree más una lista auxiliar.
El beneficio no se mide en un benchmark: es menos contención: el árbol de mapeos se consulta en cada fallo de página y en cada mmap(), y en máquinas con muchos hilos eso se convierte en un punto caliente. LWN explicó el diseño en Introducing maple trees.
Los límites: la conversión es incremental y durante un tiempo conviven las dos estructuras; el maple tree ocupa más memoria por nodo, y su API es nueva para los maintainers. Quien depure un fallo de memoria en 6.1 verá nombres distintos en las trazas.
5. KMSAN y KCFI: encontrar fallos y cerrar el control de flujo
KMSAN es el sanitizer de memoria del kernel: detecta usos de valores sin inicializar, un tipo de fallo que en C pasa desapercibido hasta que provoca una decisión errónea o una fuga de datos. Se basa en instrumentación del compilador y funciona como MemorySanitizer en espacio de usuario: cada byte de memoria lleva una sombra que dice si está inicializado, y cada operación comprueba la sombra.
La infraestructura de KMSAN entra en 6.1 con soporte para x86_64 y Clang. No es para producción: multiplica el consumo de memoria y ralentiza el sistema, y está pensado para la integración continua y el laboratorio. La documentación de KMSAN explica cómo activarlo.
KCFI es lo contrario: una defensa para producción. El esquema anterior, CONFIG_CFI_CLANG, exigía LTO, reescribía las referencias a funciones para que apuntaran a una tabla y rompía la igualdad de direcciones. KCFI comprueba el tipo de la función en cada llamada indirecta con una instrucción y un identificador, sin LTO y sin tocar la dirección. Reemplaza la implementación de arm64 y añade x86_64, y necesita Clang 16.
En KCFI, el compilador inserta un identificador de tipo antes de cada función y la llamada indirecta compara ese identificador con el del destino; si no coincide, el kernel aborta. En KMSAN, cada acceso comprueba la sombra antes de leer el valor, y el fallo se atribuye a la función que lo provocó. Las dos se activan por configuración: CONFIG_KMSAN necesita Clang y una compilación instrumentada, y CONFIG_CFI_CLANG elige KCFI cuando el compilador lo admite. En la práctica, KMSAN corre en los bots de pruebas (syzbot lo usa) y KCFI va en kernels de producción endurecidos.
Las dos piezas cubren extremos distintos del mismo problema: KMSAN encuentra el fallo antes de que salga, KCFI limita lo que un atacante puede hacer con él. La contrapartida es la cadena de herramientas: KCFI obliga a compilar con Clang, y KMSAN añade una comprobación por acceso.
6. Memoria por niveles y THP a demanda
La memoria de un servidor moderno ya no es uniforme: hay DDR5 junto a la CPU, CXL más lejos y, en algunos diseños, memoria de varios niveles con latencias distintas. Colocar una página en el nivel equivocado cuesta rendimiento, y el kernel necesitaba una forma explícita de decir qué niveles hay.
6.1 añade niveles de memoria y demotion: el administrador declara los niveles en sysfs y el kernel puede mover páginas frías de un nivel rápido a uno lento, en lugar de expulsarlas. Un algoritmo nuevo elige mejor qué páginas están calientes, con contadores de acceso por página en lugar de muestras del LRU. LWN lo discutió en Memory tiering.
En paralelo, THP deja de ser solo automático: madvise(MADV_COLLAPSE) permite a un proceso pedir que un rango se colapse en una página gigante en su propio contexto, y con process_madvise() también sobre otro proceso. El caso de uso son bases de datos y runtimes que saben qué regiones van a crecer y quieren pagar el coste del colapso en un momento controlado. LWN lo contó en User-controllable huge pages.
La demotion escribe la página en el nivel lento en lugar de mandarla al swap, así que el proceso la recupera con una falta de página normal y no con una lectura de disco. El usuario tiene más control y el kernel obtiene más información: la memoria por niveles deja de ser una suposición y THP deja de decidirse solo por heurística. Los límites: el demotion necesita hardware con niveles distintos y una configuración manual, y MADV_COLLAPSE puede fallar si la memoria está fragmentada.
7. BPF: pánico, firmas y un allocator propio
BPF sigue creciendo en todas las direcciones. La novedad más llamativa es bpf_panic(): un programa puede provocar un pánico controlado para que el kernel vuelque la memoria en el momento exacto en que ocurre el fallo, algo que antes requería instrumentar el kernel y tener suerte. Es una función destructiva, pensada para depuración y no para producción.
El precio es el privilegio: cargar un programa que puede provocar un pánico exige capacidades de administración, y en un sistema con lockdown el kernel puede rechazarlo. En seguridad, los programas pueden verificar firmas PKCS#7 desde el kernel, con lo que un programa de seguridad puede validar un binario o un módulo sin delegar en espacio de usuario. El memory allocator de BPF da a los programas un allocator propio, seguro para los contextos donde kmalloc() no se puede usar, y el ring buffer de publicación desde usuario permite que un proceso escriba eventos que los programas leen sin copias.
También llegan kfuncs para leer el reloj TAI, soporte de argumentos de estructura en los trampolines y programas de cgroup para ping sin privilegios. LWN cubrió el pánico y las firmas en BPF updates y el allocator en A BPF memory allocator.
La tendencia es clara: BPF pasa de ser un motor de filtros a un entorno de ejecución con memoria, criptografía y control del sistema. La contrapartida es la superficie: cada kfunc nueva es una API que hay que mantener y un privilegio que hay que revisar.
8. PSI por cgroup y Btrfs más rápido
Pressure Stall Information mide cuánto tiempo pierden las tareas esperando CPU, memoria o E/S. En 6.1 gana dos cosas: contabilidad por cgroup, para saber qué grupo de procesos sufre la presión, y un recurso nuevo, PSI_IRQ, que mide el tiempo perdido atendiendo interrupciones y softirqs. Con eso, un administrador puede distinguir «este contenedor va lento porque no tiene CPU» de «va lento porque la máquina se pasa el día atendiendo interrupciones».
En almacenamiento, Btrfs acelera lseek() y FIEMAP de forma drástica: en lugar de recorrer el árbol de extensiones, usa el árbol de rangos para responder en tiempo casi constante. También admite escrituras con búfer asíncronas por io_uring, reduce la memoria del scrub y prepara el árbol de grupos de bloque que acelerará el montaje.
El efecto se mide en herramientas: un du, una copia incremental o un docker build sobre Btrfs hacen miles de lseek() y FIEMAP, y ahí es donde se ve el cambio. En io_uring, las escrituras con búfer dejan de pasar por el hilo de trabajo y bajan la latencia.
Leer PSI es sencillo: /proc/pressure/{cpu,memory,io,irq} da los totales del sistema y cada cgroup tiene su propio cpu.pressure, memory.pressure e io.pressure cuando la contabilidad está activa. Lo que no hay es una herramienta estándar que lo interprete; cada distribución y cada sistema de monitorización lo lee a su manera. Los límites: PSI_IRQ tiene coste y no está activo por defecto en todas las configuraciones; el árbol de grupos de bloque es una feature de formato que hay que activar, y las mejoras de Btrfs no arreglan un sistema ya fragmentado.
9. El salseo: una semana de retraso y la ventana «from Hell»
Linux 6.1 no salió el 4 de diciembre, como tocaba. Torvalds retrasó la release una semana porque el ciclo no terminaba de estabilizarse, y lo explicó sin rodeos: la semana anterior había ido con calma y prefería un 6.1 sólido a un calendario bonito. La nota de LWN recoge el mensaje completo, con el aviso de que la merge window de 6.2 sería «the merge window from Hell».
El motivo es logístico: la ventana de 6.2 caía justo antes de las vacaciones y con Torvalds de viaje, así que el retraso de una semana movió todo el calendario a la peor fecha posible. No hubo pelea de maintainers ni episodio de CoC: el salseo del ciclo es el de un proyecto que decide cuándo parar y paga el coste.
La decisión tuvo consecuencias prácticas: Linux 6.2 llegó el 19 de febrero, diez semanas después, con un ciclo más largo de lo habitual. Y el retraso dejó una lección para el calendario: cuando la ventana cae en vacaciones, el coste se paga en la release siguiente. Y dejó una idea que vuelve cada diciembre: el kernel no se publica para cumplir una fecha, sino cuando el tree está listo.
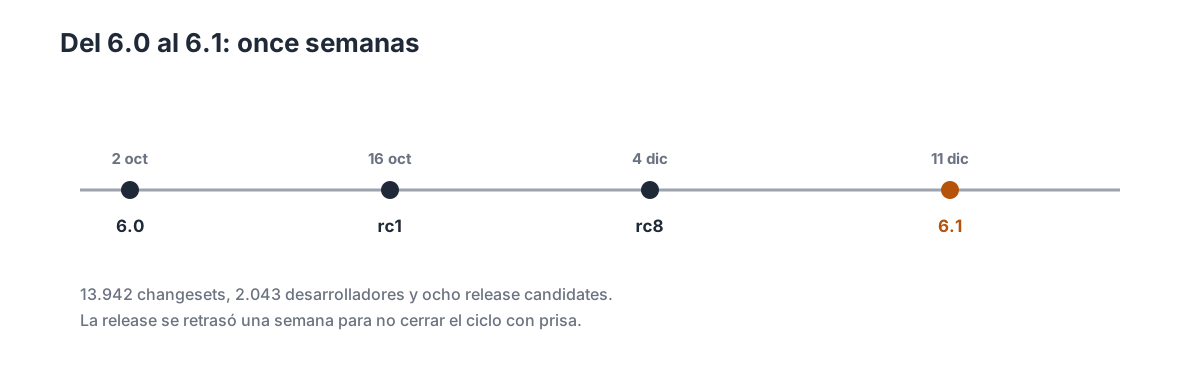
Once semanas de ciclo, con ocho release candidates y una semana extra de margen.
10. Por subsistemas
10.1 Core y herramientas
cgroup estrena pids.peak para saber cuántos procesos llegó a tener un grupo, y cpuset mejora las particiones de CPU. Dynamic debug permite clases de depuración por módulo, y fortify añade un aviso en tiempo de ejecución para los memcpy() entre campos. El soporte de a.out desaparece: un formato de binario que ya nadie compila.
10.2 Sistemas de ficheros
Ext4 hace que statx() devuelva la alineación de la E/S directa, retira las opciones noacl y nouser_xattr y deja el camino libre a los montajes con idmap. EROFS estrena dominio compartido y fragmentos comprimidos, F2FS expone cp_status por sysfs, y Btrfs permite enviar con fs-verity. SMB mejora las notificaciones de cambios y los enlaces simbólicos.
10.3 Memoria
KASAN pasa a una pila de etiquetas en lugar de metadatos por objeto, y KFENCE se puede desactivar por caché desde sysfs. shmem recibe conversiones a folios, KSM cuenta sus rmap_items y memcg reduce su consumo por cgroup. zswap deja de ser experimental, tmpfs gana i_version y las migraciones conservan los bits young/dirty.
10.4 Bloque
Las operaciones passthrough del bloque reciben optimizaciones y caché de asignaciones, y nvme estrena iopoll para io_uring. ublk se recupera si el proceso que lo atiende crashea, sed-opal puede consultar el estado del dispositivo y virtio_blk admite SECURE ERASE. AHCI reconoce el controlador Baikal-T1.
10.5 Red
TCP permite tablas hash por namespace para reducir la contención en servidores con muchos contenedores, y MPTCP añade TCP_FASTOPEN_CONNECT. Llegan MACsec con offload, CAN XL, Bluetooth Mesh y taprio con queueMaxSDU. TLS gana ARIA-GCM, y DECnet se retira después de décadas.
10.6 Arquitecturas
ARM64 recibe el SoC MediaTek MT8186, el TI AM62A y el NXP i.MX8DXL, además del Sony Xperia 1 IV y dos servidores con AST2600. En x86, AMD estrena PMF y su IOMMU v2, Intel añade Raptor Lake y Alder Lake-N, y llega ARIA con AVX.
10.7 Gráficos y plataformas
amdgpu añade gang submit, reset Mode2 en RDNA2 y DSC pass-through, e i915 prepara DP 2.0 en Meteor Lake. AMD expone estadísticas de GFXOFF y MediaTek estrena DisplayPort en MT8195. También entran el driver de Type-C de plataforma y el de sensores de Surface.
10.8 Virtualización y seguridad
Xen habilita virtio con grants en x86, y KVM corrige el orden del dirty ring en arquitecturas con ordenación débil. En seguridad, el kernel añade el hook userns_create para que un LSM decida si se puede crear un namespace de usuario, una de las vías de escalada más usadas.
11. Lo que no llega
Rust ya está dentro, pero no se usa: no hay drivers en el árbol, y el código que existe es una muestra y las abstracciones. Quien quiera un driver real tendrá que esperar a 6.2 o más. MGLRU no es universal: se puede activar, pero el ajuste depende de la carga y en máquinas con mucha memoria no cambia nada.
KMSAN solo funciona con Clang y no es para producción; KCFI también exige Clang 16, que entonces aún no está en todas las distribuciones. La memoria por niveles necesita hardware con niveles distintos y configuración manual. MADV_COLLAPSE puede fallar si la memoria está fragmentada.
Y 6.1 es LTS, pero eso no significa que todas las distribuciones la adopten a la vez: las que congelan en primavera llegan a 6.2 o 6.3. Greg Kroah-Hartman mantiene la rama 6.1.y con correcciones, y el proyecto CIP la usa como base de sus versiones de diez años para hardware industrial, con parches propios encima. La LTS no arregla los límites técnicos que cuenta este post; solo hace que las correcciones se mantengan durante más tiempo.
12. Cambios menores
Core
/dev/userfaultfd— control de acceso fino para userfaultfd.- kunit en el arranque — parámetro para activar las pruebas.
patcheden sysfs — estado de los parches en vivo por objeto.- módulos descargados — debugfs para ver los que se descargaron.
strtomem()— copia de cadenas sin ambigüedad.
Memoria
- KFENCE por caché — se puede desactivar en slabs concretos.
- memcg más barato — optimización del camino de cargo.
- delayacct reentrante — contabilidad de thrashing más fina.
- SLUB y kmalloc — depuración del desperdicio de memoria.
Bloque y ficheros
- ext4
statx— alineación de la E/S directa. - F2FS errores — los errores se guardan en el superbloque.
- GFS2 debugfs — informes de PID por debugfs.
- nvmet colas — máximo de colas por configfs.
Networking
- SMC
SO_REUSEPORT— reparto de conexiones entre sockets. - GRO por hardware — paquetes ya agregados por la tarjeta.
- PSE genérico — alimentación por Ethernet.
- DSA multi-CPU — varios puertos de CPU en un switch.
Plataformas
- AMD PMF CnQF — ajuste de potencia por clase.
- SMU por sysfs — estado de la SMU en AMD.
- Beelink GT1 — device tree de la caja Amlogic.
- JetHub D1p — placa de automatización.
13. Qué viene después
La merge window de 6.2 se abre el 12 de diciembre y cierra el 25, con las vacaciones en medio y Torvalds de viaje; Linux 6.2 sale el 19 de febrero de 2023. Ese ciclo traerá Intel Arc estable, RTX 30 en Nouveau, una mitigación de Retbleed más barata y el primer driver de dispositivo en Rust, según el inventario de KernelNewbies.
El calendario explica el número de release candidates: ocho, uno más de lo habitual, porque la ventana se abrió justo después de 6.0 y el árbol arrastraba cambios de un ciclo corto. Torvalds cerró la ventana con un aviso a los maintainers —lo que llega debe estar listo antes de que abra, no durante— y el resto del ciclo fue de correcciones. Para las distribuciones, 6.1 es la release que las distribuciones adoptan a largo plazo: Debian 12, Ubuntu 23.04 y las imágenes de servidor la usarán durante años, y el proyecto CIP la mantiene diez. Las rolling la cambian en semanas, y quien quiera las funciones que lleguen después tendrá que esperar a 6.2 o 6.3.
Hasta las siguientes releases no se sabrá si MGLRU convence en cargas reales frente a la LRU clásica y si el maple tree se extiende más allá de la memoria. Tampoco hay fecha para el primer driver en Rust, que llegará cuando un maintainer acepte uno.
14. Referencias
- KernelNewbies: Linux 6.1 — inventario completo por subsistema.
- ChangeLog-6.1 — la lista completa de commits.
- LWN: Kernel coverage — índice de artículos por release.
- LWN: The rest of the 6.1 merge window — lo que entró en la ventana.
- kernel.org: releases — la LTS y su mantenimiento.