Linux 6.10: memoria que no se puede tocar
Una syscall impide cambiar los permisos de la memoria, Wine gana primitivas de Windows y el TPM cifra su bus: 13.312 changesets en un ciclo sin sobresaltos.
Linux 6.10 se ha publicado hoy, 14 de julio de 2024, con una syscall que impide cambiar los permisos de un trozo de memoria, un perfilador que señala qué línea de código reserva cada byte y las primitivas de sincronización de Windows dentro del kernel. El ciclo ha durado nueve semanas y deja 13.312 changesets, el recuento más bajo desde 5.17. También es la release que declara obsoleto ReiserFS y la que abandona los Alpha anteriores al EV56.
El ciclo más ligero en dos años termina hoy: Linux 6.10 se ha publicado este domingo 14 de julio de 2024, nueve semanas después de 6.9 y dentro de la serie 6.x. Torvalds despide el ciclo con una queja y un alivio: «the final week was perhaps not quite as quiet as the preceding ones, which I don’t love - but it also wasn’t noisy enough to warrant an extra rc». Buena parte de ese ruido es bcachefs, con netfs pisándole los talones. La merge window de 6.11 se abre al día siguiente.
El volumen baja: 13.312 changesets sin merges de 1.918 desarrolladores, de los que 242 son novatos, con 203 empresas identificadas. Es el recuento más bajo desde 5.17 y confirma que el ciclo de nueve semanas ya es lo habitual. Intel firma el 15,3 % de los cambios, casi todos en drivers gráficos y de plataforma.
Hay tres claves. La primera es la memoria: mseal() sella mapeos para que no se puedan tocar y el perfilador de asignaciones dice qué función pide cada byte. La segunda es la compatibilidad con Windows: NTSYNC lleva al kernel las primitivas de sincronización del NT, aunque en esta release no se pueda activar. La tercera es el hardware: Panthor para las Mali modernas, TPM con el bus cifrado y los primeros pasos de Zen 5. Estas son las claves; el resto de cambios está al final.
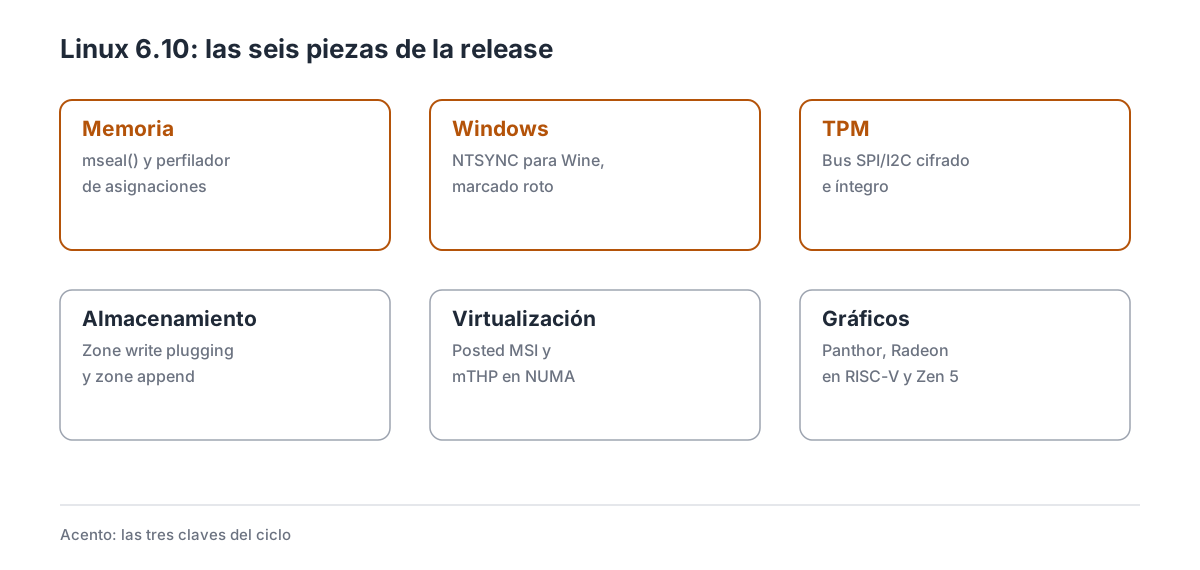
Las seis piezas de la release, con las tres claves resaltadas.
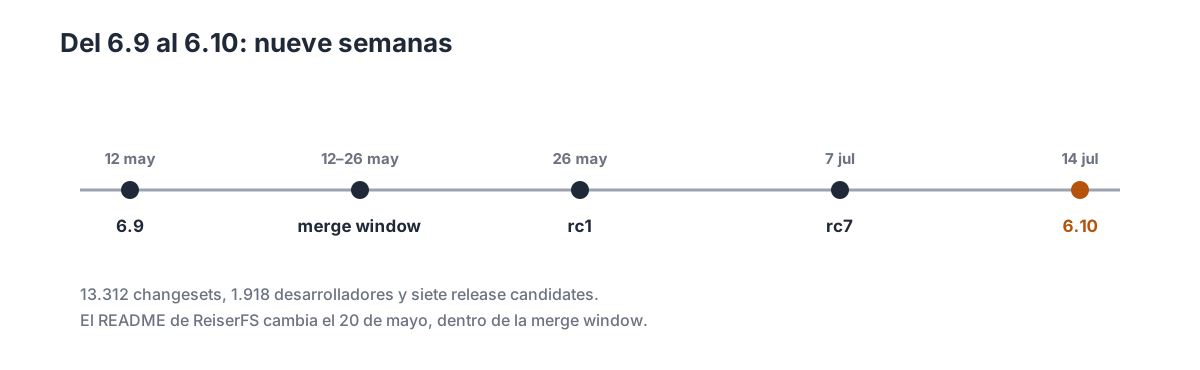
Del 6.9 al 6.10: la merge window, siete release candidates y la carta que llegó a tiempo.
1. Las cifras de un ciclo corto
| Dato | Valor |
|---|---|
| Fecha de release | 14 de julio de 2024 |
| Versión anterior | 6.9 (12 de mayo de 2024) |
| Merge window | 12 al 26 de mayo de 2024 |
| Release candidates | 7 |
| Changesets | 13.312 |
| Desarrolladores | 1.918 |
| Novatos | 242 |
| Empresas | 203 |
Krzysztof Kozlowski encabeza la lista por changesets con 357, casi todos limpiezas de drivers y devicetree. Le siguen Kent Overstreet, con 270 y el foco en bcachefs, y Andy Shevchenko, con 226. En líneas modificadas el reparto cambia: Dmitry Baryshkov borra decenas de miles de líneas de cabeceras que ahora se generan al compilar, y Darrick J. Wong trabaja en la reparación en línea de XFS.
El ChangeLog-6.10 tiene la lista completa de commits, y LWN publica las estadísticas del ciclo un día después de la release. La merge window se abre el 12 de mayo, el mismo día de 6.9, y cierra el 26 con 6.10-rc1. A partir de ahí, siete release candidates y una fecha de salida que no se mueve.
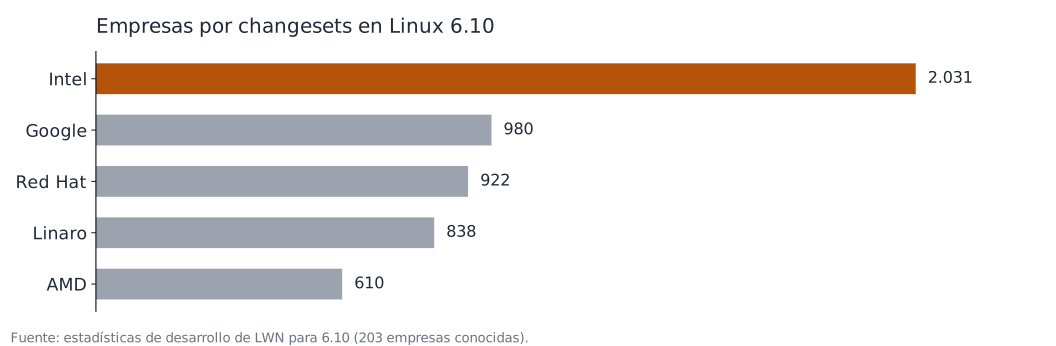
Quién paga el trabajo del ciclo, por changesets; Intel firma el 15,3 %.
Intel aporta 2.031 changesets, Google 980 y Red Hat 922. Linaro, con 838, es la cuarta, y AMD la sexta, con 610. El reparto no cambia mucho de una release a otra: las mismas empresas mantienen los mismos subsistemas, y por eso el kernel avanza a pesar de los altibajos de cada ciclo.
2. mseal(): memoria que no se puede tocar
Los permisos de memoria de una CPU moderna distinguen entre leer, escribir y ejecutar. Un atacante que consigue un puntero corrupto no puede saltar a una página de datos, pero sí puede llamar a mprotect() y convertir esa página en ejecutable. La protección cubre el contenido, pero el mapa que describe cada página sigue a su alcance.
mseal(2) cierra esa puerta. La syscall, firmada por Jeff Xu, sella un rango de memoria virtual: a partir de ese momento, mprotect(), munmap(), mremap() y los mapeos con dirección fija sobre ese rango fallan con EPERM. El sello se guarda en la estructura del mapeo, se hereda en fork() y no se puede quitar. La documentación lo compara con precintar una caja: se puede seguir accediendo al contenido, pero la caja ya no se abre ni se mueve.
El caso de uso es cualquier región que deba permanecer fija. Un motor de JavaScript reserva memoria para su heap y para el código compilado; una biblioteca carga tablas de solo lectura; un proceso largo monta estructuras que no deberían moverse. Si esas regiones se sellan, un fallo de corrupción de memoria deja de convertirse en ejecución de código. LWN siguió la propuesta desde su primera versión, y el debate se centró, como siempre, en cuánto cuesta y quién lo usa.
Hay un límite claro. mseal() no impide escribir dentro de una región que ya es escribible ni protege contra un read() mal calculado; solo impide que cambie el mapa. Tampoco sirve para memoria que crece, como la pila, ni para un malloc() que necesite devolver páginas al sistema. Para el usuario significa que las aplicaciones pueden blindar sus estructuras críticas, pero solo si su autor decide hacerlo y solo después de terminar de montarlas.
3. Un perfilador que dice quién pide memoria
Cuando un servidor se queda sin memoria, el top dice qué proceso se la come, pero no qué parte del código la pidió. El perfilador de asignaciones que entra en 6.10 responde a la segunda pregunta: recorre todas las reservas del sistema y las agrupa por la línea de código que las hizo.
La base es el marco de code tagging, una biblioteca que declara estructuras estáticas con el fichero y la línea de cada punto de reserva. Encima, el trabajo de Suren Baghdasaryan y Kent Overstreet convierte cada llamada a kmalloc() o alloc_pages() en una macro que anota la etiqueta en la tarea que reserva. El resultado se lee en /proc/allocinfo, con el tamaño total, el número de llamadas y la procedencia de cada bloque; la versión del formato también aparece en la cabecera.
La documentación insiste en que no es una herramienta solo para kernels de depuración: la sobrecarga es lo bastante baja para dejarla en producción, Un administrador puede ver que un módulo concreto pierde memoria sin reproducir el fallo en un laboratorio. El precio es una opción de compilación más y un árbol que crece con las etiquetas; las asignaciones que no pasan por las funciones instrumentadas no aparecen.
4. NTSYNC: las esperas de Windows llegan al kernel
Wine traduce las llamadas de Windows a llamadas de Linux, pero hay una familia que no tiene equivalente directo: los objetos de sincronización del NT. Mutex, semáforos, eventos y eventos con clave se emulan en espacio de usuario con futex, y esa emulación cuesta. En un juego con miles de hilos esperando turnos, el coste se nota en los fotogramas.
El driver NTSYNC, de Elizabeth Figura (CodeWeavers), crea /dev/ntsync, un dispositivo de carácter en el que cada descriptor abierto representa una instancia NT aislada. Wine deja de inventar la semántica y se la pide al kernel, que puede dormir y despertar hilos con las mismas reglas que Windows. LWN explicó el diseño en Windows NT synchronization primitives for Linux, y la interfaz de usuario está documentada en el árbol.
Hay una trampa: en 6.10 el driver llega marcado como roto. Su Kconfig incluye depends on BROKEN, así que una configuración normal no puede activarlo. La marca sigue en 6.11, 6.12 y 6.13, y desaparece en Linux 6.14, cuando por fin se puede compilar y usar. Para quien use Proton, la vía está abierta, pero en esta release todavía no hay nada que probar.
5. El TPM deja de hablar en claro
El TPM es un chip pequeño conectado por un bus lento, normalmente SPI o I2C. Guarda las claves con las que se cifra el disco y responde a las peticiones del sistema operativo. El chip y la CPU se comunican por un cable, y quien tenga acceso físico puede interceptarlo: los ataques de interposición, pasivos o activos, leen y modifican lo que pasa por ahí.
Se demostró la recuperación de claves de BitLocker por esta vía, y el mismo ataque funcionó contra las soluciones de disco cifrado con TPM de Linux. La respuesta llega en 6.10: el kernel cifra e íntegra el bus del TPM2 con sesiones HMAC y protección de parámetros. El chip genera un par de claves a partir de una semilla nula en cada arranque, y el kernel usa ese material para que un interpositor no pueda leer ni alterar la conversación.
La serie de James Bottomley añade las funciones de derivación de claves que exige el TCG, un nombre de clave nula exportado por sysfs y una página de documentación que explica el modelo, añadida en el mismo commit de documentación. El límite: es para TPM 2.0 discretos, no para los TPM por firmware como Intel PTT, y exige que el driver del chip y el firmware sepan trabajar con el nuevo protocolo. Para el usuario significa que el disco cifrado deja de depender de que nadie toque el cable, y que el arranque ya no puede escudarse en la comodidad.
6. La memoria grande deja de partirse
Las páginas transparentes gigantes empezaron siendo un tamaño único, 2 MB, y hoy admiten varios: 64 KB, 512 KB, 2 MB. Cuanto más grande es el folio, menos entradas de tabla de páginas y menos fallos de TLB, pero también más difícil colocarlo. En una máquina con varios nodos NUMA, el balanceo automático movía páginas pequeñas entre nodos y se negaba a mover las grandes.
6.10 permite que el balanceo NUMA migre folios de varios tamaños, siempre que el mapeo sea exclusivo. El algoritmo sigue la misma estrategia que para los folios de mayor tamaño: mide los accesos, decide si el folio está lejos de quien lo usa y lo mueve. Además, la swap puede sacar folios grandes sin partirlos antes, lo que reduce el trabajo en máquinas con poca memoria; la guía de páginas transparentes explica los tamaños.
Un servidor con varios zócalos mantiene la memoria cerca de la CPU que la usa, sin renunciar al ahorro de las páginas grandes. La limitación es la habitual: solo afecta a memoria anónima, y el beneficio depende de que la carga tenga un patrón de acceso estable. En un portátil de un solo nodo no cambia nada.
7. Discos por zonas: el bloque ordena las escrituras
Un disco por zonas, como un disco duro SMR o un SSD ZNS, no se puede escribir en cualquier orden: cada zona empieza por el principio y avanza. El bloque tenía un mecanismo para respetarlo, el bloqueo de escritura por zona, pero estaba en mq-deadline y solo funcionaba con ese scheduler; SCSI lo quitó al mover la lógica. Apilar dispositivos encima, como dm o ublk, rompía la garantía.
La release introduce el zone write plugging, obra de Damien Le Moal, que mueve el control al bloque y lo aplica a cualquier scheduler. Cada zona tiene su lista de escrituras en curso, y el bloque las ordena antes de enviarlas. El cambio también permite emular zone append con escrituras normales en los discos que no lo admiten de forma nativa, como los SMR.
El efecto se ve en el almacenamiento por capas: un volumen lógico o un dispositivo de usuario sobre un disco por zonas ya no tiene que replicar la lógica. En almacenamiento, este ciclo también trae ruido. Torvalds se queja en el anuncio de que la última semana llegó cargada de correcciones de bcachefs y netfs, aunque ninguna le pareció peligrosa. XFS y Btrfs también trabajan, y sus cambios están en los subsistemas.
8. Interrupciones que se agrupan antes de molestar a la CPU
Un NVMe de gama alta puede generar cientos de miles de interrupciones por segundo, repartidas entre muchas colas. Cada una obliga a la CPU a entrar y salir del kernel, y ese viaje tiene un coste fijo que se paga millones de veces. En servidores con varios dispositivos por núcleo, el coste deja de ser despreciable.
6.10 añade posted MSI, una técnica que el hardware ya usaba para inyectar interrupciones en máquinas virtuales y que ahora también funciona en el host. El kernel reserva una estructura por CPU y la IOMMU apunta allí las interrupciones; el hardware deja el aviso y una sola entrada del kernel procesa el lote. El trabajo es de Jacob Pan y Thomas Gleixner, entre otros.
El límite es el hardware: hace falta un x86 con IOMMU y remapeo de interrupciones, y un dispositivo que genere muchas colas. En un portátil no se nota. Para el usuario significa que los servidores con mucho almacenamiento rápido pierden menos tiempo en atender avisos, y que la virtualización de gama alta tiene más margen.
9. Panthor, Radeon en RISC-V y Zen 5
Las GPU Mali modernas cambiaron la forma de darles trabajo: en vez de un gestor de trabajos, usan un frontend de flujo de comandos, CSF, con colas gestionadas por firmware. Panfrost no las cubría bien, y 6.10 estrena Panthor, un driver nuevo para esa familia, con las bindings de device tree que describen el hardware. El objetivo inmediato es la Mali-G610 del RK3588, la placa que usan muchas tarjetas ARM de bajo consumo.
En Intel, el driver xe añade los identificadores de Battlemage, enciende la pantalla de Lunar Lake y suma Arrow Lake H. En AMD, el soporte de Zen 5 crece, llega SMU 14.0 y mejora ROCm/AMDKFD en las APU pequeñas de Ryzen. La noticia más curiosa está en RISC-V: las GPU Radeon ya pueden mostrar imagen en RISC-V gracias a la API unificada de FPU en modo kernel, que permite a un driver usar coma flotante sin guardar el estado del usuario.
También entran la infraestructura inicial de DRM Panic, que dibuja un mensaje en pantalla cuando el kernel muere, el giroscopio de la Steam Deck en hid-steam y más piezas para las GPU de Tegra. El límite: Panthor necesita firmware y una pila de usuario que aún madura, y el soporte de Zen 5 es inicial, no completo.
10. Rust llega a RISC-V y el Alpha viejo se queda atrás
Rust en el kernel dejó de ser una curiosidad de x86 y ARM. 6.10 permite compilar módulos Rust en RISC-V de 64 bits, con los mismos requisitos que en las otras arquitecturas. El cambio es de Miguel Ojeda y no trae drivers nuevos: amplía el terreno donde se puede escribir código seguro sin salir de mainline.
En x86, el ABI x32 gana shadow stack, la pila de sombras de CET que detecta retornos manipulados. En Alpha, la limpieza va en la otra dirección: se abandona el soporte anterior al EV56 y se retiran las máquinas basadas en LCA y APECS, mientras se añade clone3. ARM64 estrena la opción arm64.no32bit_el0 para arrancar sin ABI de 32 bits, y LoongArch suma IPI paravirtualizadas.
El kernel sigue reduciendo el código que ya nadie puede probar, y las arquitecturas nuevas incorporan herramientas. El límite: quien tenga una Alpha anterior al EV56 se queda en 6.9, y el soporte de Rust sigue dependiendo de una cadena de herramientas concreta.
11. La carta desde la cárcel que despidió a ReiserFS
ReiserFS fue el primer sistema de ficheros con journaling que entró en Linux, y durante años fue la opción rápida para servidores pequeños. Su creador, Hans Reiser, cumple condena en California por el asesinato de su esposa, Nina Reiser. El sistema de ficheros siguió en el kernel, sin maintainer activo y con fama de frágil.
En enero de 2024, Fredrick Brennan publicó en LKML una carta de Reiser sobre la retirada de ReiserFS V3. En ella pedía una sola cosa para la última release: que el README acreditara a Mikhail Gilula, Konstantin Shvachko y Anatoly Pinchuk, y que borrara los comentarios negativos que él mismo había escrito sobre por qué no aparecían. «It is time to let go», escribía.
Jan Kara, de SUSE, envió el parche que recorta el README y el cambio entró en la merge window el 20 de mayo, dentro del pull de sistemas de ficheros. 6.10 marca ReiserFS como obsoleto y Linux 6.13 borra el código. La release cumple la última petición de su creador antes de retirar su sistema de ficheros.
No hay nada técnico que celebrar: ReiserFS V3 tenía fallos conocidos y nadie lo mantenía. Pero este episodio explica mejor que ningún documento de proceso cómo funciona esta comunidad. Un hombre en prisión escribe una carta, un maintainer de SUSE la convierte en un parche de dos líneas y Torvalds lo integra. El crédito llega veinte años tarde.
12. Por subsistemas
12.1 Core e io_uring
io_uring mejora el envío con cero copias: ahora puede agrupar varios búferes en un solo envío y coalescer las notificaciones, con lo que el zerocopy empieza a compensar a partir de unos 3.000 bytes. También llegan retoques en accept, la posibilidad de inyectar un resultado en un NOP y un fcntl que dice si dos descriptores apuntan al mismo fichero. En tracing, el ring buffer se puede mapear en memoria desde espacio de usuario, y las workqueues ganan disable_work(). Rust sube a la versión 1.78 del compilador.
12.2 Almacenamiento y sistemas de ficheros
XFS estrena el intercambio atómico de rangos con XFS_IOC_EXCHANGE_RANGE, que cambia dos trozos de fichero de sitio sin copiarlos, y avanza en los parent pointers y la reparación en línea. Btrfs acelera el camino NOCOW y añade un shrinker para los mapas de extensión. EROFS gana compresión Zstandard, FUSE estrena fs-verity y overlayfs implementa ficheros temporales. NFS deja de habilitar la versión 2 por defecto.
12.3 Red
El TCP gana fraglist GRO, que encadena varios paquetes para reenviarlos juntos en routers pequeños sin offload. af_unix reescribe su recolector de basura, la pila puede usar hilos SMP para el backlog de NAPI y llega el soporte de Power over Ethernet. También hay un listado de PHY y seguimiento de topología de enlaces, y MPTCP suma mejoras pequeñas.
12.4 Seguridad y virtualización
Landlock puede restringir ioctl() sobre ficheros de dispositivo, lo que permite confinar un proceso que habla con el hardware. IMA gana agilidad criptográfica para el hash de plantilla y las firmas funcionan sobre sistemas de ficheros apilados. En virtualización, virtio-fs admite varias colas, vduse puede crear dispositivos de red y pvpanic sabe apagar la máquina de forma ordenada.
12.5 Drivers y hardware
El cifrado de disco con AES-XTS usa VAES y AVX10/512 en las CPU modernas de Intel y AMD, con más rendimiento por ciclo. AMD suma SVA e IOPF en su IOMMU, Intel añade RAPL para Arrow Lake y Lunar Lake, y UFS reconoce el Tensor GS101 de Google. También entra el driver vfio para las funciones SR-IOV del Intel QAT y más IDs PCI para DG2.
13. Lo que no llega
NTSYNC es el caso más claro: el código está y su interfaz está documentada, pero depends on BROKEN impide activarlo. Quien quiera probarlo tendrá que esperar a Linux 6.14, donde la marca desaparece. Panthor tampoco está terminado: necesita firmware, y la pila de usuario (Mesa con PanVK) aún no cubre todo lo que cubrirá después; su documentación detalla qué hace cada bloque.
El soporte de Zen 5 es inicial. El kernel reconoce las CPU y ajusta lo básico, pero funciones como la telemetría o algunos sensores llegan en releases posteriores. Radeon en RISC-V es display, no aceleración 3D: sirve para tener una consola y un escritorio, no para jugar.
mseal() no es universal: hay que adoptarla en cada programa y solo vale para regiones que no cambien. Landlock restringe ioctl() pero no todos los dispositivos ni todos los comandos. mseal() tampoco protege contra todo: impide cambiar los permisos de un rango, pero no impide que el propio proceso reescriba los datos antes de sellarlo, ni cubre los mapeos creados por el cargador antes de que el programa arranque. Y 6.10 no es LTS: quien necesite una LTS se queda en 6.6 hasta la próxima, y las distribuciones que congelan kernel en otoño saltarán directamente a 6.11.
14. Cambios menores
Core
- fcntl: F_DUPFD_QUERY — saber si dos descriptores apuntan al mismo fichero sin abrirlo otra vez.
- statx: stx_subvol — identificar el subvolumen de Btrfs de un fichero.
- sysrq: replay log — volcar el log del kernel en la consola a petición.
- workqueues: disable_work() — bloquear ejecuciones futuras de un trabajo ya encolado.
- Rust 1.78 — nueva versión del compilador y de las APIs de asignación.
Sistemas de ficheros
- btrfs: shrinker de mapas de extensión — devuelve memoria en cargas con muchos ficheros abiertos.
- btrfs: NOCOW más rápido — un 9 % más de rendimiento en la prueba del propio parche.
- EROFS: Zstandard — mejor compresión en imágenes de solo lectura.
- overlayfs: tmpfile —
O_TMPFILEfunciona sobre capas superpuestas.
Bloque
- brd: discard — el disco en RAM libera páginas al recibir un discard.
- dm-crypt: high_priority — marcar los workqueues de cifrado como prioritarios.
Networking
- tcp: fraglist GRO — reenvío más barato en routers sin offload.
- af_unix: GC — menos bloqueos al cerrar sockets con datos pendientes.
Virtualización
- virtio-fs: multi-queue — más rendimiento con varios núcleos.
- vduse: red — dispositivos de red virtuales en espacio de usuario.
15. Qué viene después
La merge window de 6.11 se abre el 15 de julio, un día después de la release, y cierra el 28; LWN cubre la segunda mitad. Ese ciclo traerá getrandom() en el vDSO, escrituras atómicas y los primeros drivers de bloque en Rust, según el inventario de KernelNewbies, además del choque entre Torvalds y bcachefs que marcará el verano. Linux 6.11 sale el 15 de septiembre.
Para las distribuciones, 6.10 es una release de paso. Las que siguen el kernel rolling la adoptan en semanas; las que congelan versión en otoño saltan a 6.11, y las que se quedan en una LTS no la verán. La siguiente LTS será la última release de 2024, así que 6.10 se queda en tierra de nadie: demasiado nueva para quien espera una LTS y demasiado vieja para quien quiere las novedades del otoño.
Hasta la siguiente versión no se sabrá si NTSYNC cumple lo que promete. El código está en el tree desde hoy, pero sin la marca BROKEN no hay forma de medirlo. Esa prueba, y la del soporte de Zen 5, llegarán en las releases siguientes.
16. Referencias
- KernelNewbies: Linux 6.10 — inventario completo por subsistema.
- LWN: The 6.10 kernel has been released — resumen del anuncio.
- Phoronix: Linux 6.10 features — repaso de las novedades del ciclo.
- Anuncio de Torvalds en LKML — el correo original con el shortlog.
- Phoronix: AMD Ryzen e Intel Core en Linux 6.10 — 400 benchmarks de contexto.