Linux 6.6: EEVDF, shadow stack y LTS
El scheduler EEVDF sustituye a CFS, llega el shadow stack de Intel y tmpfs gana cuotas: 14.069 changesets y la LTS de 2023.
Linux 6.6 se ha publicado hoy, 29 de octubre de 2023, con un scheduler nuevo después de dieciséis años de CFS, la pila de sombras de Intel y cuotas en tmpfs. El ciclo deja 14.069 changesets y 1.978 desarrolladores, y es la release que el proyecto designa como LTS de 2023. También es el ciclo en el que bcachefs se queda a las puertas.
Torvalds cierra sin drama: «So this last week has been pretty calm, and I have absolutely no excuses to delay the v6.6 release any more, so here it is». Linux 6.6 sale el domingo 29 de octubre de 2023, nueve semanas después de 6.5 y dentro de la serie 6.x; la merge window de 6.7 se abre al día siguiente.
El ciclo es normal en volumen: 14.069 changesets de 1.978 desarrolladores, de los que 249 son novatos. Krzysztof Kozlowski encabeza la lista con 311, casi todos devicetree y limpiezas de drivers; le siguen Yangtao Li, con 296 y mucho trabajo de conversión a APIs nuevas, y Konrad Dybcio, con 188 en drivers de Qualcomm. Por empresas, Linaro firma 1.333 changesets (9,5 %), Intel 1.221 (8,7 %) y Huawei 962 (6,8 %).
Hay tres claves. La primera es el scheduler: EEVDF sustituye a CFS y cambia la forma de repartir la CPU. La segunda es la seguridad: llega el shadow stack de Intel y el allocator puede repartir cachés aleatorias. La tercera es el sistema: tmpfs gana cuotas, el kernel empieza a poder compilarse sin buffer-heads y 6.6 se convierte en la LTS del año. Estas son las claves; el resto de cambios está al final.
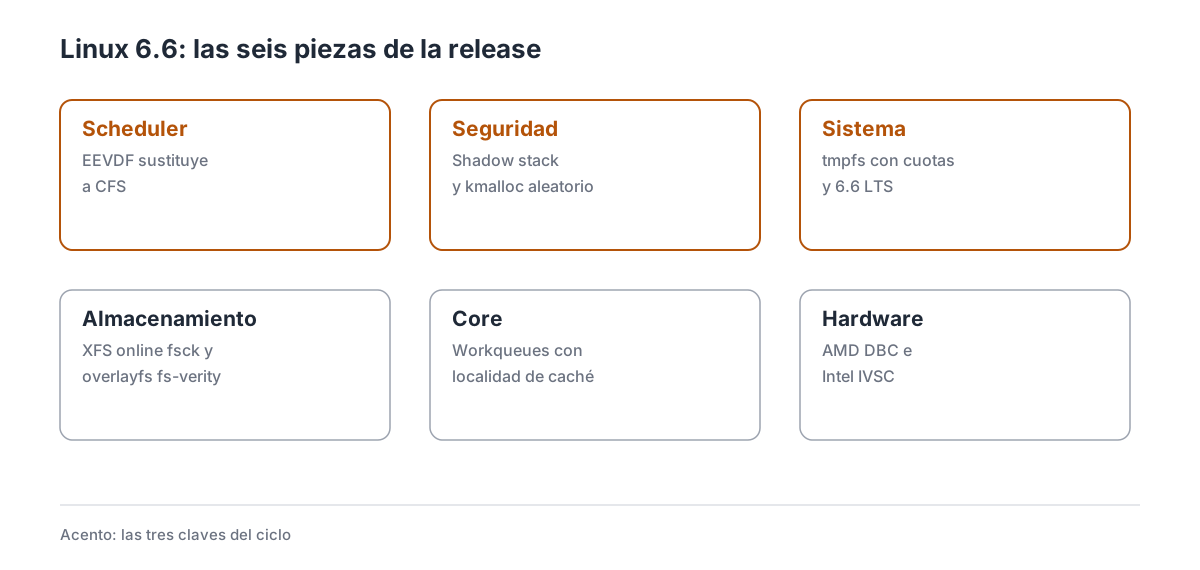
Las seis piezas de la release, con las tres claves resaltadas.
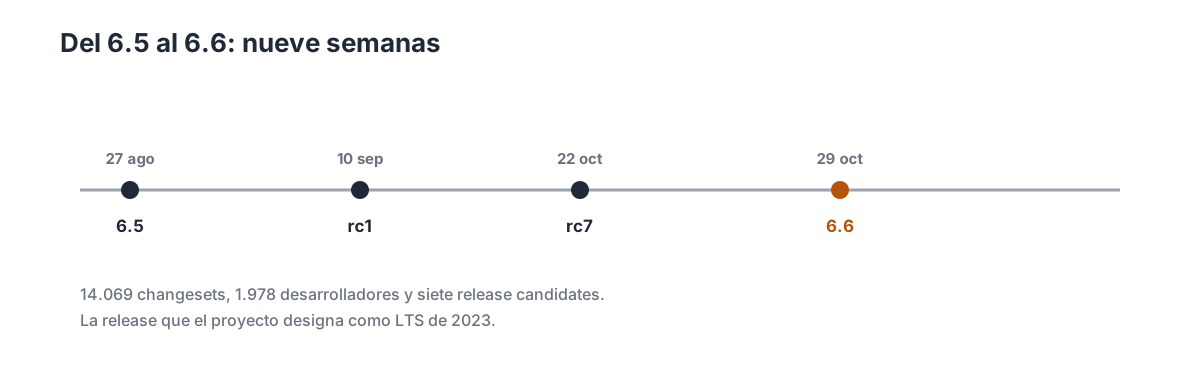
Del 6.5 al 6.6: nueve semanas, siete release candidates y una LTS.
1. Las cifras de un ciclo normal
| Dato | Valor |
|---|---|
| Fecha de release | 29 de octubre de 2023 |
| Versión anterior | 6.5 (27 de agosto de 2023) |
| Merge window | 28 de agosto al 10 de septiembre de 2023 |
| Release candidates | 7 |
| Changesets | 14.069 |
| Desarrolladores | 1.978 |
| Novatos | 249 |
Las cifras son las habituales de la serie 6.x: no son un récord ni un ciclo corto. Lo que cambia es el reparto: Kozlowski y Li suman más de 600 changesets entre los dos, casi el 4,5 % del total, y el resto de la lista se reparte entre maintainers de drivers y de arquitecturas.
Por empresas, Linaro supera a Intel por primera vez en varios ciclos, empujada por el trabajo de ARM64 y de placas nuevas. Huawei y Red Hat mantienen su peso, y Google aparece quinta con 937 changesets. Las estadísticas de LWN tienen el desglose y lo describen como el final de un «superciclo» de desarrollo.
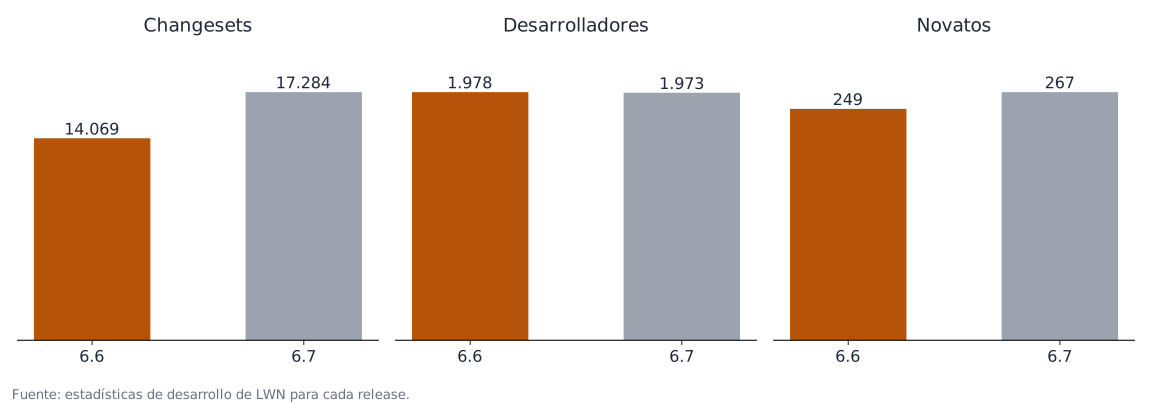
El ciclo de 6.6 comparado con el récord de 6.7, según las estadísticas de LWN.
2. EEVDF: el scheduler cambia después de dieciséis años
CFS lleva más de quince años decidiendo qué proceso usa la CPU. Su modelo es el de un reparto equitativo: cada tarea acumula tiempo de ejecución y el scheduler elige la que menos ha usado, con heurísticas y parámetros ajustables para que la cosa funcione en cargas muy distintas.
6.6 lo sustituye por EEVDF, «Earliest Eligible Virtual Deadline First». El algoritmo calcula cuánto tiempo «debe» cada tarea según su peso, mide la diferencia con lo que ha recibido (el lag) y da prioridad a las tareas que están por debajo de lo que les toca, con un plazo virtual como desempate. Las que van sobradas esperan. El modelo tiene menos parámetros que ajustar y más cálculo.
El cambio se ve en la latencia de las tareas que CFS postergaba: un proceso interactivo que compite con uno que consume mucha CPU recibe turno antes. LWN lo explicó en An EEVDF CPU scheduler for Linux, y el artículo original de la conferencia describe el algoritmo.
El límite es que un scheduler nuevo siempre trae ajustes: las cargas que afinaban parámetros de CFS notan diferencias, y las releases siguientes siguen puliendo el reparto. Para el usuario significa que el escritorio responde mejor cuando algo se come la CPU, y que el rendimiento ya no depende de tantos parámetros.
3. Shadow stack: la pila que no se puede tocar
Los ataques de retorno a la libc (ROP) funcionan reescribiendo la dirección de retorno en la pila. El procesador guarda esa dirección en un sitio que el programa puede modificar, y ahí está el agujero. Intel añadió a su arquitectura CET una segunda pila, la shadow stack, que el software no puede escribir y donde el procesador guarda una copia de cada retorno.
6.6 activa esa pila para el espacio de usuario en kernels de 64 bits, con soporte de 32 bits solo a través de la emulación IA32. Cuando el procesador vuelve de una función, compara las dos copias y, si no coinciden, provoca una falta de protección de control. Un atacante que consigue sobrescribir la pila normal ya no puede redirigir la ejecución sin que el hardware lo detecte.
La condición es que hace falta hardware con CET, un kernel de 64 bits y una cadena de herramientas que marque los binarios; el soporte llegó a glibc después. LWN repasó el diseño en User-space shadow stacks. Los programas compilados con la opción adecuada quedan protegidos contra ROP, y la protección se activa binario a binario, no para todo el sistema a la vez. Ese detalle es importante: una biblioteca sin CET sigue siendo vulnerable, y el kernel no puede forzarla sin romperla. Por eso el despliegue real depende de que las distribuciones recopilen con la opción activada y de que los programas que generan código en tiempo de ejecución, como los navegadores, sepan marcar sus propias pilas.
4. tmpfs gana cuotas y xattrs
tmpfs es el sistema de ficheros que está en memoria y que usan /tmp, /dev/shm y los contenedores. Hasta ahora no tenía cuotas: un proceso podía llenar la memoria del sistema con ficheros temporales sin que nadie lo parara.
6.6 añade cuotas de usuario y de grupo a tmpfs, además de atributos extendidos de usuario y desplazamientos de directorio estables. Las cuotas de proyecto llegarán después. En un contenedor, eso permite limitar cuánta memoria puede gastar en /dev/shm sin recurrir a cgroups de memoria; en un escritorio, evita que un programa llene la RAM con temporales.
La contrapartida es que las cuotas se configuran y se mantienen, como en cualquier sistema de ficheros, y que tmpfs sigue sin ser persistente. Un administrador puede poner techo al uso de memoria temporal sin tocar el resto del sistema.
5. fchmodat2 y el kernel sin buffer-heads
fchmodat() tiene un problema de diseño: no admite AT_SYMLINK_NOFOLLOW ni AT_EMPTY_PATH, y las aplicaciones han tenido que rodearlo durante años. 6.6 añade fchmodat2(), una versión con flags que permite cambiar permisos de un enlace simbólico sin seguirlo y de un fichero abierto por descriptor.
En el mismo ciclo empiezan los trabajos para compilar un kernel sin buffer-heads, la estructura que durante décadas ha mediado entre el bloque y el sistema de ficheros. La idea es que los sistemas de ficheros modernos puedan usar folios y bio directamente, sin la capa intermedia. Es el principio de un cambio largo, no una función que se note hoy.
El límite es que fchmodat2 necesita que las aplicaciones la usen, y que el kernel sin buffer-heads aún no está terminado. La API de permisos se arregla por fin, y el bloque empieza a perder capas intermedias.
6. kmalloc con cachés aleatorias
El heap spraying consiste en llenar la memoria con datos controlados para que un fallo de corrupción caiga en un sitio predecible. Una forma de dificultarlo es que el allocator no use siempre la misma caché para el mismo tamaño.
6.6 añade cachés aleatorias para kmalloc(), una opción de endurecimiento que reparte las asignaciones entre varias cachés del mismo tamaño. Es opt-in: hay que activarla en la configuración del kernel, y añade un poco de memoria y de complejidad.
La contrapartida es que no detiene un ataque dirigido, solo lo hace más caro, y que el rendimiento puede resentirse en cargas con muchas asignaciones pequeñas. Para el usuario significa que el kernel ofrece una defensa más contra la explotación de fallos de memoria, y que quien la active tendrá que configurarla.
7. XFS online fsck y overlayfs con fs-verity
XFS lleva años trabajando en poder repararse sin desmontar. 6.6 incluye las primeras piezas de la infraestructura de online fsck: las estructuras para recorrer el árbol y comprobar metadatos mientras el sistema está en marcha. La función completa llega en releases posteriores, y 6.6 deja varias piezas listas: contadores de uso para el scrubber, el escaneo de los ficheros de resumen de tiempo real, la posibilidad de forzar la reconstrucción de metadatos y correcciones en la comprobación de mapeos de bloque. Cada pieza se prueba por separado antes de que la reparación en línea pueda usarse de verdad.
En paralelo, overlayfs aprende a validar los ficheros de la capa inferior con fs-verity mediante el atributo overlay.verity. El caso de uso es Composefs: una capa EROFS de solo lectura que redirige a una capa de datos verificada, de modo que el contenido no cambia sin que el kernel lo detecte.
La contrapartida es que ambas cosas son infraestructura: no hay una herramienta que diga «repara esto» ni una capa Composefs en todas las distribuciones. El almacenamiento empieza a poder repararse y verificarse en caliente, que es lo que piden los servidores grandes.
8. AMD DBC e Intel IVSC
AMD añade el Dynamic Boost Control, una interfaz del coprocesador de seguridad que permite ajustar el límite de potencia de la plataforma dentro de un rango, pensada para portátiles y equipos pequeños. Intel suma el driver del Visual Sensing Controller, el chip que gestiona la cámara y los sensores de proximidad en los portátiles con IPU.
También avanzan los drivers gráficos: Meteor Lake sigue sumando piezas, AMD prepara sus próximas GPU y Nouveau mejora el soporte de las tarjetas con firmware GSP, que será la norma en 6.7. La contrapartida es el hardware que aún no está en la calle o que necesita firmware.
9. 6.6 es la LTS de 2023
El proyecto elige una release al año como LTS, y la de 2023 es 6.6. kernel.org la mantiene con Greg Kroah-Hartman y Sasha Levin y fija su fin de soporte en diciembre de 2027. Eso significa parches de seguridad y correcciones durante cuatro años, no una congelación: la rama 6.6.y recibe versiones cada pocas semanas.
Para las distribuciones es la release que adoptan los sistemas conservadores: Debian, Ubuntu LTS y las imágenes de servidor suelen esperar a la LTS en lugar de saltar a cada versión. Para el usuario significa que instalar 6.6 da cuatro años de soporte, y que las funciones de 6.7, 6.8 y 6.9 llegarán a su distribución con cuentagotas o a través de backports.
El límite es que la LTS no incluye funciones nuevas: solo correcciones. Quien quiera EEVDF con todos sus ajustes o el driver Xe tendrá que mirar releases más nuevas.
10. El salseo: bcachefs se queda a las puertas
bcachefs llevaba años intentando entrar en el kernel, y en la merge window de 6.6 volvió a quedarse fuera. LWN lo cuenta en el resumen de la ventana: Torvalds no estaba contento de que el código no hubiera pasado nunca por linux-next y de que tuviera problemas que las pruebas amplias habrían detectado. «Cualquier cambio adicional se hace mejor dentro del tree», escribió, y dejó la puerta abierta para 6.7.
El resumen de LWN enlaza la discusión completa y el mensaje de Torvalds en el que explica el motivo. Un ciclo después, bcachefs entra en 6.7 con toda su historia de desarrollo y casi 3.000 commits.
El episodio tuvo coletazos: durante semanas, el parche de bcachefs y sus correcciones se revisaron en la lista a la vez que el resto de la ventana, y buena parte del trabajo de 6.7 consistió en arreglar lo que las pruebas de mainline revelaron. Es más una lección de proceso que una pelea: un sistema de ficheros entra en el kernel cuando ha pasado por las pruebas de dentro, no por llevar años fuera. El código que nunca ha pisado linux-next no ha visto las configuraciones ni las arquitecturas que mainline sí prueba.
11. Workqueues con afinidad, y BH para los tasklets
Las workqueues son el mecanismo con el que medio kernel aplaza trabajo: un driver recibe una interrupción y encola una función que se ejecutará después en un hilo del kernel. Las unbound no están atadas a ninguna CPU y se repartían dentro de cada nodo NUMA, lo que en procesadores con varias cachés L3 (sobre todo ARM64) hacía que un trabajo acabara lejos de los datos que necesitaba.
6.6 introduce los ámbitos de afinidad: el trabajo se coloca cerca de la CPU que lo generó, con la posibilidad de configurar el compromiso entre localidad y utilización. El valor por defecto aplica una afinidad suave, y quien tenga una carga concreta puede ajustarla por workqueue. La idea es que el scheduler no tenga que adivinar dónde conviene ejecutar cada tarea diferida.
En paralelo, las workqueues ganan el modelo BH, que ejecuta trabajos con la prioridad de un softirq. Eso permite convertir tasklets en workqueues sin cambiar su semántica, y abre la puerta a eliminar los tasklets, una API que arrastra las limitaciones de los años noventa.
El cambio es de infraestructura y se nota en cargas concretas: redes con muchas colas, almacenamiento NVMe y virtualización son los escenarios donde la localidad importa. La contrapartida es que el fine-tuning requiere conocer la carga, y que los tasklets siguen existiendo mientras se migran los drivers. La documentación de workqueues describe los ámbitos y las opciones.
12. io_uring habla con sockets, y se puede apagar
io_uring dejó de ser una API solo para ficheros: 6.6 añade soporte de comandos para sockets, de modo que un servidor puede aceptar, leer, escribir y cerrar conexiones desde el anillo sin una llamada al sistema por operación. Para un proxy o un servidor de bases de datos con muchas conexiones cortas, eso elimina una parte del coste que queda incluso con io_uring para disco.
El rendimiento de la E/S directa asíncrona también mejora: el ciclo reduce el trabajo por petición en el camino de iomap, y las pruebas que cita KernelNewbies hablan de hasta un 37 % más de rendimiento con poca profundidad de cola. En la parte de hilos, io-wq recibe mejoras de bloqueo que reducen la contención cuando hay muchos trabajadores.
Y hay una novedad para administradores: el sysctl io_uring_disabled permite desactivar io_uring en todo el sistema, algo que algunas distribuciones endurecidas pedían desde hace tiempo. Se puede bloquear del todo o dejar solo los anillos ya creados.
La tensión es la de siempre: más superficie de ataque a cambio de menos latencia. Un servidor que no use io_uring puede apagarlo y quitarse el problema de encima; uno que lo use gana llamadas y pierde la posibilidad de auditarlo con strace. La documentación de io_uring recoge las operaciones y los parámetros.
13. zswap con varios almacenes y KSM que se puede medir
zswap es la capa que comprime las páginas antes de mandarlas al disco de intercambio. Hasta 6.6 tenía un único almacén de compresión, con un algoritmo y un tamaño de pool fijos; ahora admite varios zpools, cada uno con su compresor y su tamaño máximo, y las páginas se reparten entre ellos. El caso práctico es un servidor con memoria heterogénea o con cargas que comprimen mejor con un algoritmo que con otro.
La conversión a folios también avanza: zswap trabaja con folios en más rutas, lo que reduce el coste de gestionar páginas grandes y prepara el terreno para comprimir bloques mayores. Y la memoria compartida gana instrumentación: KSM expone las páginas escaneadas como métrica, y /proc/<pid>/smaps muestra las estadísticas de KSM por proceso.
Medir era el problema: KSM lleva años funcionando en segundo plano y el administrador solo veía el resultado final en KSM_pages_sharing. Con las métricas nuevas se puede saber si el escaneo está encontrando duplicados o gastando CPU para nada, y ajustar pages_to_scan con datos en la mano.
Los límites son los del diseño: zswap sigue siendo una caché y no sustituye a zram ni al disco, los pools comparten la memoria del sistema y KSM solo funciona con páginas anónimas que el kernel puede comparar. La documentación de zswap y la de KSM explican los parámetros.
14. Por subsistemas
14.1 Core y herramientas
io_uring estrena ftruncate, busy polling para NAPI y epoll y mejoras en sendmsg. Las workqueues ganan el modelo BH, que convierte tasklets en trabajos diferidos, y el árbol de mapas (maple tree) acelera fork().
14.2 Sistemas de ficheros
Btrfs copia permisos y tiempos al crear un subvolumen, depreca el comprobador de integridad y recupera el rendimiento del scrub tras la reescritura de 6.4. Overlayfs avisa de los ids de fichero con fanotify, y EROFS suma compresión DEFLATE. La documentación de Btrfs explica los subvolúmenes.
14.3 Bloque e iomap
iomap añade estado sucio por bloque para mejorar la escritura, usa la inicialización diferida en DIO asíncrono y crea folios grandes en escrituras con búfer. md/raid1 reduce la contención del wake_up, y sed-opal suma llaveros y descubrimiento.
14.4 Red
AF_XDP admite varios búferes, y el qdisc taprio mejora su relación con los hijos. El kernel gana LED de PHY por offload, alertas TLS en el kernel y atributos de ipsec en devlink.
14.5 Seguridad y virtualización
seccomp estrena el modo sincronizado de user notification, IMA exige política firmada con Secure Boot y EVM hace HMAC de varios xattrs por LSM. SELinux revierte el SID de arranque y las restricciones de llavero aceptan digitalSignature.
14.6 Arquitecturas y plataformas
ARM64 recibe los SoC TI AM62P5, Intel Agilex5, Qualcomm ipq5018 y SM4450. También entran placas como la NanoPC T6 y la Galaxy Tab 3, y avanzan RISC-V y LoongArch.
14.7 Tracing y perf
El ring buffer se puede mapear en memoria desde espacio de usuario, y tracing estrena eventfs. perf mejora el soporte de BTF en probe events, añade un bench de uprobes + BPF y puede leer perfiles de Firefox.
14.8 Drivers y gráficos
En gráficos, Panthor y Radeon en RISC-V son las claves, y amdgpu suma soporte de JPEG 5.0 y PSP 14.0. En plataformas, Intel IVSC y AMD DBC añaden hardware nuevo, y los drivers de almacenamiento y USB suman correcciones.
15. Lo que no llega
bcachefs no está en 6.6: se queda para 6.7, donde entra con su historia, como cuenta la sección anterior. El shadow stack necesita hardware CET, kernel de 64 bits y binarios preparados; sin las tres cosas no protege nada. EEVDF cambia el reparto de CPU y las cargas que ajustaban CFS notan diferencias, así que las releases siguientes siguen puliéndolo: 6.7 ajusta la latencia de las tareas interactivas, y las distribuciones tardan en decidir si lo adoptan en sus kernels LTS. Tampoco hay todavía una herramienta que traduzca los tunables de CFS a los de EEVDF, así que quien tenía sched_latency_ns ajustado a mano se queda sin equivalente directo.
XFS online fsck son las primeras piezas, no la función completa. tmpfs llega con cuotas de usuario y grupo, pero las de proyecto quedan para después. El kernel sin buffer-heads está en sus primeros pasos. El modelo BH de las workqueues no retira los tasklets por sí solo: cada driver tiene que migrarse, y mientras queden tasklets convivirán las dos APIs. Y 6.6 es LTS, pero eso no significa quedarse quieto: la rama 6.6.y recibe correcciones cada pocas semanas.
16. Cambios menores
Core
- maple tree fork — menos trabajo al crear procesos.
- listas endurecidas —
CONFIG_LIST_HARDENEDdetecta escrituras corruptas. - -Wenum-conversion — el compilador avisa de conversiones entre enumeraciones.
- CONFIG_EMBEDDED fuera — desaparece la opción que ya no significaba nada.
- bloqueo de página — menos coste para los drivers que lo piden.
Sistemas de ficheros
- Btrfs debug check — comprobación de superbloque válido.
- NFS revocación — el servidor puede revocar estado.
- NFS READ_PLUS — activado por defecto en NFSv4.2.
- KSMBD read compound — menos viajes en las lecturas SMB.
- GFS2 quota=quiet — opción de montaje para callar los avisos.
Bloque
- md/raid0 iostat — contabilidad de bio dividido.
- mq-deadline — limitación correcta de escrituras.
- ublk zoned — dispositivos de bloque por zonas en espacio de usuario.
- md bitmap opcional — el fichero de bitmap deja de ser obligatorio.
Networking
- virtio_net coalescing — coalescencia por cola.
- devlink nexthop — id de backup para nexthop.
- UDP encapsulado — encapsulado UDP en modo offload.
Seguridad
- SELinux debug — funciones de depuración en su configuración.
- PowerVM keys — carga de claves locales y de terceros.
- memfd_create configurable — se puede compilar fuera.
- KFENCE en runtime — los metadatos se reservan al arrancar.
- DES fuera — se retiran los enctypes Kerberos basados en DES.
Herramientas
- perf LTO — soporte de LTO en las herramientas.
- bpftool tcx —
link showpara los enlaces tcx. - uprobes y bpf_get_func_ip — el helper funciona en uprobes.
17. Qué viene después
La merge window de 6.7 se abre el 30 de octubre y cierra el 12 de noviembre. Ese ciclo traerá bcachefs, la retirada de Itanium, futex2 y Nouveau con GSP; Linux 6.7 sale el 7 de enero de 2024; LWN cubrió la ventana de 6.6 en su primer resumen.
Para las distribuciones, 6.6 es la release que se adopta a largo plazo: Debian 13, Ubuntu 24.04 LTS y las imágenes de servidor la usarán durante años. Las rolling la cambian en semanas, y quien quiera las funciones del año siguiente tendrá que esperar a 6.8 o 6.9.
Dentro de un año se verá si EEVDF convence a las cargas que CFS atendía bien y si bcachefs aguanta el ritmo de mainline. También se sabrá si el modelo BH de las workqueues permite retirar los tasklets de una vez, o si la transición se queda a medias como tantas otras del kernel.
18. Referencias
- KernelNewbies: Linux 6.6 — inventario completo por subsistema.
- ChangeLog-6.6 — la lista completa de commits.
- Phoronix: Linux 6.6 Released — resumen de hardware y rendimiento.
- Phoronix: Linux 6.6 features — repaso de las novedades del ciclo.