Linux 6.7: llega bcachefs, se va Itanium
Bcachefs entra en el kernel, Itanium se retira y futex2 llega: 17.284 changesets, el ciclo más grande de la historia de Linux.
Linux 6.7 se ha publicado hoy, 7 de enero de 2024, con bcachefs dentro del kernel, Itanium fuera y la primera parte de futex2. El ciclo ha durado diez semanas y deja 17.284 changesets, el récord de la historia, aunque casi 3.000 son la historia de bcachefs. También es la release en la que Nouveau usa el firmware de NVIDIA y Meteor Lake queda estable.
Torvalds avisa de que el número no refleja la carga real: «6.7 is (in number of commits: over 17k non-merge commits, with 1k+ merges) one of the largest kernel releases we’ve ever had, but the extra rc8 week was purely due to timing with the holidays, not about any difficulties with the larger release». La octava release candidate no fue por problemas, sino por el calendario. Linux 6.7 sale el domingo 7 de enero de 2024, diez semanas después de 6.6 y dentro de la serie 6.x; la merge window de 6.8 se abre al día siguiente.
El récord tiene truco: 17.284 changesets sin merges, pero casi 3.000 son los commits con los que bcachefs entró en el árbol, con toda su historia de desarrollo. Sin ellos, el ciclo sería normal. Lo firman 1.973 desarrolladores, de los que 267 son novatos, y el árbol crece 566.000 líneas. Kent Overstreet encabeza la lista con 2.771 changesets, el 16 % del total, porque bcachefs lo desarrolló él solo, con apoyo de usuarios en Patreon.
Hay tres claves. La primera es bcachefs: un sistema de ficheros con copy-on-write, checksums, snapshots, compresión y cifrado que llega marcado como experimental. La segunda es el relevo: Itanium desaparece después de veinte años y futex2 llega con sus primeras llamadas. La tercera es el hardware: Nouveau usa el firmware de NVIDIA y Meteor Lake deja de ser una promesa. Estas son las claves; el resto de cambios está al final.
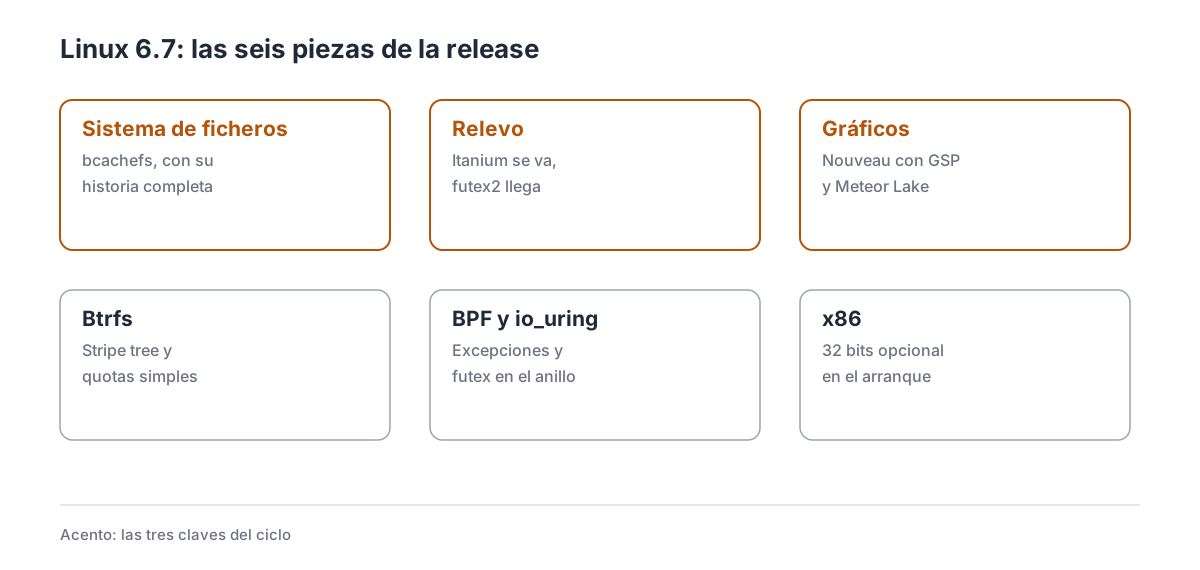
Las seis piezas de la release, con las tres claves resaltadas.
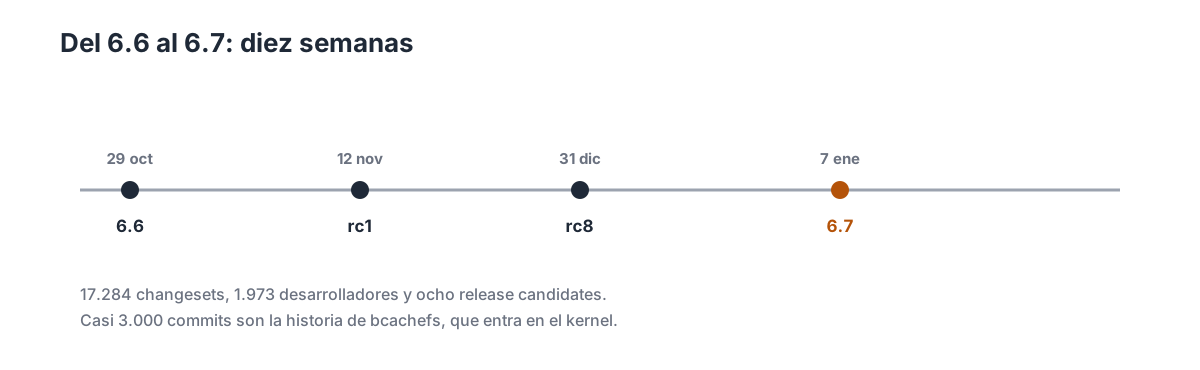
Del 6.6 al 6.7: diez semanas, ocho release candidates y una salida en enero.
1. Las cifras del ciclo más grande
| Dato | Valor |
|---|---|
| Fecha de release | 7 de enero de 2024 |
| Versión anterior | 6.6 (29 de octubre de 2023) |
| Merge window | 30 de octubre al 12 de noviembre de 2023 |
| Release candidates | 8 |
| Changesets | 17.284 |
| Desarrolladores | 1.973 |
| Novatos | 267 |
| Líneas añadidas | 566.000 |
Las 17.284 changesets son el número más alto de cualquier ciclo, pero el dato engaña: bcachefs aporta casi 3.000 y el resto del árbol se mueve en parámetros normales. Overstreet firma 2.771, Kleine-König 616 y Kees Cook 207; el resto de la lista cae en picado.
Por empresas, el primer puesto es «(None)», con 3.134 changesets (18,1 %): es el trabajo sin empresa detrás, y buena parte es bcachefs. Le siguen Intel (1.951), Google (1.120), AMD (1.099), Linaro (963) y Red Hat (940). Es la foto de un ciclo en el que un desarrollador independiente pesa más que cualquier compañía; LWN tiene el desglose completo. El resto de la tabla lo firman Linaro, que empuja ARM64, y las consultoras que mantienen drivers de plataforma. La consecuencia práctica es que el código nuevo depende menos de un puñado de empresas y más de maintainers con tiempo limitado, algo que se nota en la velocidad de revisión.
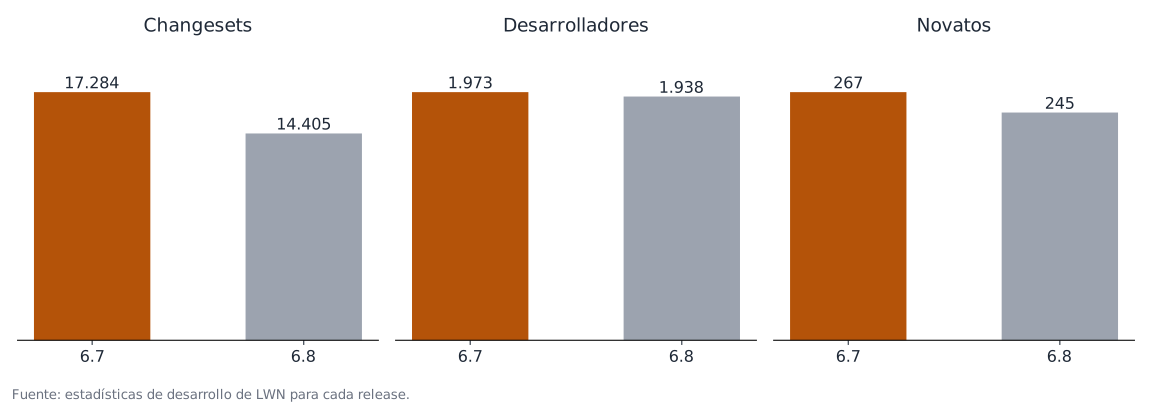
El récord de 6.7 comparado con 6.8, según las estadísticas de LWN.
2. Bcachefs entra en el kernel
Bcachefs lleva años en el limbo: un sistema de ficheros con copy-on-write, checksums en todos los datos y metadatos, compresión, cifrado, snapshots, replicación entre dispositivos y niveles de caché. Su autor, Kent Overstreet, lo mantuvo fuera del tree durante una década y lo financió con donaciones de usuarios en Patreon. En 6.7, Torvalds lo integra.
La entrada trae el código y su historia: casi 3.000 commits que explican por qué el ciclo bate el récord de changesets. El sistema se marca como experimental: no está pensado para datos críticos y su formato puede cambiar. Phoronix publicó pruebas de rendimiento en las primeras semanas, y la documentación del proyecto explica las funciones.
El límite es el de siempre en un sistema de ficheros nuevo: necesita usuarios que lo prueben, herramientas que lo entiendan y tiempo para que los fallos salgan. También necesita que las distribuciones se atrevan a ofrecerlo en el instalador, y eso no ocurre en 2024: quien quiera probarlo tiene que crear el sistema a mano con bcachefs format y montarlo desde una imagen de rescate. Linux tiene por fin un competidor de ZFS y Btrfs dentro del árbol, y usar uno u otro sigue siendo decisión de cada uno.
3. Itanium se va después de veinte años
Intel presentó Itanium como el sustituto de x86: una arquitectura RISC de 64 bits que iba a dominar los servidores. No lo hizo. El mercado se quedó con x86-64, el hardware se volvió raro y el soporte de Linux en ia64 acabó siendo mantenido por un puñado de voluntarios con máquinas de segunda mano.
6.7 retira la arquitectura durante la merge window. Desaparecen el código de arranque, las plataformas y los drivers específicos; quedan fuera también los usuarios que seguían usando Linux en esos servidores.
La retirada es definitiva: quien tenga un Itanium se queda en 6.6 o en el mantenimiento fuera del tree. El kernel deja de cargar con una arquitectura que ya nadie fabrica, y la decisión se toma por salud del árbol, no por falta de cariño.
4. futex2: los primeros syscalls
Un futex es la pieza con la que se construyen mutex y semáforos en espacio de usuario. La syscall original lleva veinte años acumulando funciones y modos, y el kernel quería separarla en varias llamadas más simples. 6.7 añade la primera parte de futex2: futex_wait, futex_wake y futex_requeue, con tiempo de 64 bits y tamaños de futex explícitos.
Todavía no sustituye a la API vieja: faltan las variantes vectoriales, la integración con io_uring y parte de la semántica antigua. Las dos convivirán durante años, y el código nuevo usará las llamadas nuevas. LWN lo explicó en A new futex API.
La limitación es que casi nadie las usará hasta que glibc y las bibliotecas de sincronización las adopten. La base para mutex más rápidos ya está en el kernel, pero el cambio se notará en las releases siguientes.
5. Btrfs: stripe tree y quotas simples
Btrfs estrena el RAID stripe tree, un árbol nuevo que separa el mapeo lógico de los datos del mapeo físico en los dispositivos. Hasta ahora, el RAID de Btrfs asumía que ambos coincidían, y eso limitaba los perfiles que se podían ofrecer en modo zoned. Con el stripe tree, el sistema puede implementar RAID0 y RAID1 sobre discos por zonas, y abre la posibilidad de arreglar RAID56.
También llegan las quotas simples, un modo de cuota que cuenta el espacio de los extents originales sin la contabilidad completa de los qgroups, y el ID temporal de sistema de ficheros, que permite montar un clon sin que choque con el original.
La limitación es que el stripe tree solo se usa en modo zoned por ahora, y que RAID56 sigue en desarrollo. Btrfs se acerca a un RAID que no exige discos del mismo tamaño ni un orden de escritura concreto.
6. BPF exceptions: salir sin romper nada
Un programa BPF no puede «lanzar una excepción» como en C++ o Java: si encuentra un caso imposible, tiene que devolver un error y deshacer la pila a mano. 6.7 añade excepciones en BPF: el programa puede llamar a bpf_throw() y el verifier genera el código para deshacer la pila y salir de forma segura.
La utilidad está en los casos que el verificador no puede demostrar: una condición que en la práctica siempre se cumple, pero que el análisis estático no ve. En lugar de llenar el programa de comprobaciones, el autor escribe la excepción y el kernel se encarga del resto. LWN lo contó en Exceptions in BPF.
La limitación es que solo funciona en programas que el verifier acepta con el nuevo modo, y que el coste de desenrollar no es gratis. Los programas BPF quedan más simples y seguros, y el código de red o de tracing ya no tiene que tratar cada caso imposible a mano.
7. io_uring: futex y lecturas multishot
io_uring sigue comiendo terreno. 6.7 añade soporte de futex: un programa puede esperar o despertar un futex a través del anillo, sin hacer la syscall, y encadenar la espera con el resto de operaciones. También llegan las lecturas multishot, que mantienen una petición viva y entregan datos según llegan, y una versión asíncrona de waitid().
La limitación es que la API crece y las bibliotecas tienen que seguirla; el código que no usa io_uring no gana nada. Los servidores con muchas operaciones pequeñas tienen otra vía para reducir syscalls, y la sincronización también puede hacerse dentro del anillo.
8. TCP-AO: autenticación para TCP
TCP-MD5 lleva años en el kernel y arrastra problemas: una sola clave, algoritmos obsoletos y poca rotación. 6.7 añade el TCP Authentication Option, definido en la RFC 5925: cada segmento lleva un MAC calculado con una clave compartida, y los dos extremos pueden tener varias claves y rotarlas sin cortar la conexión.
Es la opción que usan las sesiones BGP entre routers, y hasta ahora obligaba a TCP-MD5 o a soluciones de capa de aplicación. La documentación explica la configuración y las limitaciones.
La limitación es que hay que configurarlo en los dos extremos y que no cifra nada: autentica, no protege el contenido. Las sesiones de routing pueden dejar de usar MD5, y rotar claves deja de cortar el servicio.
9. Nouveau con GSP y Meteor Lake estable
Las GPU de NVIDIA tienen un firmware que gestiona la inicialización y el reloj. Nouveau lo evitaba y hacía ese trabajo por su cuenta, con resultados irregulares en las tarjetas nuevas. 6.7 añade el soporte de GSP: el driver carga el firmware 535.54.04 de NVIDIA y deja que él gestione la tarjeta, lo que mejora el soporte de las Ada (RTX 40) y prepara el de las generaciones siguientes.
En Intel, Meteor Lake deja de ser una promesa: el soporte gráfico se considera estable, con el driver i915 cubriendo la integrada de los portátiles nuevos. AMD suma GFX 11.5, DCN 3.5 y SMU 14.0, piezas de sus GPU de 2024.
El límite es que GSP necesita firmware propietario y que Nouveau sigue sin hacer todo lo que el driver de NVIDIA hace. Las tarjetas nuevas de NVIDIA funcionan mejor con software libre, y Meteor Lake ya arranca sin problemas.
10. x86 sin emulación de 32 bits
Un procesador x86-64 puede ejecutar binarios de 32 bits, y el kernel mantiene esa capa para que sigan funcionando. Algunas distribuciones querían poder apagarla para reducir superficie de ataque, pero necesitaban conservar la opción para el software antiguo.
6.7 permite activar o desactivar la emulación en el arranque: ia32_emulation=0 deja el kernel sin syscalls de 32 bits, y el sistema solo ejecuta binarios de 64. Es una opción de arranque, no una compilación distinta, así que el mismo kernel sirve para los dos casos.
La limitación es que un sistema con esa opción activada no arranca binarios de 32 bits, ni siquiera los que necesitan algunas herramientas propietarias. Quien quiera un servidor sin código antiguo puede desactivarla sin recompilar.
11. El salseo: el pulso por salvar Itanium
La retirada de Itanium no fue una decisión pacífica. LWN la contó en The push to save Itanium: durante la merge window, un grupo pequeño de usuarios intentó que la arquitectura siguiera en el árbol, y hubo quien se ofreció a mantenerla. La respuesta fue que el código ya no se mantiene: sin hardware nuevo, sin maintainers activos y con plataformas que nadie prueba, ia64 es una carga.
La frase que resume el episodio es la de LWN: añadir código al kernel es relativamente fácil; quitarlo después cuesta mucho más. Itanium estuvo veinte años en el árbol y su retirada dejó a un puñado de personas con la esperanza de que volviera en un año. No volvió.
El otro episodio del ciclo es más doméstico: la rc8 extra llegó por el calendario de vacaciones, porque la release caía en Navidad. Torvalds lo dice en el anuncio y el proyecto prefiere una semana más a una release con la gente de vacaciones.
12. Landlock y AppArmor cierran el sandbox
Landlock nació para que un proceso pudiera limitarse a sí mismo el acceso al sistema de ficheros sin privilegios y sin depender de un perfil del sistema. En 6.7 da el salto a la red con reglas de bind() y connect(): un programa puede declarar que solo escucha en un puerto concreto y que solo se conecta a ciertos puertos, y el kernel rechaza el resto aunque el proceso tenga permiso para abrir sockets.
La regla es gruesa a propósito: filtra por número de puerto, no por dirección IP ni por nombre de dominio, y no inspecciona el contenido. Eso deja fuera casos como “solo a este servidor”, pero cubre el escenario habitual de un servicio que no debería hablar con nada más que su base de datos y su bus de mensajes. Se combina con las restricciones de ficheros ya existentes, y el proceso tiene que activarlas explícitamente, así que no protege a un binario que no coopera.
AppArmor también suma piezas: media io_uring, que hasta ahora quedaba fuera de sus perfiles, permite restringir la creación de namespaces de usuario, una vía clásica de escalada, y limita el change_profile no privilegiado. Además, el kernel estrena fragmentos de Kconfig para endurecimiento, pensados para que una distribución active un conjunto coherente de opciones sin revisar cien menús.
La diferencia con SELinux sigue siendo la filosofía: AppArmor trabaja con rutas y Landlock con descriptores, y ninguno de los dos sustituye a seccomp para filtrar llamadas al sistema. Los límites son los de siempre: un perfil mal escrito da una falsa sensación de seguridad, y las reglas de red de Landlock no entienden de direcciones. La documentación de Landlock tiene el ABI y los ejemplos.
13. TCP afina el pingpong y cuenta los retrocesos
El modo pingpong de TCP es una optimización para conexiones interactivas: cuando un extremo detecta que la conversación es de ida y vuelta con pocos datos, reduce la agresividad del control de congestión para no inundar la red de paquetes. Hasta 6.7, el umbral que decide cuándo entrar en ese modo estaba fijado en el código; ahora se ajusta con el sysctl tcp_pingpong_thresh, así que un operador puede hacerlo más o menos conservador según su mezcla de tráfico.
Para diagnosticar, TCP_INFO gana estadísticas de los retrocesos de temporizador: cuántas veces se agotó el RTO, cuántas fueron retrocesos consecutivos y cuánto se esperó. Son los datos que faltaban para distinguir una pérdida puntual de una congestión sostenida sin capturar tráfico.
En la infraestructura, netlink admite enteros de longitud variable y automáticos, lo que simplifica las familias que crecen con el tiempo, y la salida GSO de IPv6 evita el fragmento atómico, un caso que generaba paquetes pequeños sin necesidad.
Para leer las estadísticas nuevas no hace falta instrumentación: ss -ti ya vuelca TCP_INFO, y basta con mirar los campos de retroceso para ver si una conexión está sufriendo. Ese detalle importa en soporte, donde durante años hubo que elegir entre capturar tráfico o adivinar.
Ninguna de las tres cambia lo que hace la red por defecto: el umbral sigue en su valor histórico, las estadísticas solo se leen si alguien las pide y la corrección de IPv6 elimina un caso raro. Son mejoras para quien opera redes grandes y necesita medir. La documentación de TCP recoge los sysctls.
14. Folios grandes en memfd, mlock y khugepaged
Un memfd con el sello de escritura puesto (F_SEAL_WRITE) no se podía mapear en modo compartido y de solo lectura: el kernel lo rechazaba para no tener que lidiar con páginas que cambian bajo un mapeo compartido. 6.7 permite ese mapeo, y con él llega un caso de uso interesante: compartir un fichero sellado entre procesos, o con un invitado, sin copiarlo y sin renunciar a la garantía de que nadie lo va a modificar.
En memoria, mlock() admite folios grandes. Antes, bloquear un rango obligaba a dividir las páginas gigantes en páginas de 4 KB, con el coste de memoria y de TLB que eso implica; ahora el rango se bloquea tal cual está. khugepaged recibe conversiones a folios y la fusión de áreas de memoria (vma_merge) se abstrae para admitir folios en el futuro.
El hilo común es dejar de suponer que todas las páginas miden lo mismo: casi todas las rutas de memoria del kernel se escribieron cuando la página era la unidad mínima, y cada release convierte un puñado de funciones a folios. El usuario no lo nota hasta que su programa usa memoria grande y ve menos fallos de TLB y menos tiempo en mlock().
Los límites son los de la memoria transparente: si THP está desactivado, no hay folios grandes que bloquear; si la memoria está fragmentada, el mlock puede seguir partiendo; y el mapeo de memfd sellado es de solo lectura, no de escritura compartida. La documentación de memoria transparente explica cómo se activa.
15. Por subsistemas
15.1 Core y consola
La consola estrena la base de las consolas sin BKL (nbcon), y el kernel expone los argumentos de arranque del bootloader. fanotify admite más sistemas de ficheros con FAN_REPORT_FID, y la caché de ficheros pasa a SLAB_TYPESAFE_BY_RCU. El scheduler prueba CPUs del mismo clúster antes de escanear.
15.2 Sistemas de ficheros
Btrfs estrena el RAID stripe tree y las quotas simples, y añade el ID temporal de sistema de ficheros. También mejora las fusiones de extent state y reduce las lecturas duplicadas en el scrub de paridad.
15.3 Memoria y bloque
El slab shrink pasa a ser lockless con refcount y RCU, y hugetlb agrupa las modificaciones de vmemmap. mremap se optimiza y ublk admite más de 64 dispositivos. blk-mq mejora queue_rqs().
15.4 Red
nvme-tcp incorpora TLS en el kernel, y TCP permite marcas de tiempo con microsegundos. sch_fq añade WRR y tres bandas, y act_ct cambia el recuento de etiquetas por acción.
15.5 Seguridad y BPF
BPF gana temporizadores fijados a la CPU, hooks de sockaddr para Unix y kptr por CPU local. La caché de ficheros pasa a SLAB_TYPESAFE_BY_RCU, y Xen añade ioeventfd a privcmd para los invitados.
15.6 Arquitecturas
ARM64 recibe el SoC AMD Pensando Elba, el Snapdragon 720G y el R-Car S4-8. También entra la Fairphone 5, y se retira Itanium.
15.7 Gráficos
amdgpu añade GFX 11.5, DCN 3.5 y SMU 14.0, y la GPU expone una interfaz de consulta de fallos de página.
15.8 Almacenamiento y plataformas
AHCI reconoce el controlador Alder Lake-P de bajo consumo, UFS puede leer las OPP y scsi_debug añade inyección de errores. Los drivers de plataforma suman hardware nuevo.
16. Lo que no llega
bcachefs es experimental: no está pensado para datos críticos, su formato puede cambiar y necesita herramientas propias, como explica la página del proyecto. futex2 llega a medias: solo los primeros syscalls, sin las variantes vectoriales ni la integración completa con io_uring. Itanium no vuelve: quien lo use se queda en 6.6 o en el mantenimiento fuera del tree.
Nouveau con GSP necesita firmware propietario y no cubre todo el hardware ni todas las funciones; las GPU que ya funcionaban con el driver antiguo no ganan nada por el cambio, y las que lo necesitan siguen dependiendo de una distribución que empaquete el firmware. La emulación de 32 bits se puede apagar, pero no en todas las configuraciones ni sin romper software antiguo. Las reglas de red de Landlock tampoco llegan a las distribuciones al mismo tiempo: el espacio de usuario necesita una versión reciente de la biblioteca para pedirlas, y las aplicaciones tienen que incorporarlas. Mientras tanto, el sandbox de red sigue dependiendo de seccomp y de filtros escritos a mano. Y 6.7 no es LTS: la serie con una LTS sigue siendo 6.6.
17. Cambios menores
Core
- io_uring uring_cmd — las operaciones de comando se pueden cancelar.
- waitid asíncrono — espera de hijos sin bloquear el hilo.
- binfmt_misc aislado — montajes en un namespace propio.
- splice en /dev/zero — cero y full admiten
splice(). - MDWE sin herencia — el modo no se hereda al
exec. - RCU stall notifier — aviso cuando una CPU se atasca.
Memoria
- estadísticas PUD — contadores de tablas de nivel PUD.
- hugetlb en memcg — las páginas gigantes se contabilizan.
- DAMOS intervalos — aplicación periódica de los esquemas.
- folio_end_read — finalización de lectura por folio.
Sistemas de ficheros
- fscrypt granular — cifrado con granularidad menor que el bloque.
- exFAT ioctls — acceso a los atributos del sistema de ficheros.
- F2FS 16K — páginas de 16 KiB.
- overlay lowerdir+ — opciones de montaje nuevas.
- XFS FICLONE — lectura y clonación concurrentes.
- NFS write delegation — delegación de escritura en NFSv4.1+.
Bloque
- badblocks múltiples — varios rangos de bloques defectuosos.
- dm-error zoned — el dispositivo de error admite zonas.
Virtualización y seguridad
- vfio/mtty migración — el dispositivo de pruebas se puede migrar.
- BPF kprobe stats — estadísticas de los kprobes que se pierden.
- SHA-3 en firmas — PKCS#7 y X.509 con FIPS 202.
18. Qué viene después
La merge window de 6.8 se abre el 8 de enero y cierra el 21. Ese ciclo traerá el driver Xe, el primer driver de dispositivo en Rust y listmount/statmount; Linux 6.8 sale el 10 de marzo, y LWN cubrió la ventana de 6.7 en su resumen.
Para las distribuciones, 6.7 es la release de invierno: las rolling la adoptan en semanas, y las que congelan kernel en primavera llegan a 6.8. La LTS es 6.6, así que quien busque una LTS no se mueve.
Lo que no se sabrá hasta las siguientes releases es si bcachefs resiste la prueba de los usuarios y si futex2 termina sustituyendo a la API vieja. Tampoco hay fecha para que los drivers gráficos dejen de necesitar firmware propietario, ni para que la reparación en línea de XFS cubra todos los metadatos.
19. Referencias
- KernelNewbies: Linux 6.7 — inventario completo por subsistema.
- ChangeLog-6.7 — la lista completa de commits.
- LWN: The 6.7 kernel has been released — resumen del anuncio.
- Phoronix: Linux 6.7 Released — resumen de hardware y rendimiento.
- Phoronix: Linux 6.7 features — repaso de las novedades del ciclo.