Linux 6.8: Xe y el primer driver en Rust
Intel estrena el driver Xe, el kernel recibe su primer driver de dispositivo en Rust y los montajes ganan dos syscalls: 14.405 changesets.
Linux 6.8 se ha publicado hoy, 10 de marzo de 2024, con un driver gráfico nuevo para Intel, el primer driver de dispositivo escrito en Rust y dos syscalls para listar montajes. El ciclo ha durado nueve semanas, con 1.938 desarrolladores y 14.405 changesets, y llega después de que una tormenta de invierno dejara a Torvalds sin luz ni internet. También es la release que retira SLAB y bpfilter.
Torvalds cierra el ciclo con una mezcla de alivio y prudencia: «So it took a bit longer for the commit counts to come down this release than I tend to prefer, but a lot of that seemed to be about various selftest updates (networking in particular) rather than any actual real sign of problems». Las dos últimas semanas fueron tranquilas y no hubo motivo para retrasar la release. Linux 6.8 sale el domingo 10 de marzo de 2024, nueve semanas después de 6.7 y dentro de la serie 6.x; la merge window de 6.9 se abre al día siguiente.
El ciclo es más lento en participación que el anterior: 1.938 desarrolladores, de los que 245 son novatos, con 219 empresas identificadas. Es el número de desarrolladores más bajo desde 6.5, y aun así el árbol recibe 14.405 changesets sin merges. Uwe Kleine-König vuelve a encabezar la lista con 368, casi todos refactorizaciones de drivers; Kent Overstreet queda segundo con 317, centrado en bcachefs, y Lucas De Marchi tercero con 189, trabajando en el driver Xe.
Hay tres claves. La primera es el hardware: Intel estrena Xe, un driver gráfico nuevo que aspira a sustituir a i915 en las plataformas modernas. La segunda es Rust: el kernel recibe su primer driver de dispositivo escrito en ese lenguaje, un PHY de Asix. La tercera es el sistema: listmount() y statmount() ordenan los montajes, tres syscalls nuevas hablan con las LSMs y los discos montados se pueden proteger contra escrituras. Estas son las claves; el resto de cambios está al final.
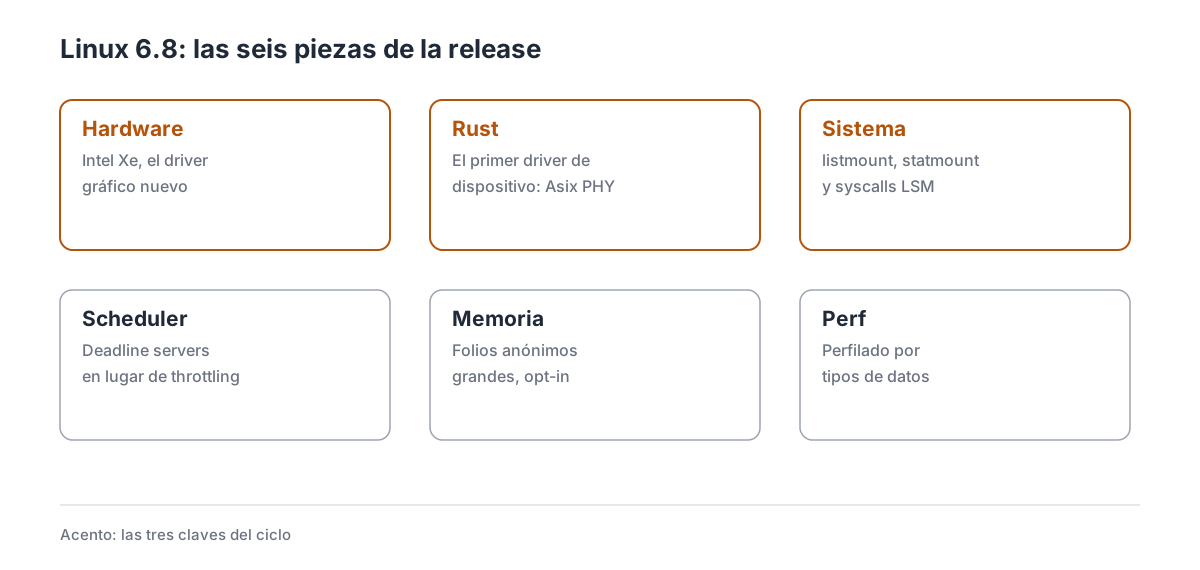
Las seis piezas de la release, con las tres claves resaltadas.
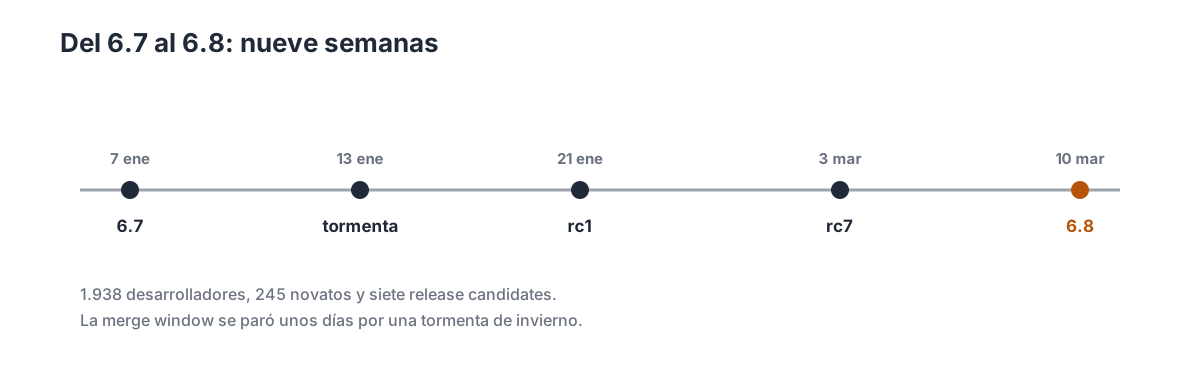
Del 6.7 al 6.8: la tormenta que paró la merge window, siete release candidates y una salida en la fecha prevista.
1. Las cifras de un ciclo más lento
| Dato | Valor |
|---|---|
| Fecha de release | 10 de marzo de 2024 |
| Versión anterior | 6.7 (7 de enero de 2024) |
| Merge window | 7 al 21 de enero de 2024 (parada por una tormenta) |
| Release candidates | 7 |
| Changesets | 14.405 |
| Desarrolladores | 1.938 |
| Novatos | 245 |
| Empresas | 219 |
El dato más llamativo es el de desarrolladores: 1.938 es el número más bajo desde 6.5. El volumen de cambios, en cambio, sube hasta 14.405 changesets, así que menos gente firmó más trabajo. Kleine-König aporta 368, Overstreet 317 y De Marchi 189, y entre los tres suman casi el 6 % del total.
Por empresas, Intel firma 2.527 changesets (17,5 %), muy por delante de Linaro (1.084), Google (878), Red Hat (871) y AMD (657). Las estadísticas de LWN tienen el desglose completo, y el ChangeLog-6.8 la lista de commits. El reparto refleja el ciclo: Xe es un driver nuevo y consume mucho trabajo de Intel, mientras Linaro empuja ARM64 y placas nuevas.
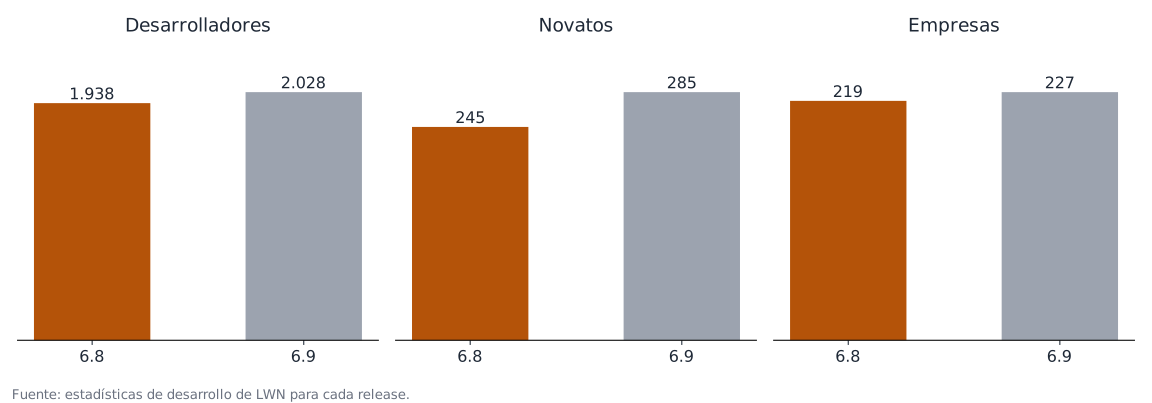
Participación de 6.8 comparada con 6.9, según las estadísticas de LWN.
2. Deadline servers: el realtime deja de ahogar al resto
Un proceso en la clase realtime tiene prioridad sobre todo lo demás. Si se queda en bucle, el resto del sistema se queda sin CPU, y el kernel lleva años defendiéndose con el RT throttling: un mecanismo que limita el tiempo de CPU que pueden consumir las tareas realtime. Funciona, pero es tosco y no siempre reparte bien.
6.8 sustituye ese mecanismo por deadline servers, una infraestructura de planificación en dos niveles: las tareas realtime siguen teniendo prioridad, pero cuando agotan su presupuesto se atienden como trabajos con plazo, y el resto del sistema recupera CPU de forma ordenada. Resuelve el mismo problema que un servidor de plazos en un sistema realtime clásico, aplicado dentro del scheduler de Linux. LWN lo explicó en Deadline servers as a realtime throttling replacement.
El límite es que no cambia la semántica para quien no usa realtime: un sistema de escritorio no nota nada. Una tarea de audio o de control industrial ya no puede congelar el resto de la máquina, y el mecanismo pasa a formar parte del scheduler.
3. Folios anónimos grandes: la memoria deja de ser 4 KB
Cuando un programa pide memoria con malloc(), el kernel le entrega páginas de 4 KB y paga un fallo de página por cada una. Los folios, la estructura que agrupa varias páginas, permiten entregar bloques más grandes de una vez, y 6.8 lo habilita para memoria anónima.
La novedad es que el tamaño se elige en tiempo de ejecución y está desactivado por defecto: quien quiera aprovecharlo tiene que activarlo. Cuando se activa, el kernel puede asignar folios de varios tamaños en un solo fallo de página, y en hardware moderno aprovecha los mapeos contiguos para reducir entradas de tabla y fallos de TLB. LWN lo contó en Large folios for anonymous memory.
La limitación es doble: hay que activarlo, y no todos los patrones de acceso ganan. Para el usuario significa que las cargas con mucha memoria anónima, como bases de datos en memoria o navegadores, pueden reducir el coste de los fallos de página, pero solo si el administrador lo enciende y la carga lo aprovecha.
4. listmount() y statmount(): montajes sin /proc
Un sistema moderno puede tener cientos de montajes: contenedores, snapshots, sistemas de ficheros apilados. Hasta ahora, listarlos y saber qué son obligaba a leer /proc/self/mountinfo, un formato de texto pensado para que lo lea una persona, y a parsearlo en cada herramienta.
6.8 añade listmount() y statmount(). La primera lista los hijos de un montaje; la segunda devuelve sus propiedades en una estructura binaria, con campos como el sistema de ficheros, las opciones o el identificador del padre. Las dos buscan ser eficientes y no depender de un formato de texto que cambia; LWN las repasó en listmount() and statmount().
La limitación es de adopción: las herramientas tienen que usarlas, y mientras tanto conviven con /proc. findmnt, mount y los gestores de contenedores pueden dejar de analizar texto, y la información de un montaje deja de ser una cadena que cada programa interpreta a su manera.
5. El primer driver de dispositivo en Rust
Rust entró en el kernel en 6.1 con módulos de ejemplo y APIs para escribir drivers. En 6.8 llega el primer driver de dispositivo de verdad: un PHY de Asix, el chip que convierte señales entre un controlador Ethernet y el cable. Es código que se compila, se carga y hace funcionar hardware.
El driver usa las abstracciones de red y de dispositivo que el equipo de Rust for Linux ha ido construyendo, y sirve de prueba de que el modelo funciona fuera de los ejemplos. En el mismo ciclo, LoongArch incorpora soporte para módulos Rust, así que el lenguaje amplía las arquitecturas donde se puede usar.
El límite sigue siendo el de siempre: Rust en el kernel es experimental, necesita una cadena de herramientas concreta y no sustituye a C. Para el usuario significa que el kernel ya tiene un driver real escrito en un lenguaje con comprobaciones de memoria, y que escribir más drivers ya no es solo teoría.
6. Intel Xe: un driver gráfico nuevo
i915 lleva veinte años acumulando parches y plataformas. Para las GPU modernas, Intel empezó de cero con Xe, un driver nuevo que cubre integradas y discretas desde Tiger Lake, la primera generación con arquitectura Xe.
El driver llega con su propia interfaz de usuario, su modelo de memoria y su forma de repartir trabajo entre la GPU y la CPU, y su documentación está en el tree. No sustituye a i915 de la noche a la mañana: convive con él, se activa con CONFIG_DRM_XE y muchas distribuciones siguen arrancando con i915 por defecto. Xe aspira a ser el driver del futuro, e i915 se queda para el hardware antiguo.
La limitación es que un driver nuevo tarda en madurar: faltan funciones, la pila de usuario (Mesa) tiene que adaptarse y el rendimiento no siempre acompaña al principio. Intel tiene por fin un driver pensado para su hardware actual, y quien compre una GPU nueva querrá un kernel que lo traiga.
7. Perf y los tipos de datos
perf sabe decir qué función consume CPU, pero no qué estructura de datos está detrás. 6.8 añade el perfilado por tipos de datos: con la información DWARF del binario, la tool asocia cada muestra de la PMU al tipo de dato que se está tocando.
Con el resultado se pueden responder preguntas que antes exigían instrumentar el programa: qué campos de una estructura se leen juntos, qué estructuras conviene reordenar para que quepan en una línea de caché, qué accesos provocan más fallos. No requiere cambiar el programa, solo compilarlo con depuración.
La limitación es la calidad de los datos: depende de la PMU, del compilador y de que el binario tenga DWARF. LWN lo detalló en Data-type profiling for perf. Optimizar estructuras deja de ser a ciegas, y pahole y perf pueden trabajar con la misma información.
8. Tres syscalls para las LSMs
Linux permite apilar varios módulos de seguridad (SELinux, AppArmor, Landlock, lockdown) desde 5.1. El problema es que las aplicaciones no tenían forma de saber qué módulos hay activos ni de consultar sus atributos sin leer /proc, un formato pensado para cuando solo podía haber uno.
6.8 añade tres syscalls: lsm_list_modules(), lsm_get_self_attr() y lsm_set_self_attr(). La primera lista los módulos activos; la segunda consulta un atributo del proceso; la tercera lo cambia, si el módulo lo permite. Están diseñadas desde el principio para varias LSMs a la vez.
El límite es que cada módulo decide qué atributos expone y cuáles deja cambiar. LWN cubrió el diseño en Adding system calls for Linux security modules. Una aplicación puede adaptarse a la configuración de seguridad del sistema sin adivinar qué hay cargado ni analizar texto.
9. No escribas en un disco montado
Escribir directamente en /dev/sda mientras el sistema de ficheros está montado es una forma segura de corromper datos. Hasta ahora, el kernel lo permitía y confiaba en que nadie lo hiciera; 6.8 añade una opción de compilación que prohíbe abrir para escritura un dispositivo de bloque que tenga un sistema de ficheros montado.
La opción no está activada por defecto en todas las configuraciones, y por eso no rompe herramientas que dependen de escribir en crudo, como las que hacen copias de seguridad por bloques. LWN lo discutió en Defending mounted filesystems from the root user. Quien la active tendrá que desmontar antes de escribir, que es lo que corresponde en cualquier caso.
El límite es que protege del error, no del ataque: un proceso con privilegios puede desmontar y escribir. Para el usuario significa que el dedo torpe deja de ser una causa de pérdida de datos, y que el kernel empieza a tratar los discos montados como territorio del sistema de ficheros.
10. El salseo: la tormenta que paró la merge window
El 13 de enero de 2024, a mitad de la merge window, Torvalds manda a LKML un mensaje titulado «Heads up - effectively offline for now»: una tormenta de invierno le ha dejado sin corriente y sin internet en las afueras de Portland. La merge window de 6.8 se detiene con pull requests pendientes y sin fecha clara de vuelta.
La cobertura de Phoronix recoge el aviso y recuerda que no es la primera vez: en 2021, otra tormenta retrasó la merge window de 5.12. Torvalds vuelve a estar en línea unos días después, el trabajo acumulado se integra y la rc1 sale el 21 de enero, en la fecha prevista.
No hubo cambios en el contenido por la tormenta, pero el episodio enseña cómo funciona el proyecto: el calendario del kernel depende de que a una persona no se le vaya la luz. No hay comité que firme las releases ni plan B para la merge window: hay un maintainer con un portátil y una conexión.
11. XFS repara en caliente, y bcachefs también
XFS lleva años con un comprobador que se ejecuta sin montar el sistema de ficheros: xfs_repair recorre los metadatos, encuentra incoherencias y las arregla, pero para ello hay que desmontar y quedarse sin servicio. 6.8 empieza a cambiar eso con la reparación en línea de los árboles de asignación. El mecanismo se apoya en xfs_scrub, que ya detectaba problemas en caliente; lo nuevo es que, cuando encuentra uno, puede reconstruir la estructura a partir de las demás copias de metadatos.
La pieza que lo hace posible es el espacio reservado para reparaciones: el sistema de ficheros guarda un margen que no usa para datos y que la reparación consume sin quedarse sin bloques a mitad. Sobre esa base llegan la carga masiva de metadatos, la reparación del bitmap de tiempo real, la de los mapeos de bifurcación de fichero y la de los ficheros de cuota y de tiempo real.
En paralelo, bcachefs estrena su propio fsck en caliente con BCH_IOCTL_FSCK_ONLINE, añade la variante offline y permite que el comprobador corrija los errores en lugar de solo señalarlos. También expone el uso por dispositivo y estadísticas de compresión por sysfs.
La diferencia práctica es el tiempo de parada: un sistema de ficheros grande puede tardar horas en comprobarse en frío, y con la reparación en línea el trabajo se reparte mientras el sistema sigue montado. La contrapartida es que ni XFS ni bcachefs lo cubren todo todavía: los casos graves siguen necesitando la herramienta offline, y en bcachefs el formato aún puede cambiar porque el sistema de ficheros es experimental. La documentación de XFS y la página de bcachefs describen el estado de cada herramienta.
12. eBPF: firmas, fsverity y contadores de ramas
La verificación de ficheros con LSM y fsverity es la novedad más interesante del ciclo para quien despliega binarios. Un programa BPF de tipo LSM puede consultar si un ejecutable tiene una firma fs-verity válida antes de dejar que se ejecute, sin necesidad de un módulo propio ni de un gancho en el cargador de binarios. La comprobación ocurre en el mmap o en el exec, según la política, y el resultado se puede combinar con el resto de reglas del LSM.
En instrumentación, uprobe multi gana información de enlace para saber qué sonda disparó, y perf suma contadores en la pila de ramas, una extensión del registro de últimas ramas que dice cuántas veces se tomó cada una. En libbpf, el respaldo de __arg_ctx evita que los programas escritos contra una versión antigua de la API dejen de compilar, y el cargador acepta programas sin ese atributo en más tipos de enganche.
La letra pequeña está en el hardware y en la configuración: la verificación con fsverity exige que el fichero tenga el árbol de hashes y la firma ya construidos, y los contadores de ramas dependen de la PMU de cada CPU. La documentación de libbpf recoge las APIs que sí llegan.
13. guest_memfd: memoria privada para las máquinas virtuales
Hasta 6.8, la memoria de un invitado KVM era memoria del host: QEMU la reservaba con mmap() y se la pasaba al hipervisor, que la mapeaba en el espacio del invitado. Ese diseño funciona, pero tiene un problema de fondo para la virtualización privada: si el host puede leer y escribir esa memoria, no hay forma de demostrar que el invitado está aislado de él.
guest_memfd() cambia el modelo. El hipervisor crea un fichero anónimo especial y le pide páginas por rango, en lugar de recibir un mapeo de userspace. La memoria no está mapeada en el host, y KVM puede marcarla como privada o compartida según lo que pida el invitado. La gestión de los rangos y el soporte inicial en x86 completan la primera versión.
El cambio también ordena el código: desaparecen las rutas que mapeaban memoria del host en el invitado y el hipervisor gana una API explícita para convertir páginas entre los dos estados, privada y compartida. La conversión se hace por rangos y requiere que el invitado esté de acuerdo, porque una página compartida deja de estar cifrada y el host puede leerla.
Es la pieza que faltaba para TDX y SEV-SNP en el host: las dos tecnologías cifran la memoria del invitado con claves que el hipervisor no tiene, pero necesitan que el kernel sepa qué páginas son privadas antes de poder activarlo. Con guest_memfd, esa contabilidad existe.
Los límites son de madurez: solo funciona en x86_64, necesita un QEMU que lo use, no admite todavía migración en caliente ni todas las combinaciones de hugepages, y el rendimiento con memoria privada es peor que con memoria normal porque cada acceso del host puede provocar una salida. La documentación de KVM y las notas de TDX explican el modelo.
14. Por subsistemas
14.1 Core e io_uring
El árbol de mapas acelera fork() en procesos con muchos mapeos, optmem_max sube a 128 KB y se puede ajustar por namespace, y KFENCE entra en la configuración de endurecimiento para detectar fallos de memoria en producción sin el coste de KASAN. io_uring añade IORING_OP_FIXED_FD_INSTALL y la consulta de la cabeza del anillo de búferes.
14.2 Sistemas de ficheros
Btrfs se pasa a la nueva API de montaje, EROFS admite datos comprimidos por debajo del tamaño de página, y cachefiles estrena un mecanismo de failover para demonios que dejan de responder. zonefs mejora el tratamiento de errores, y NFS permite revocar el estado de un cliente v4 desde el servidor.
14.3 Networking
El RSS gana XOR simétrico para que el reparto no dependa del orden de los campos, el bridge permite borrar entradas MDB en bloque, y AF_XDP estrena metadatos de transmisión. También llegan la contabilidad de RX en tun, un motivo de descarte genérico para paquetes y el seguimiento de puertos por bloque TC. El filtro bpfilter desaparece y la acción ipt se retira.
14.4 Memoria
El KSM advisor ajusta solo el escaneo de páginas duplicadas, DAMON puede autoajustarse según el uso, y userfaultfd añade el modo move para mover páginas entre regiones. Las estadísticas de memcg se agrupan por subárbol, zswap hace su reducción consciente del cgroup y el split de THP agrupa los TLB flush. Se retira SLAB y quedan SLUB y SLOB.
14.5 Seguridad y virtualización
KVM habilita LAM y LASS en x86, y vfio gana un driver sobre virtio y otro para la GPU Grace Hopper. EVM se desactiva en overlayfs, SELinux introduce un SID para los procesos de arranque temprano, y virtio admite suspensión sin reset.
14.6 Arquitecturas
ARM64 recibe el SoC Qualcomm X1E80100 y varias placas nuevas, ejecuta NEON en modo kernel con preemption y prueba el manejo de fallos con el candado por VMA antes de tomar el mmap_lock. Se retira el soporte de ARM11MPCore, una plataforma de 2008.
14.7 Drivers y plataformas
Entra el driver de Imagination PowerVR, la integridad de bloque puede mapear direcciones de usuario directamente, y desaparecen las configuraciones obsoletas de md. También llega el Nitro Secure Module de AWS, el IVSC de Intel y se borra el driver de mailbox de Apple.
15. Lo que no llega
Los BPF tokens no están en 6.8. Entraron en el ciclo y se revirtieron antes de la release por preocupaciones de seguridad; vuelven en Linux 6.9. Quien los esperaba tendrá que esperar a 6.9.
Xe es un driver nuevo: convive con i915, necesita CONFIG_DRM_XE y no cubre todo lo que cubre el driver viejo. mTHP anónimo está desactivado por defecto, así que sin activarlo no hay mejora. Rust sigue siendo experimental y depende de la cadena de herramientas. SLAB desaparece, y con él cualquier código out-of-tree que lo use. La protección de discos montados es una opción de compilación, no el comportamiento por defecto, y quien la active se encontrará con utilidades que escriben en la tabla de particiones mientras el sistema está en marcha. La reparación en línea de XFS tampoco es completa: cubre los árboles de asignación y parte de los metadatos, no todo el sistema de ficheros.
Y 6.8 no es LTS: la serie con una LTS sigue siendo 6.6, y las distribuciones que fijan el kernel en primavera se quedan en 6.8 hasta la siguiente ventana.
16. Cambios menores
Core
- lskcipher — nueva API de cifrado por bloques para el kernel.
- DRBG sin SHA-1 — el generador aleatorio deja el algoritmo viejo.
- instancias de tracing — se crean con los eventos de un sistema.
Bloque
- discard por sector — la granularidad por defecto baja al tamaño de sector.
- md/raid1 read error — comprobación de errores de lectura.
- md multipath fuera — se retira la configuración obsoleta.
- zram tracking — memoria y tiempo de acceso se cuentan por separado.
Seguridad
- AppArmor SHA-256 — el hash de los perfiles deja SHA-1.
- audit ACK — el ACK de netlink se envía antes de fijar la conexión.
Herramientas
- perf archive –all — empaqueta el
perf.datacon sus DSO. - perf archive –unpack — y los expande en otra máquina.
Virtualización y red
- vfio/pds multi-región — varias regiones de migración.
- virtio_pmem SHMEM — región de memoria compartida.
- inet_diag bound-only — los sockets solo ligados aparecen en el volcado.
- MPTCP puertos — más
sockoptspara el puerto efímero. - ctnetlink zona — filtrado de conexiones por zona.
17. Qué viene después
La merge window de 6.9 se abre el 11 de marzo y cierra el 24. Ese ciclo traerá sched_ext otra vez a la puerta, el NTFS clásico fuera y DM VDO; Linux 6.9 sale el 12 de mayo, y LWN cubrió la ventana de 6.8 en su primer resumen; el inventario de KernelNewbies tiene la lista de lo que llega.
Para las distribuciones, 6.8 es la release de primavera. Ubuntu 24.04 y Fedora 40 llegan con ella, así que será el kernel por defecto de la mayoría de equipos nuevos hasta el otoño. La LTS sigue siendo 6.6 hasta final de año.
Lo que no se sabrá hasta las siguientes releases es si Xe rinde como i915 en las GPU que ya existen y si el primer driver en Rust anima a escribir más. Tampoco se sabrá de inmediato si la reparación en línea de XFS evita las ventanas de mantenimiento en producción, porque la cobertura crece release a release y las herramientas de usuario tienen que adaptarse. Y la virtualización privada depende de que QEMU, las distribuciones y el firmware de cada servidor adopten guest_memfd al mismo ritmo.
18. Referencias
- KernelNewbies: Linux 6.8 — inventario completo por subsistema.
- LWN: The 6.8 kernel has been released — resumen del anuncio.
- Phoronix: Linux 6.8 Released — resumen de hardware y rendimiento.
- Phoronix: Linux 6.8 features — repaso de las novedades del ciclo.