Linux 6.9: deduplicación y NTFS fuera
El bloque aprende a deduplicar con DM VDO, FRED cambia las interrupciones de x86 y el NTFS viejo desaparece: 2.028 desarrolladores en nueve semanas.
Linux 6.9 se ha publicado hoy, 12 de mayo de 2024, con deduplicación y compresión dentro del bloque, un camino nuevo para las interrupciones de x86 y un sistema de ficheros propio para los pidfd. El ciclo ha durado nueve semanas, con 2.028 desarrolladores y 227 empresas, y se despide del NTFS clásico. También es la release en la que Rust llega a ARM64 y en la que sched_ext se queda fuera otra vez.
Torvalds cierra el ciclo sin dramas: «So 6.9 is now out, and last week has looked quite stable (and the whole release has felt pretty normal)». Quedaban un par de correcciones de regresiones sin llegar, pero ninguna le pareció motivo para retrasar la release una semana más. Linux 6.9 sale el domingo 12 de mayo de 2024, nueve semanas después de 6.8 y dentro de la serie 6.x; la merge window de 6.10 se abre al día siguiente.
En participación, el ciclo es de los grandes: 2.028 desarrolladores, de los que 285 son novatos, y 227 empresas identificadas, el número más alto desde 6.4. Uwe Kleine-König encabeza la lista por changesets con 344, casi todos refactorizaciones de drivers; Kent Overstreet queda segundo con 259, centrado en bcachefs, y Christoph Hellwig tercero con 206. Intel firma el 12,9 % de los cambios, por delante de Google y Linaro.
Hay tres claves. La primera es el almacenamiento: DM VDO lleva la deduplicación y la compresión al bloque, y FUSE deja de dar dos viajes para cada lectura. La segunda es la CPU: FRED sustituye la tabla de interrupciones de x86, y AMD P-State empieza a preferir los núcleos que más suben. La tercera es la compatibilidad: pidfs ordena los pidfd, Rust llega a ARM64 y el driver NTFS viejo desaparece. Estas son las claves; el resto de cambios está al final.
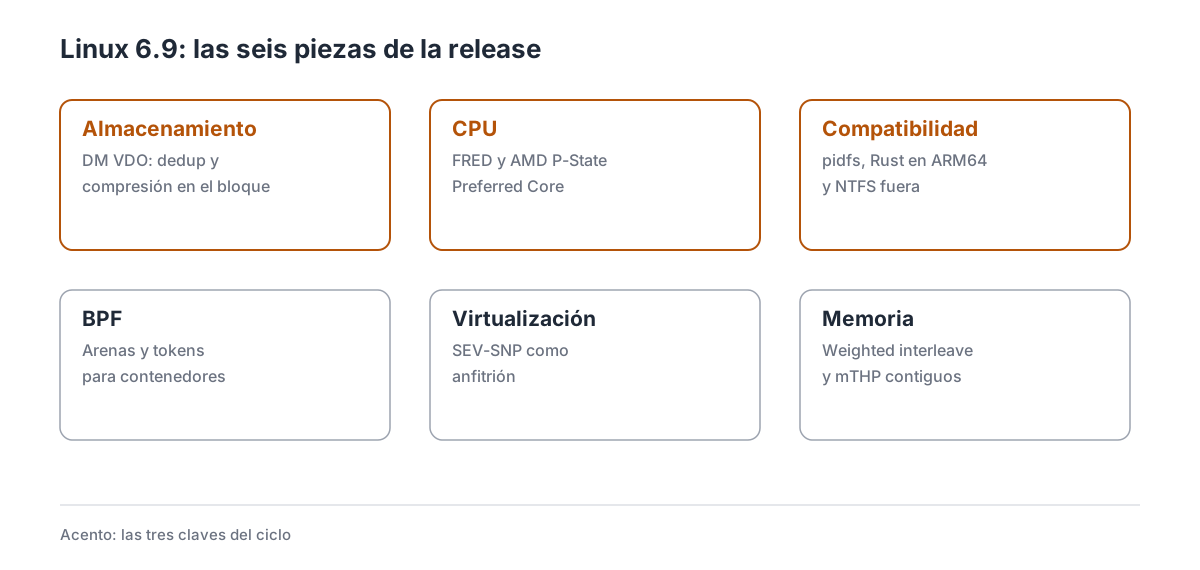
Las seis piezas de la release, con las tres claves resaltadas.
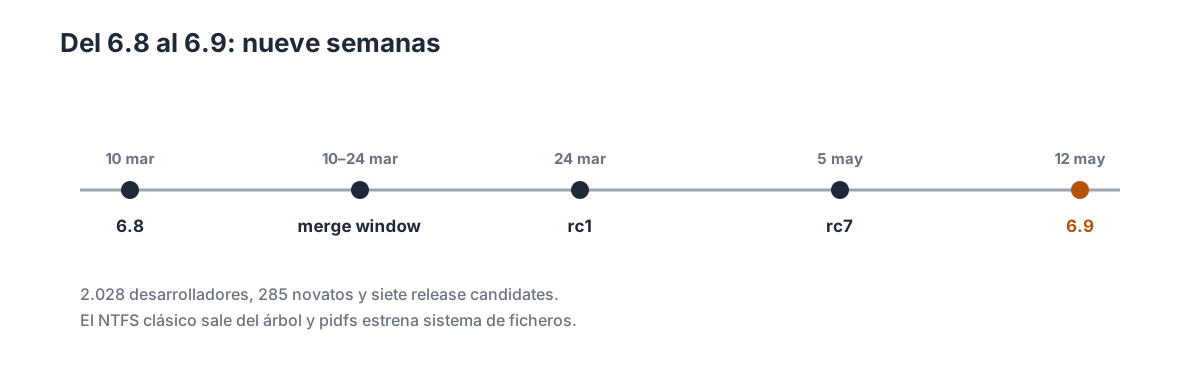
Del 6.8 al 6.9: la merge window, siete release candidates y una salida sin sustos.
1. Las cifras de un ciclo grande
| Dato | Valor |
|---|---|
| Fecha de release | 12 de mayo de 2024 |
| Versión anterior | 6.8 (10 de marzo de 2024) |
| Merge window | 10 al 24 de marzo de 2024 |
| Release candidates | 7 |
| Desarrolladores | 2.028 |
| Novatos | 285 |
| Empresas | 227 |
| Commits en el ChangeLog | 15.678 (1.237 merges) |
El ChangeLog cuenta 15.678 commits y 1.237 merges, así que el ciclo deja unos 14.400 changesets sin merges, más que los 13.312 de 6.10. LWN cubrió la ventana en dos partes. La cifra no está en el artículo de LWN, que se centra en quién hizo el trabajo; sale de restar los merges al ChangeLog, y por eso el post la da con el método a la vista.
El reparto por empresas también cambia: Intel aporta 1.867 changesets, Google 1.031, Linaro 924, AMD 820 y Red Hat 807. Linaro aparece cuarta, y AMD sexta, en un ciclo en el que las dos preparan hardware que aún no ha salido.
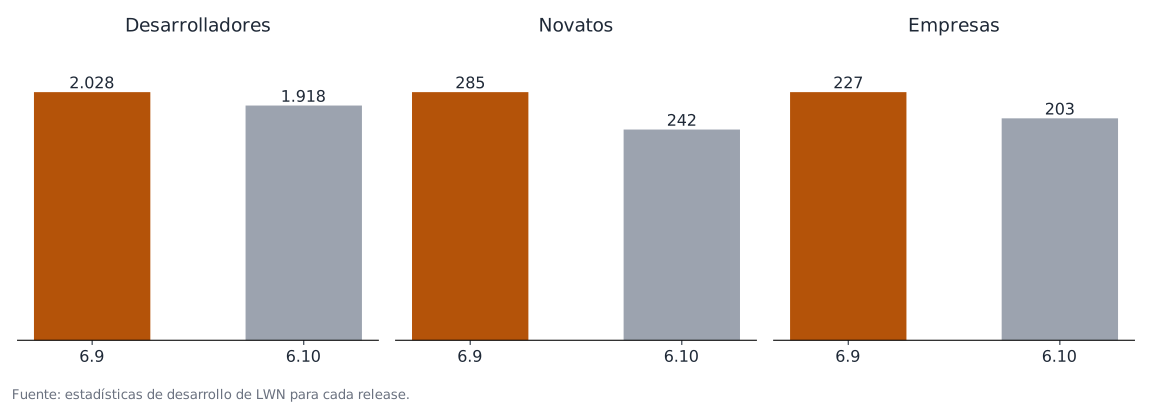
Participación de 6.9 comparada con 6.10, según las estadísticas de LWN.
2. pidfs: un fichero para cada proceso y cada hilo
Un pidfd es un descriptor de fichero que representa un proceso. Desde 5.3 sirve para enviar señales o esperar a que un proceso muera sin jugar con números de PID que se reciclan. En 6.9 da dos pasos más: se pueden crear pidfd para hilos, no solo para el líder del grupo, y todos pasan a un sistema de ficheros pequeño, pidfs, en lugar de vivir en inodos anónimos.
El pidfd de hilo llega con PIDFD_THREAD y con clone3() aceptando CLONE_PIDFD | CLONE_THREAD. El pidfs es un sistema de ficheros virtual mínimo que da a cada pidfd un inodo con número real, permite statx() y los hace comparables y montables. LWN lo explicó en A new filesystem for pidfds.
La transición parecía invisible y no lo fue. En marzo, un malentendido con SELinux impedía arrancar a los sistemas con pidfs; se corrigió en días. En mayo llegó la segunda sorpresa: lsof y otras herramientas leían el campo de tipo de inodo y se encontraban un cero, un comportamiento que el kernel arrastraba desde hacía años y del que el espacio de usuario dependía. LWN lo contó en One more pidfdfs surprise. Cualquier detalle visible acaba siendo ABI, aunque nadie lo haya documentado.
3. FRED: la CPU deja la tabla de interrupciones
Desde el 386, x86 entrega las interrupciones y las excepciones a través de la IDT, una tabla de descriptores que el kernel configura al arrancar. Funciona, pero cada transición de privilegio obliga a guardar estado, cambiar de pila y pasar por una ruta que arrastra cuarenta años de compatibilidad.
FRED (Fast Return and Event Delivery) es la alternativa de Intel: un conjunto de instrucciones que cambian de anillo con menos pasos y sin la IDT de por medio. El kernel habilita FRED cuando el hardware lo anuncia, con su documentación en el árbol, y lo usa para interrupciones, excepciones y llamadas al sistema. Menos instrucciones por evento significa menos latencia y menos superficie para errores.
El límite es el hardware: cuando sale 6.9 no hay ninguna CPU en el mercado que lo implemente. FRED llega con las generaciones futuras de Intel, así que el código queda preparado pero sin uso. El kernel ya tiene el código para la próxima plataforma; para el resto, nada cambia todavía.
4. DM VDO: deduplicar en el bloque
La deduplicación busca bloques idénticos y guarda una sola copia. Si veinte máquinas virtuales tienen el mismo fichero de sistema, el disco guarda una versión y veinte punteros. Hasta ahora, en Linux, eso se hacía en el sistema de ficheros o con productos externos; 6.9 lo lleva al bloque con DM VDO, un target de device mapper que añade deduplicación, compresión y aprovisionamiento ligero.
La ventaja de estar en el bloque es que funciona con cualquier sistema de ficheros y con cualquier pila: ext4, XFS, Btrfs o un volumen lógico encima. La documentación avisa de lo que no hace: VDO no protege contra corrupción de datos y confía en la integridad de lo que hay debajo. Tampoco es gratis: la deduplicación consume CPU y memoria, y solo compensa cuando los datos se repiten.
El límite práctico es que necesita herramientas propias para formatear el volumen y que donde más rinde es en escritorios virtuales y copias de seguridad, no en una carpeta de fotos. Un servidor puede guardar varias máquinas virtuales en el espacio de una, si acepta el coste.
5. AMD P-State Preferred Core: los núcleos buenos primero
Un Ryzen no tiene todos los núcleos iguales. Algunos alcanzan más frecuencia con el mismo voltaje, y el firmware sabe cuáles. La especificación CPPC los llama preferred cores; Windows los usa desde hace años, y Linux dependía del firmware para aprovecharlos.
6.9 añade el soporte en amd-pstate, documentado en la guía de P-State: el driver lee la lista de núcleos preferidos y la tiene en cuenta al repartir carga y al pedir frecuencias. En un portátil con TDP limitado, eso significa que el trabajo que importa cae en el núcleo que puede subir a 5 GHz en lugar de uno que se queda en 4,2.
El límite es el firmware: hace falta CPPC habilitado y una tabla de prioridades que la BIOS exponga bien. En equipos antiguos o con firmware descuidado, el driver no encuentra nada que preferir. Para el usuario significa que el rendimiento de un solo hilo deja de depender de qué núcleo le toque al scheduler.
6. BPF: arenas y tokens
Dos cambios de BPF apuntan a problemas distintos. Las arenas son una región de memoria compartida entre el programa BPF y el espacio de usuario, dispersa y mapeable desde los dos lados. Hasta ahora, pasar estructuras grandes entre un programa y su demonio obligaba a copiar o a usar mapas con formatos incómodos; con un arena, ambos ven el mismo trozo de memoria. LWN lo contó en A proposal for shared memory in BPF programs.
Los tokens resuelven un problema de permisos. Cargar BPF exige CAP_BPF, que no se puede dar a un contenedor sin abrir la puerta a todo el subsistema. Un token es una capacidad acotada que un demonio privilegiado, como systemd o el gestor de contenedores, delega a una aplicación concreta a través de un montaje de BPF FS. Así un contenedor puede cargar sus programas sin recibir el privilegio entero.
Para el usuario significa que las herramientas que corren en contenedores pueden usar BPF sin correr como root. El límite: los tokens hay que diseñarlos con cuidado, porque una delegación mal hecha equivale a una escalada de privilegios.
7. SEV-SNP en el host: EPYC como anfitrión confiable
SEV-SNP añade a las máquinas virtuales cifradas de AMD una tabla de mapa inverso que impide que el hipervisor lea o altere la memoria del invitado. Linux ya sabía ser invitado SNP desde hace varias releases; lo que faltaba era poder ser anfitrión.
6.9 añade el soporte de KVM como host SNP en EPYC Zen 3 y posteriores, sobre el cifrado de memoria de AMD. El kernel gestiona la tabla RMP, asigna páginas privadas a cada invitado y rechaza los accesos del hipervisor a memoria que no le toca. Es la pieza que permite ofrecer máquinas virtuales privadas en un servidor propio.
El límite es el hardware y el firmware: hace falta una CPU con SNP, un firmware que lo active y una IOMMU que sepa acompañarlo. Un proveedor puede garantizar que ni él mismo ve la memoria del cliente, y esa promesa ya no depende de un módulo externo.
8. FUSE y timers: menos viajes al espacio de usuario
FUSE permite implementar un sistema de ficheros en un programa normal. El precio es que cada lectura y cada escritura hacen dos viajes: del kernel al programa y del programa al kernel. 6.9 añade el modo passthrough: para ficheros regulares, el kernel lee y escribe directamente sobre el fichero de respaldo, sin pasar por el servidor FUSE. De momento solo lo pueden usar servidores privilegiados, pero el ahorro es grande para virtiofs y para los contenedores que montan capas de imagen. LWN lo explicó en FUSE passthrough for file I/O.
El otro cambio es más discreto. Un temporizador que se encola y se cancela antes de expirar no necesita una CPU asignada, pero el kernel elegía una al encolarlo. 6.9 cambia el modelo: la CPU se elige al expirar, no al encolar, y las rutas que crean y destruyen timers dejan de pagar ese trabajo. LWN lo contó en Better CPU selection for timer expiration.
Ninguno de los dos se anuncia en la portada de una distribución. Los dos destacan en cargas concretas: más rendimiento en sistemas de ficheros de usuario y menos CPU gastada en timers que nunca llegan a dispararse.
9. El NTFS viejo se jubila
Durante veinte años, el kernel tuvo dos drivers para NTFS: el antiguo, en modo lectura y con escritura experimental, y ntfs3, que llegó en 5.15 con soporte de escritura completo. Mantener los dos no tenía sentido, y 6.9 retira el clásico, como adelantó Phoronix.
La consecuencia es visible: mount -t ntfs deja de funcionar. Quien tenga un disco con ese tipo en /etc/fstab tendrá que cambiarlo a ntfs3 o instalar ntfs-3g, el driver en espacio de usuario. ntfs3 es más rápido y escribe de verdad, pero no cubre todas las funciones de NTFS y su mantenimiento ha tenido altibajos.
Para el usuario significa que el kernel deja de arrastrar código que ya nadie mantiene, y que una partición de Windows se monta con ntfs3 o con FUSE. El límite: quien dependa del driver viejo por una función concreta se queda en 6.8.
10. Gráficos y arquitecturas: RDNA4 asoma y Rust llega a ARM64
En gráficos, el ciclo es de preparación. AMD añade a amdgpu el soporte de JPEG 5.0, PSP 14.0, ATHUB 4.1 y HDP 7.0, piezas que apuntan a RDNA4 sin anunciarlo. Intel suma el transporte temprano de Panel Replay y PSR, la asignación de ancho de banda para túneles DisplayPort y los identificadores de más paneles. En ARM, msm añade la GPU A750 del Snapdragon 8 Gen 3 y la pantalla del X1E80100.
En arquitecturas, la noticia es Rust en AArch64: los módulos en Rust dejan de ser cosa de x86-64 y RISC-V (que llega en 6.10) y se pueden compilar en ARM64. También entran el soporte de AIA en RISC-V, objtool, ORC y livepatching en LoongArch, y Power11 en PowerPC.
El hardware de finales de 2024 ya asoma en el árbol, y Rust gana terreno. El límite: RDNA4 no existe todavía, y Rust en ARM64 necesita una cadena de herramientas que muchas distribuciones aún no empaquetan.
11. El salseo: sched_ext llama a la puerta
El 9 de mayo, tres días antes de la release, Tejun Heo envió una nueva versión de sched_ext, el framework que permite escribir schedulers como programas BPF y cargarlos en caliente. LWN lo contó en Another push for sched_ext: la serie llevaba más de un año de discusión y seguía lejos de entrar.
La oposición no era técnica. Peter Zijlstra, maintainer del scheduler, rechazó los parches de plano: «no tengo ninguna duda de que si esto entra, habrá software empresarial que exija su propio scheduler en BPF o no funcione», y avisó de que no aceptaría ninguna parte de la serie. Mel Gorman se sumó: un scheduler enchufable desincentiva mejorar el que ya existe, porque siempre queda la salida fácil de escribir otro.
Heo respondió con adopción: Valve quiere usarlo en la Steam Deck, Ubuntu lo estudia para 24.10, Meta y Google lo tienen en producción, y los problemas de planificación a escala no se arreglan con retoques al CFS.
6.9 salió sin sched_ext. En junio, Torvalds decidió saltarse a los maintainers y aceptarlo para 6.11, y el código llegó en Linux 6.12. La release se cerró con el debate abierto y el desenlace puesto en el ciclo siguiente.
12. Weighted interleave: la memoria se reparte por pesos
En un servidor con varios nodos NUMA, la política MPOL_INTERLEAVE reparte las páginas a partes iguales: una página para el nodo 0, otra para el 1, otra para el 2. Funciona cuando todos los nodos son iguales, y falla cuando no lo son. Un EPYC con memoria DDR5 en un nodo y CXL en otro tiene anchos de banda muy distintos, y repartir al 50 % hace que la mitad de los accesos vayan por el camino lento.
Weighted interleave añade pesos por nodo. El administrador escribe el peso en /sys/kernel/mm/mempolicy/weighted_interleave/, y el kernel reparte las páginas en proporción a ese valor: si el nodo de DDR5 pesa 3 y el de CXL pesa 1, tres de cada cuatro páginas van al rápido. La política se pide con MPOL_WEIGHTED_INTERLEAVE al crear el mapeo o al llamar a set_mempolicy().
El caso de uso es la memoria por niveles: no hace falta que el kernel decida qué página es caliente, porque el programa ya sabe qué región quiere rápida y cuál puede estar en memoria lenta. Es el complemento manual del tiering automático que hace DAMON, y encaja en bases de datos y máquinas virtuales donde el reparto se conoce de antemano.
La implementación no inventa un formato nuevo: reutiliza la infraestructura de mempolicy y añade un campo de peso por nodo que se consulta en cada migración de página. El reparto es determinista, así que dos ejecuciones con los mismos pesos colocan las páginas igual, algo que importa cuando se comparan rendimientos.
En la práctica, el flujo es sencillo: se crea el mapeo con mbind() o se cambia la política del proceso con set_mempolicy(), se escriben los pesos antes de que el programa empiece a tocar memoria, y se comprueba el reparto con numastat o leyendo /proc/<pid>/numa_maps. Si el resultado no es el esperado, el propio numa_maps dice qué nodo recibió cada página.
Los pesos no se ajustan solos: si el hardware cambia o el patrón de acceso se mueve, hay que reescribirlos. La política tampoco sustituye al first touch de los nodos locales, y en un equipo con un solo nodo no aporta nada. LWN explicó el diseño en Weighted interleaving for memory tiering, y la documentación de políticas NUMA describe los ficheros de sysfs.
13. Por subsistemas
13.1 Core e io_uring
io_uring añade ftruncate como operación del anillo y expone las estadísticas de uso de SQPOLL, y la copia de sendmsg/recvmsg se hace con menos comprobaciones. El montículo mínimo del kernel estrena optimizaciones que afectan a los temporizadores y al scheduler. Los dispositivos de bloque se pueden abrir como ficheros con una API unificada.
13.2 Sistemas de ficheros
bcachefs añade la opción no_splitbrain_check, F2FS permite fijar ficheros en dispositivos por zonas, y virtiofs emite uevents al montar y desmontar. hugetlbfs admite montajes con idmap, QNX4 se pasa a la API de montaje nueva, y todos los sistemas de ficheros pueden exponer su ruta en sysfs con FS_IOC_GETFSSYSFSPATH. Las estadísticas de NFS se ven desde el namespace de red.
13.3 Memoria
El folio batch crece para reducir el coste de las operaciones por lotes, y debugfs permite dividir páginas gigantes a cualquier orden para medir el efecto. La compactación admite folios de orden mayor que cero, khugepaged evita escaneos inútiles cuando el proceso tiene THP desactivado, y zswap escala mejor su árbol rojo-negro y sus reservas dinámicas. userfaultfd maneja los movimientos de página cero con UFFDIO_MOVE.
13.4 Bloque
El bloque cachea la consulta del tiempo de emisión de cada petición, maneja los sistemas heterogéneos al completar E/S y mejora el borrado de dispositivos ublk. Device mapper deja de perder la prioridad de E/S al pasar por sus capas.
13.5 Tracing y perf
BPF estrena may_goto y cond_break para escribir bucles con una condición de salida, y el búfer de traza se puede mapear en espacio de usuario sin copiar. perf stat suma por clúster, la opción -H acorta --hierarchy, y ftrace_dump_on_oops puede volcar solo una instancia.
13.6 Networking
La pila abstrae la página del paquete para dejar de depender de struct page, el bonding estrena una máquina de estados independiente y llega un módulo de encapsulado UDP L3. El consumo de memoria por socket se puede ajustar por CPU, y IP_ROUTER_ALERT se puede consultar con getsockopt.
13.7 Virtualización, seguridad y arquitecturas
Xen intenta inflar el globo de memoria en PVH, Hyper-V siembra el generador aleatorio del invitado con su entropía, y la integridad deja de ser un LSM aparte. En ARM64 entran placas como la PineTab2, el NanoPi R6S y la QNAP TS-433.
14. Lo que no llega
sched_ext vuelve a quedarse fuera, como cuenta la sección anterior: quien quiera probarlo tendrá que esperar a Linux 6.12.
El NTFS clásico desaparece sin sustituto completo: ntfs3 no cubre todas las funciones y quien dependa de ellas se queda en 6.8 o pasa a ntfs-3g. DM VDO necesita herramientas propias, CPU y memoria, y no protege contra corrupción, como explica su diseño. FRED no tiene hardware. pidfs rompió ABI sin querer y hubo que corregirlo en las releases siguientes. SEV-SNP como anfitrión exige EPYC Zen 3 o posterior y firmware con SNP.
El weighted interleave tampoco llega a todas partes: las herramientas tienen que conocer la política nueva, y numactl la admite con una versión reciente. Quien tenga un solo nodo NUMA no verá diferencia alguna.
pidfs también cambió la ABI de pidfd_open() sin querer, y las releases siguientes tuvieron que corregirlo: quien escriba una herramienta contra la interfaz nueva debe probarla con más de una versión. Y 6.9 no es LTS: la serie con una LTS sigue siendo 6.6, y las distribuciones que congelan el kernel en primavera siguen en 6.8 hasta la siguiente ventana.
15. Cambios menores
Core
- RWF_NOAPPEND —
pwritev2()puede ignorarO_APPENDen una escritura concreta. - sysctls de IPC — se pueden cambiar dentro del namespace.
- lazy RCU — parámetro de arranque para controlarlo.
- panic_print — volcado de tareas bloqueadas en el pánico.
- swiotlb debugfs — uso del pool transitorio.
- ordenación del kernel — menos intercambios y comparaciones.
Rust
- inicialización in situ — los módulos se inicializan sin mover el valor.
- Rust 1.76 — la cadena de herramientas sube de versión.
Sistemas de ficheros
- bcachefs: renombrar subvolúmenes — los subvolúmenes dejan de ser inmutables.
- btrfs: +6 % en escrituras — menos contención al limpiar bits de retraso.
- ext2: obsoleto — ext2, el predecesor de ext4, queda marcado.
- XFS: reparar cuotas en línea — los contadores se arreglan sin desmontar.
- SMB: durable handles — los ficheros sobreviven a una caída de la conexión.
- SMB: contraseña — se puede cambiar al remontar.
- F2FS: SEEK_DATA — funciona en ficheros comprimidos.
- EROFS: FAULT_NO_SEGMENT — inyección de fallos más fina.
- zonefs: mount API — se pasa a la API nueva.
Networking
- estadísticas por cola — cada cola de la tarjeta tiene las suyas.
- XDP multi-buff genérico — tramas grandes sin driver específico.
- detector de atasco NIC — avisa cuando la cola se atasca.
- UDP peek offset — el flag se puede consultar.
- IPv6 anuncios — nuevo sysctl para los anuncios.
Virtualización y seguridad
- /dev/mshv — Linux puede crear invitados sobre el hipervisor de Microsoft.
- IMA y EVM como LSM — dejan de ser una excepción en el arranque.
16. Qué viene después
La merge window de 6.10 se abre el 13 de mayo y cierra el 26. Ese ciclo traerá mseal(), el perfilador de asignaciones, NTSYNC y el TPM con el bus cifrado, y Linux 6.10 sale el 14 de julio, con su propio inventario en KernelNewbies.
Para las distribuciones, 6.9 es la release del verano: Fedora y las rolling lo adoptan en semanas, mientras que las LTS de 2024 se quedan en 6.8 o en 6.6. Ubuntu 24.04 y Fedora 40 llegaron con 6.8, así que ninguna de las dos lo adopta por defecto; las rolling lo tienen en semanas, y las que congelan en otoño saltarán a 6.11 o 6.12. La LTS sigue siendo 6.6 hasta final de año.
Lo que no se sabrá hasta las siguientes releases es si DM VDO se usa de verdad fuera de los escritorios virtuales y si ntfs3 da la talla ahora que no hay alternativa en el kernel.
17. Referencias
- KernelNewbies: Linux 6.9 — inventario completo por subsistema.
- ChangeLog-6.9 — los 15.678 commits, uno por uno.
- LWN: Some 6.9 development statistics — cifras, empresas y revisores.
- Phoronix: Linux 6.9 Released — resumen de hardware y rendimiento.
- Phoronix: Linux 6.9 features — repaso de las novedades del ciclo.
- Anuncio de Torvalds — el correo original con el shortlog.