Linux 7.3: la release más grande de Linux
18.765 commits y 3.021 desarrolladores, empujados por la IA: Linux 7.3 trae failfs, binfmt_misc con BPF, mejor uso de la VRAM en juegos y Btrfs más rápido.
Linux 7.3 se ha publicado hoy, 18 de octubre de 2026, y es la release más grande de la historia del kernel: 18.765 commits de 3.021 desarrolladores, 807 de ellos novatos. Cambia cómo reparten la CPU los cgroups, completa los sub-schedulers de sched_ext, estrena failfs y fchroot() para aislar procesos y deja que un programa BPF elija el intérprete de cada binario. Btrfs y ext4 ganan velocidad, los juegos en GPUs con poca VRAM dan menos tirones y la marea de parches hechos con IA marca todo el ciclo.
Linux 7.3 se ha publicado hoy, domingo 18 de octubre de 2026, nueve semanas después de 7.2 y dentro de la serie 7.x. Torvalds lo anuncia sin la semana extra que a veces añade tras la rc7: los fixes de la última semana están repartidos por todo el tree y ninguno destaca. LWN recoge el anuncio y las estadísticas del ciclo, y el inventario completo está en KernelNewbies.
Las cifras baten todos los récords. Es el primer ciclo que supera los 20.000 commits en total, 18.765 sin merges, con 3.021 desarrolladores frente a los 2.652 de 7.2 y 807 novatos. El tree crece unas 650.000 líneas netas. La explicación que dan LWN, Torvalds y los maintainers es la misma: los modelos de lenguaje encuentran fallos y escriben parches a un ritmo que el proceso del kernel no había visto nunca.
LWN espera que 7.3 sea la LTS de 2026, pero kernel.org todavía no la ha marcado como longterm y Phoronix apunta que la designación podría recaer en 7.4 si sale antes de fin de año. Hasta que kernel.org lo confirme, 7.3 es una release estable más.
Hay tres claves. La primera es el scheduler: los cgroups reparten la CPU con un método nuevo por defecto y sched_ext permite que cada cgroup tenga su propio scheduler BPF. La segunda es el aislamiento: failfs, fchroot() y los kernel threads separados de PID 1. La tercera es el rendimiento de E/S: Btrfs, ext4, FUSE sobre io_uring y RWF_DONTCACHE en dispositivos de bloque. Estas son las claves; el resto de cambios está al final.
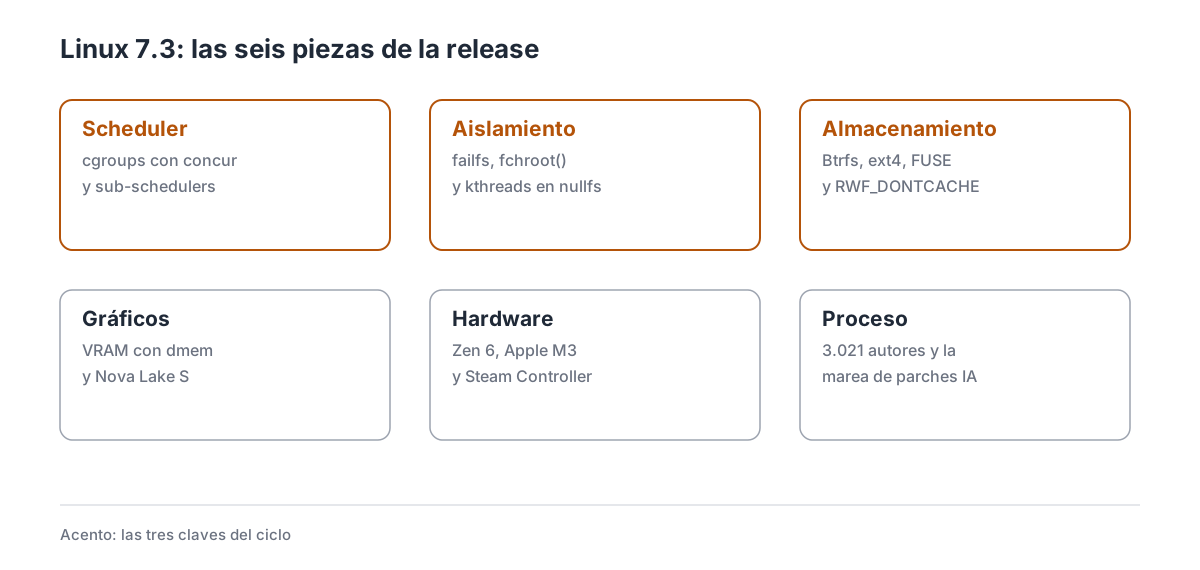
Las seis piezas de la release, con las tres claves resaltadas.
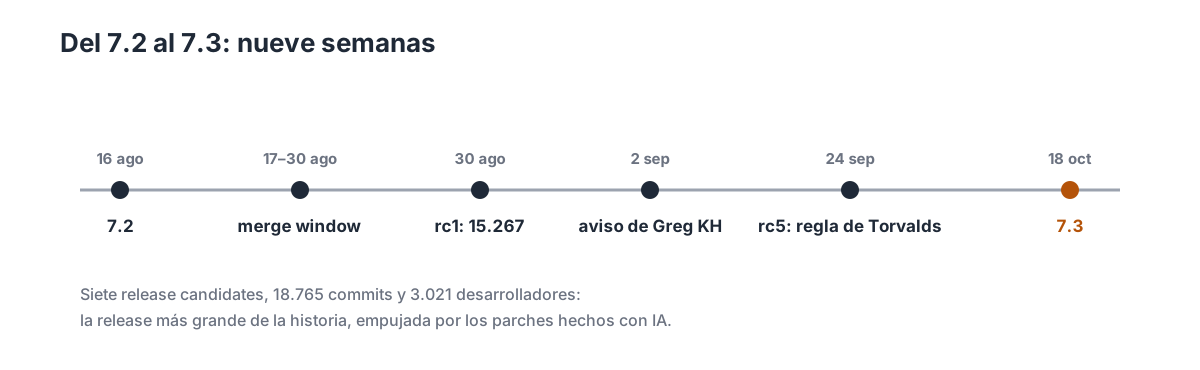
Del 7.2 al 7.3: la merge window, siete release candidates y los avisos sobre la marea de parches.
1. Las cifras de la release más grande del kernel
| Dato | Valor |
|---|---|
| Fecha de release | 18 de octubre de 2026 |
| Versión anterior | 7.2 (16 de agosto de 2026) |
| Merge window | 17 al 30 de agosto de 2026 |
| Changesets en la rc1 | 15.267 |
| Release candidates | 7 |
| Changesets sin merges | 18.765 |
| Desarrolladores | 3.021 |
| Novatos | 807 |
| Empresas | 232 |
| Líneas netas añadidas | ~650.000 |
Commits con Reviewed-by | 50,9 % |
Commits con Tested-by | 7,5 % |
Los 15.267 changesets de la rc1 ya eran la segunda cifra más alta de la historia para una merge window; solo 6.7, que arrastró casi 3.000 commits del historial de bcachefs, tuvo más. Con los fixes de las release candidates, 7.3 supera a todas. El gráfico sitúa la serie 7.x: cada release bate el récord de la anterior, y 7.3 da el salto más grande.
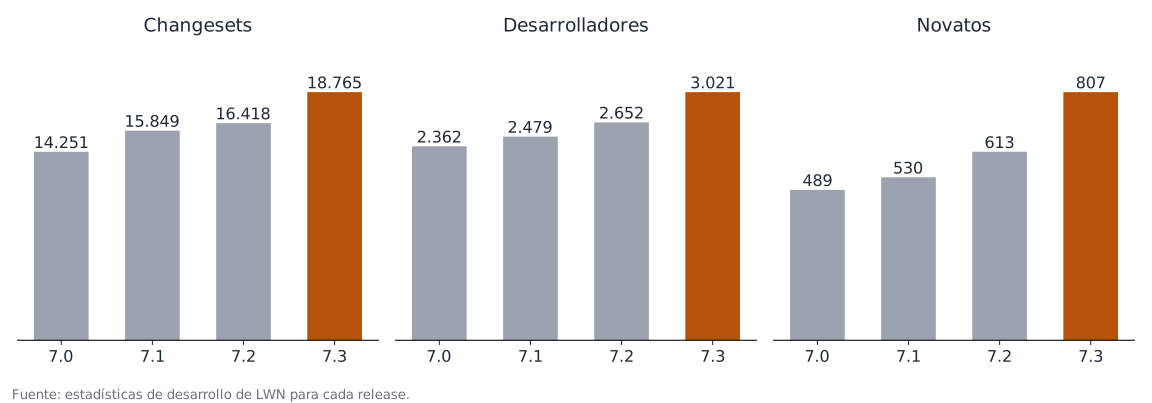
Volumen de la serie 7.x según las estadísticas de LWN; 7.3, resaltado.
La revisión, en cambio, se mantiene: el 50,9 % de los commits lleva Reviewed-by; ese porcentaje venía cayendo y en 7.3 vuelve a subir. Los informes de fallos ya no vienen sobre todo de personas: casi la mitad de los Reported-by vienen de herramientas automáticas, y Sashiko, un revisor que hace un año no existía, aparece en el 19 %. En la rc1 había 1.264 commits con Assisted-by, la etiqueta que declara el uso de un LLM, algo más del 8 %; LWN advierte que la cifra real es sin duda mayor.
El ChangeLog-7.3 tiene la lista completa de commits. LWN cuenta la merge window en dos partes. Torvalds cierra la rc1 el 30 de agosto con una confesión: se lo complicó él mismo por actualizar su sistema en mitad de la merge window.
2. Los cgroups reparten la CPU de otra forma
Un cgroup agrupa procesos para repartirles recursos: todos los procesos de un contenedor, de un servicio de systemd o de una sesión de usuario. Cuando dos grupos compiten por la CPU, el scheduler tiene que decidir cuánto tiempo toca a cada tarea, y hasta ahora lo hacía escalando el peso de cada tarea según cuántas tareas de su grupo corren en esa CPU. Con pocos núcleos funciona; con cientos, esos factores se hacen diminutos y el reparto deja de ser justo.
Peter Zijlstra reescribe esa parte en el pull del scheduler. El nuevo parámetro cgroup_mode ofrece cuatro métodos de reparto —up, max, concur y tasks— y el valor por defecto pasa a ser concur, el más preciso y también el más costoso. El changelog lo dice tal cual: cambian el valor por defecto con la esperanza de que ayude a más gente de la que perjudica. La serie termina moviendo los cgroups a una sola runqueue, lo que debería reducir la sobrecarga y algunos problemas de latencia.
Para el usuario significa que un kernel 7.3 reparte la CPU entre contenedores de forma distinta a 7.2 sin que nadie toque nada. En un portátil apenas habrá diferencia; en un servidor con muchos núcleos y muchos cgroups, conviene medir antes de actualizar, y cgroup_mode permite volver a otro método si concur resulta costoso.
3. sched_ext completa los sub-schedulers
sched_ext permite escribir el scheduler de la CPU como un programa BPF y cargarlo sin recompilar el kernel; entró en Linux 6.12. Desde Linux 7.1, el proyecto trabaja en los sub-schedulers: que un scheduler BPF principal ceda una parte de la máquina a otro scheduler distinto. LWN siguió la última fase en Sched-ext: enqueue() for sub-schedulers and proxy-execution support.
En 7.3, Tejun Heo da la función por terminada en el pull de sched_ext. Un scheduler raíz puede entregar un subárbol de cgroups a un sub-scheduler junto con permisos revocables sobre las CPUs: encolar tareas, expulsarlas o controlar la frecuencia. A partir de ahí, el sub-scheduler decide todo lo que pasa con sus tareas en esas CPUs. El ciclo añade además una ejecución de rescate para que una tarea que se queda sin CPUs accesibles no bloquee el scheduler entero.
Para quien gestione cargas mixtas, la consecuencia es poder dar a un contenedor de juegos o de baja latencia su propia política de planificación sin imponerla al resto de la máquina. Como siempre en sched_ext, hay que escribir o elegir un scheduler BPF y cargarlo; el kernel no trae ninguno activado. La documentación describe la interfaz.
4. failfs y fchroot(): procesos sin rutas absolutas
Un sandbox clásico encierra un proceso en un directorio con chroot(), pero el proceso sigue pudiendo resolver rutas absolutas dentro de ese directorio. Christian Brauner propone ir más lejos: un proceso que no puede resolver ninguna ruta absoluta, y que solo abre ficheros a partir de descriptores que ya tiene abiertos.
La pieza es failfs, la contrapartida de nullfs, que llegó en 7.2: si nullfs es un directorio vacío, failfs es un sistema de ficheros donde todo falla. No se puede montar desde espacio de usuario, no se puede montar nada encima y no aparece en /proc/<pid>/mountinfo. La otra pieza es la syscall fchroot(), la versión de chroot() que recibe un descriptor de fichero en lugar de una ruta. Con fchroot(FD_FAILFS_ROOT) y fchdir(FD_FAILFS_ROOT), cualquier ruta absoluta y cualquier enlace simbólico absoluto devuelven EOPNOTSUPP. La documentación de failfs y la cover letter tienen el detalle.
El mismo ciclo separa los kernel threads de PID 1. Hasta ahora, kthreadd y el proceso init compartían el estado del sistema de ficheros, y un pivot_root() del proceso init cambiaba también el de todos los kernel threads. En 7.3, los kernel threads arrancan en nullfs y PID 1 recibe su propio estado. LWN cuenta los usos de nullfs en Practical uses for a null filesystem.
Para el usuario no cambia nada visible; para quien escriba sandboxes, navegadores o gestores de contenedores, fchroot() evita la race condition entre resolver una ruta y cambiar la raíz, y failfs da una forma de quitarle a un proceso todo acceso por ruta.
5. binfmt_misc con BPF: binarios que eligen su intérprete
binfmt_misc es el mecanismo que permite ejecutar un fichero con un intérprete: registrar que los .jar se abren con Java o que los binarios de ARM pasan por QEMU. Hasta ahora, el intérprete era una cadena fija que se registraba una vez. En 7.3, Brauner hace que un programa BPF decida, en cada exec, si el binario coincide y qué intérprete usar.
El caso que lo motiva es Nix. Sus binarios necesitan encontrar su cargador dinámico en una ruta que depende de dónde esté instalado el paquete, y hoy eso se resuelve reescribiendo los binarios con patchelf o envolviéndolos en scripts. Con un handler BPF, el intérprete se calcula en el momento, por ejemplo relativo al propio binario. El pull de binfmt añade también intérpretes transparentes, que reciben el binario sin tocar los argumentos, y la posibilidad de fijar un intérprete para usarlo dentro de un chroot que no lo contiene. LWN lo explica en Bringing BPF to binfmt_misc.
El límite es que hace falta escribir el programa BPF y que las distribuciones lo adopten; por ahora es una herramienta para quien construye sistemas como NixOS, no algo que el usuario configure.
6. Btrfs y ext4 más rápidos, y menos caché cuando no hace falta
Btrfs trae uno de sus ciclos de rendimiento más notables. El pull de Btrfs recupera el rendimiento de la E/S directa que se había perdido en releases anteriores, quita una espera innecesaria de un jiffy en las cargas con mucho fsync en discos que no son SSD —multiplicando por cinco el rendimiento en esos casos— y hace cinco veces más rápido el fsync con la opción no-holes, activa por defecto desde btrfs-progs 5.15. Phoronix lo midió en una estación con Xeon Granite Rapids, bajo el título Some Incredible Performance Gains. La primera versión de la caché de espacio libre deja de usarse por defecto; los sistemas que aún la tengan siguen funcionando, algo más lentos.
ext4 también mejora en el pull de ext4: las escrituras directas en paralelo, fallocate() y una vía más simple para la E/S directa pequeña que, en la prueba del autor, sube de 1,92 a 2,19 millones de IOPS.
Para las bases de datos que trabajan sobre un dispositivo de bloque sin sistema de ficheros, RWF_DONTCACHE llega a los dispositivos de bloque. Una lectura o escritura con ese flag no deja sus páginas en la caché, pero las demás peticiones sí la aprovechan, algo que la E/S directa no permite elegir petición a petición. Y FUSE sobre io_uring incorpora buffers compartidos y copia cero, que reducen la memoria y las copias de los servidores FUSE.
Las primeras pruebas de Phoronix, hechas a mitad de la merge window, muestran mejoras y también algunas regresiones frente a 7.2. La ganancia de Btrfs depende de la carga: es grande en fsync y E/S directa, y no cambia nada en otras.
7. Juegos con poca VRAM, Nova Lake y el nuevo Steam Controller
Una GPU con 8 GB de VRAM se queda corta enseguida, y cuando dos programas compiten por ella, el último en pedir memoria —a menudo el juego que tienes en primer plano— acaba usando RAM del sistema, mucho más lenta. Natalie Vock cambia ese comportamiento con el controlador dmem de cgroups: en lugar de ceder de inmediato, el kernel desaloja primero los buffers no protegidos para hacer sitio al programa protegido. El problema y la solución se explican en Fixing AMDGPU’s VRAM management for low-end GPUs. Para el usuario significa menos tirones en juegos con GPUs modestas, siempre que el escritorio configure esa protección.
En Intel, los gráficos Xe3P de Nova Lake S pasan a estar activados por defecto, sin el parámetro force_probe, antes de que los procesadores lleguen a la venta. AMD sigue preparando las plataformas Zen 6, con eventos de perf y drivers de plataforma, y estrena un driver para los LEDs del mini PC Ryzen AI Halo. Los chips Apple M3 Pro, Max y Ultra arrancan con mainline, aunque todavía sin GPU.
En periféricos, el driver hid-steam admite el Steam Controller de 2026, y el driver de la consola MSI Claw entra en el tree gracias a Valve. El soporte de las GPU AMD antiguas también mejora, con modificadores de formato y mejor recuperación tras un cuelgue, según el resumen de Phoronix.
8. El salseo: la marea de parches hechos con IA
El ciclo de 7.3 está marcado de principio a fin por un mismo asunto: el volumen de parches y de informes de fallos generados con LLM. Ya se notaba en Linux 7.1, cuando se debatió la etiqueta Assisted-by; en 7.3 se convierte en el problema principal de los maintainers.
Kicinski: la red está desbordada. El 20 de agosto, Jakub Kicinski, maintainer de red, escribe en su pull que él y Paolo Abeni están «completely overwhelmed»: entre un tercio y la mitad de los 648 parches de net-next parecen fixes y limpiezas de baja prioridad generados con IA. Su respuesta es usar la IA contra la IA: con presupuesto de Meta, revisan cada parche con varios modelos y planean dejar en manos de los modelos el trabajo administrativo. Phoronix recoge el pull completo.
Greg Kroah-Hartman avisa de un ciclo complicado. El 2 de septiembre, con la rc1 recién publicada, muestra su bandeja de USB: 1.732 correos pendientes de 4.807. Rechazar un parche que parece un fix evidente es difícil, explica, y no quiere bloquear correcciones reales, así que solo queda revisarlos uno a uno. Repite una frase de sus charlas: van a ser «18 meses largos». Phoronix lo cuenta; en staging, Kroah-Hartman ya rechaza los parches generados con IA salvo los de seguridad.
Torvalds endurece las release candidates. La rc2 sale tan cargada que bromea con que todos culparán a la IA. En la rc5 acepta el pull de red, pero fija una regla: después de la merge window solo entran regresiones o fallos críticos, no correcciones de defectos antiguos que nadie había notado y que a menudo solo aparecen porque un LLM los ha señalado. Ya lo había avisado en la rc5 de 7.1. Kicinski acepta que los fixes de ovpn estaban en el límite y promete filtrar más.
Cada subsistema responde a su manera. Johannes Berg ignora en wireless casi todos los parches de syzbot generados con IA salvo los que puede validar en segundos; staging los rechaza; la red los revisa con más IA. En la última semana del ciclo, Darrick Wong, una de las personas más activas en XFS y en iomap durante dos décadas, se retira de su último papel de revisor tras 23 años en Linux, como recoge Phoronix; sus últimas series en XFS se titulaban «LLM-inspired bug fixes», y la vigésimo primera es de principios de octubre.
LWN aporta el dato que matiza el pesimismo: el porcentaje de commits que corrigen fallos introducidos en el mismo ciclo empieza a bajar en 7.1 y cae con más fuerza en 7.3. Puede que la revisión automática esté filtrando los fallos más evidentes. Para el usuario, el efecto inmediato es un kernel con más correcciones que nunca; para el proyecto, la pregunta es cuánto tiempo pueden sostener los maintainers ese ritmo.
9. Por subsistemas
9.1 Memoria y virtualización
Kiryl Shutsemau, de Meta, añade a userfaultfd el seguimiento del working set de la memoria de una máquina virtual, con el modo UFFDIO_REGISTER_MODE_RWP: un gestor de máquinas virtuales sabe qué páginas usa cada máquina virtual y puede mandar las que no toca a un almacenamiento más barato. LWN lo describe como, posiblemente, el mayor bloque de código del core escrito con ayuda de un LLM hasta la fecha. MGLRU protege mejor el código ejecutable para que siga en memoria, y KSM resuelve un cuello de botella en el reverse mapping con miles de VMAs.
9.2 Sistemas de ficheros
ntfs3 admite los flujos de datos alternativos de NTFS, a los que se accede con dos puntos en el nombre del fichero. El servidor SMB del kernel, ksmbd, admite copias de Time Machine de macOS de forma opcional, además de cifrado por recurso compartido. EFS, el sistema de ficheros de las estaciones SGI, y FreeVxFS, el de SCO UnixWare, salen del tree. F2FS vacía la caché de varios dispositivos en paralelo.
9.3 Seguridad
La interfaz AF_ALG, que expone la criptografía del kernel a espacio de usuario y lleva años camino de desaparecer, queda restringida por defecto con un sysctl nuevo; iwd, BlueZ y cryptsetup todavía la necesitan, y el ciclo permite más cifrados para cryptsetup. AppArmor acepta políticas comprimidas desde espacio de usuario, y s390 estrena kCFI con Clang.
9.4 Arquitecturas
PowerPC recibe soporte de Rust y la base de Power12. En ARM, varias plataformas de 32 bits pasan a estar marcadas como obsoletas: siguen en 7.3, pero pueden desaparecer después. En x86 desaparece el código de «SMP alternatives», que parcheaba las instrucciones de bloqueo al arrancar en una máquina de un solo procesador.
9.5 Rust
El pull de Rust añade tipos de E/S, la API de fwctl y SRCU, y el driver Rust Binder gana registro de depuración dinámico y soporte de netlink. La preparación para compilar Rust con el backend de GCC empieza a dejar fixes en el tree.
10. Lo que no llega
- El scheduler fair de DRM sigue sin ser el modo por defecto. 7.2 lo revirtió por regresiones en la RX 9070 XT y lo marcó como experimental; 7.3 mantiene FIFO. Phoronix.
- 7.3 no es LTS todavía. LWN la espera como LTS de 2026, pero kernel.org la lista como estable y la decisión puede recaer en 7.4. Releases de kernel.org.
- TrenchBoot no entra. El ciclo prepara el TPM para el arranque seguro con TrenchBoot, pero el proyecto sigue en revisión. Phoronix.
- Apple M3 sin GPU. Los M3 Pro, Max y Ultra arrancan, pero sin aceleración gráfica ni varias funciones básicas para el uso diario. Asahi Linux.
- Las plataformas ARM de 32 bits obsoletas siguen, por ahora. Están marcadas para retirarse, y con ellas se quedan huérfanos cientos de drivers. KernelNewbies.
- sched_ext sin scheduler activado. Los sub-schedulers están completos, pero el kernel no trae ninguno cargado por defecto. Repositorio scx.
11. Cambios menores
Una selección de cambios más pequeños, agrupados por área. Cada uno lleva su enlace y lo que implica.
Core
- Kernel threads en nullfs —
/proc/2/rootpasa a ser un nullfs vacío y unpivot_root()deinitya no afecta a los kernel threads. - binfmt_misc con QEMU fijado — ejecutar binarios ARM dentro de un
chrootque no contiene QEMU.
Gráficos y periféricos
dmemcon ficheropeak— muestra el pico de VRAM que ha usado cada cgroup.- V3D 3.3 y 4.1 obsoletos — las versiones más antiguas de la GPU V3D de Broadcom empiezan su retirada.
- Wi-Fi HaLow con mm81x — driver para los chips de largo alcance de Morse Micro.
Seguridad
- kCFI más barato en x86 — la secuencia de llamada de kCFI se optimiza en procesadores Intel antiguos.
12. Qué viene después
La merge window de 7.4 se abrió el 19 de octubre de 2026, al día siguiente de la release. Torvalds avisó, como recoge heise, de que se iba de vacaciones: las mañanas en un barco y bajo el agua, las tardes con los merges, y quizá una semana extra de merge window, aunque sin aceptar pull requests que lleguen tarde. Si 7.4 sale antes de fin de año, puede ser ella la LTS de 2026 en lugar de 7.3.
La marea no se detiene: el 10 de noviembre, Lorenzo Stoakes, de Arm, deja de revisar memoria, core, misc y Rust porque no da abasto con las series generadas con IA, según Phoronix. Para quien administre sistemas, 7.3 es una release para probar con calma: el cambio de reparto de los cgroups y el volumen de cambios aconsejan medir antes de actualizar, y la LTS actual sigue siendo 6.18. Para quien desarrolle, deja interfaces nuevas que conviene conocer: fchroot(), failfs, los handlers BPF de binfmt_misc y RWF_DONTCACHE en bloque.
La página de la serie 7.x recoge todas las releases, el índice del kernel tiene el resto y LWN sigue el estado de las ramas estables. La release anterior es Linux 7.2.