MCP vs function calling: lo medí en tokens
Con 200 herramientas, contestar una pregunta de una línea cuesta 38.684 tokens de entrada. MCP no ahorra ni uno: lo medí con el mismo modelo y la misma tarea.
Le hice una pregunta de una línea a un modelo de lenguaje: «¿cuántos posts tengo sobre Docker?». Para contestarla, el modelo gastó 38.684 tokens de entrada. Mi pregunta apenas ocupaba unos pocos. Casi todo lo demás era la lista de 200 herramientas (funciones que mi programa puede ejecutar cuando el modelo se lo pide) que le envío en cada petición para que sepa qué puede hacer.
Un token es la unidad en la que un modelo lee el texto: un trozo de palabra. En inglés, 100 tokens equivalen a unas 75 palabras, y en español hacen falta algunos más. Importan por dos motivos: los proveedores cobran por token, y cada modelo tiene un límite de tokens que puede leer de una vez.
Esa cifra cambia la discusión habitual sobre las dos formas de dar herramientas a un modelo, tool calling (también llamado function calling) y MCP, que explico enseguida. En esa discusión se mezclan dos preguntas distintas: una trata del formato con que el modelo pide una herramienta y la otra, de dónde se guardan esas herramientas. Monté un banco de pruebas para separarlas y medí cada opción con el mismo modelo, la misma pregunta y la misma herramienta.
Resumen en 30 segundos: function calling y MCP gastan exactamente los mismos tokens, porque los dos envían el catálogo completo al modelo. Lo que dispara la factura es cuántas herramientas le envías a la vez: con 200, una pregunta cuesta 38.684 tokens de entrada. Si en lugar del catálogo le das un buscador y le pasas cada herramienta solo cuando la pide, la misma pregunta baja a 2.100.
1. El modelo pide; la cocina ejecuta
Antes de comparar nada, conviene dejar claro qué hace el modelo y qué hace tu programa. Un modelo de lenguaje no tiene acceso a tu base de datos, ni a tus ficheros, ni a internet. Lo único que hace cuando «usa una herramienta» es escribir un texto con una forma pactada que dice qué herramienta quiere usar y con qué datos. La ejecuta el agente: el programa que habla con el modelo, le ofrece las herramientas y hace lo que el modelo pide. Y es el agente quien decide qué está permitido.
Es la diferencia entre pedir y hacer, y la guía de agentes de Anthropic la usa como criterio: el modelo decide, el agente actúa. Piensa en un restaurante: el camarero apunta el pedido en una nota, pero quien entra en la cocina y cocina es otro. Si la nota pide un plato que no existe, la cocina la devuelve y el camarero vuelve a preguntar. El modelo es el camarero: no toca nada.
Todo lo que el modelo lee en cada petición se llama contexto: tus instrucciones, la conversación hasta ese momento y la lista de herramientas disponibles. Tiene un tamaño máximo, la ventana de contexto, y cada token que entra se paga. Por eso importa tanto cuántas herramientas metes en él.
Que un modelo aprenda cuándo llamar a una herramienta no es nuevo: Toolformer ya lo demostró en 2023. Después, esa capacidad pasó a expresarse con un formato fijo en vez de con texto libre que hay que interpretar. Con eso claro, ya se puede explicar qué es cada cosa.
2. Un formato de petición y un mostrador de herramientas
Function calling es dos cosas a la vez: un formato y una habilidad entrenada. El formato es la lista que el agente envía al modelo junto a la pregunta: cada función con su nombre, para qué sirve y qué datos necesita. La habilidad es que el modelo ha sido entrenado para usar esa lista. OpenAI lo lanzó en junio de 2023 y lo explicó así: sus modelos se ajustaron para «detectar cuándo hay que llamar a una función» y para «responder con un JSON que cumpla su firma», en vez de con texto.
Un ejemplo sencillo. En él intervienen tres piezas, y conviene no mezclarlas:
| Pieza | Qué es | Qué hace |
|---|---|---|
| El modelo | El modelo de lenguaje, en los servidores de su proveedor | Lee texto y escribe texto. Nada más |
| El agente | El programa que escribes tú | Habla con el modelo y ejecuta las funciones |
| El servicio del tiempo | Una web externa con datos meteorológicos | Responde a quien le pregunta |
La función consultar_tiempo no viene con el modelo: la escribe quien programa el agente, y es código normal que consulta esa web.
1
2
3
4
def consultar_tiempo(ciudad):
    # Código del agente: pregunta a un servicio meteorológico (dirección de ejemplo)
    respuesta = requests.get(f"https://tiempo.example.com/hoy/{ciudad}")
    return respuesta.json()["resumen"]   # por ejemplo, "18 °C y soleado"
Así se reparte el trabajo cuando alguien pregunta por el tiempo:
- El agente envía al modelo la pregunta «¿Qué tiempo hace en Madrid?» y, junto a ella, la descripción de la función: se llama
consultar_tiempo, da el tiempo de hoy y necesita el nombre de una ciudad. No le envía el código, solo esa descripción. - El modelo no sabe qué tiempo hace hoy, pero al leer la descripción reconoce que esa función le daría el dato. Así que no contesta con texto: escribe
{"name": "consultar_tiempo", "arguments": {"ciudad": "Madrid"}}. Es solo una petición; no se ejecuta nada. - El agente lee esa nota, ejecuta su función
consultar_tiempo("Madrid"), que pregunta a la web del tiempo y obtiene «18 °C y soleado», y envía ese resultado al modelo en una segunda petición. - El modelo, ahora con el dato delante, redacta la respuesta para la persona: «En Madrid hace 18 grados y sol».
¿Y dónde van exactamente esas funciones? En cada petición que el agente envía al modelo, en un campo propio llamado tools, separado de las instrucciones del system prompt y de la pregunta. La petición del paso 1 es, recortada, esto:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
{
  "model": "deepseek-chat",
  "messages": [
    {"role": "system", "content": "Eres un asistente útil."},
    {"role": "user", "content": "¿Qué tiempo hace en Madrid?"}
  ],
  "tools": [{
    "type": "function",
    "function": {
      "name": "consultar_tiempo",
      "description": "Da el tiempo de hoy en una ciudad.",
      "parameters": {
        "type": "object",
        "properties": {"ciudad": {"type": "string"}},
        "required": ["ciudad"]
      }
    }
  }]
}
El proveedor coge ese campo y lo mete en el contexto del modelo junto al resto. Anthropic lo documenta para Claude: las definiciones de tools cuentan como tokens de entrada, y la API añade además unas instrucciones propias para que el modelo sepa usarlas. Como el modelo no recuerda nada entre una petición y la siguiente, el agente tiene que volver a enviar la lista también en la segunda petición, la del paso 3.
Que la función esté en la lista no obliga a usarla: el modelo decide en cada petición. Si con esa misma lista la persona escribe «Hola, ¿qué tal?», el modelo contesta con texto y no pide nada, porque ninguna función le hace falta. Y si la lista tuviera también consultar_saldo y enviar_correo, para la pregunta del tiempo elegiría solo consultar_tiempo.
Entonces, ¿qué tiene de entrenado el modelo? Nada que ver con el tiempo: no conoce esa web ni esa función, y de consultar_tiempo solo sabe lo que dice su descripción en esa petición. Lo que aprendió en su entrenamiento es la habilidad general de leer cualquier lista de funciones, decidir si alguna le sirve y escribir la petición con el formato exacto. Mañana le describes consultar_saldo o enviar_correo y hace lo mismo.
Hoy todos los proveedores ofrecen esta habilidad, con variaciones mínimas y nombres distintos: function calling en OpenAI, tool use en Anthropic, tool calling en general. Son lo mismo. Martin Fowler lo desarrolla con un agente de compras completo si quieres ver el formato antes de seguir.
MCP (Model Context Protocol) es un protocolo de conexión. En vez de que cada agente escriba sus herramientas, un servidor las publica y el agente le pregunta qué hay. Así, la misma herramienta la pueden usar Claude, Cursor, VS Code o tu propio agente sin escribir la integración en cada uno. La visión general del protocolo lo resume en dos pantallas y este catálogo de servidores muestra cuántos hay ya.
La imagen que mejor los separa: function calling es cómo se escribe la petición; MCP es el mostrador donde están las herramientas. Puedes pedir sin mostrador, llevando tus propias herramientas, y puedes tener mostrador sin que cambie la forma de pedir.
| Function calling | MCP | |
|---|---|---|
| Qué es | Un formato de petición y respuesta, y la habilidad entrenada del modelo para usarlo | Un protocolo entre el agente y un servidor |
| Quién describe las herramientas | Tú, en cada petición | El servidor, cuando el agente se lo pregunta |
| Dónde están las herramientas | En tu agente | En el servidor, en tu máquina o en otra |
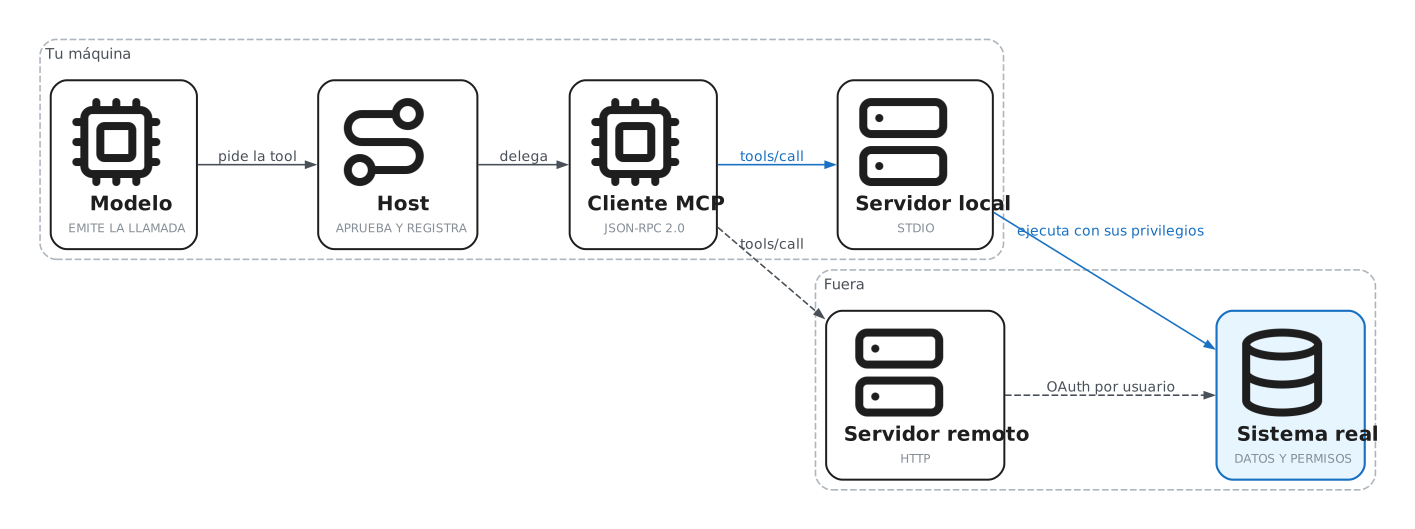
| Quién ejecuta | Tu agente | El servidor, con sus permisos |
| Qué resuelve | Que el modelo pida con datos bien estructurados | Que N aplicaciones usen M herramientas sin escribir N×M integraciones |
| Qué no resuelve | Compartir herramientas entre aplicaciones | El formato de la petición, que sigue haciendo falta |
| Cuándo basta | Si solo las usa tu agente | Si varias aplicaciones comparten las herramientas |
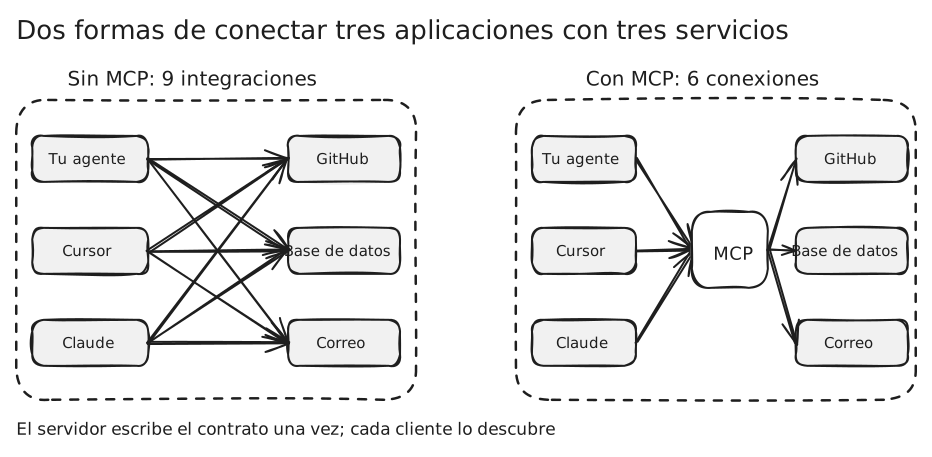
Y hay cuatro ideas equivocadas sobre MCP que se repiten a menudo:
- «Es un framework». En realidad es un acuerdo sobre qué mensajes se envían; FastMCP es una de las bibliotecas que lo cumplen.
- «Sustituye a function calling». Se apoya en él: el modelo sigue pidiendo la herramienta con el mismo formato, solo que la descripción de la herramienta la trajo un servidor.
- «Es un producto de una empresa». La especificación es abierta y hay aplicaciones compatibles y servidores de muchas empresas.
- «Es una API más». Una API es la puerta por la que un programa habla con otro sistema, con direcciones fijas a las que llamar. MCP no tiene direcciones que memorizar, sino mensajes con un orden fijo, como se ve en la sección 4.
Con las definiciones separadas, toca ver cada una por dentro.
3. Function calling: la descripción está en tu agente
En la vía clásica, cada petición al modelo lleva adjunta la descripción de las herramientas disponibles. Esa descripción es un JSON Schema: un JSON que dice cómo se llama la herramienta, para qué sirve y qué datos necesita. El modelo responde con un campo tool_calls que dice qué quiere usar; el agente lo ejecuta y le devuelve el resultado como un mensaje más.
Así es una respuesta real de la API de DeepSeek, por la que el agente habla con el modelo a través de internet, con una sola herramienta declarada:
1
2
3
4
5
6
7
8
9
10
11
12
13
{
  "choices": [{
    "message": {
      "role": "assistant",
      "tool_calls": [{
        "id": "call_00_2cRXMgNKOlIkH2e7IysT1157",
        "type": "function",
        "function": { "name": "contar_posts", "arguments": "{\"tema\": \"Docker\"}" }
      }]
    }
  }],
  "usage": { "prompt_tokens": 301, "completion_tokens": 41 }
}
La petición se ve entera: el nombre de la herramienta, los datos y un identificador de la llamada. Lo que no está en el JSON es el permiso. El modelo pidió contar_posts; si esa función borrase la base de datos, la habría pedido igual, porque no distingue entre leer y borrar. Comprobar los datos, decidir quién puede hacer qué y guardar un registro es trabajo del agente.
Y aquí aparece el coste que casi nadie mira: la descripción de las herramientas viaja en cada petición, aunque el modelo no use ninguna. La documentación de function calling de OpenAI lo dice sin rodeos: las definiciones van dentro de la petición y cuentan como tokens de entrada. Además, una pregunta con herramienta necesita dos peticiones, como en el ejemplo del tiempo de la sección 2:
- Primera petición: el agente envía la pregunta y el catálogo de herramientas. El modelo contesta pidiendo una herramienta.
- Segunda petición: el agente ejecuta la herramienta y vuelve a enviárselo todo al modelo (la pregunta, otra vez el catálogo, la petición del modelo y el resultado de la herramienta) para que redacte la respuesta final.
El catálogo viaja en las dos. Así son las dos peticiones que envía el agente para la pregunta de este post, recortadas (tools lleva la descripción de contar_posts que ya has visto en la sección 2 y en el ejemplo del tiempo):
1
2
3
4
5
6
7
{
  "model": "deepseek-chat",
  "messages": [
    {"role": "user", "content": "¿Cuántos posts tengo sobre Docker? Usa una herramienta."}
  ],
  "tools": [ …el catálogo completo… ]
}
El modelo contesta con la respuesta de arriba: no escribe texto, pide contar_posts con {"tema": "Docker"}. El agente ejecuta su función, que devuelve «Hay 8 posts sobre docker.», y envía la segunda petición:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
{
  "model": "deepseek-chat",
  "messages": [
    {"role": "user", "content": "¿Cuántos posts tengo sobre Docker? Usa una herramienta."},
    {"role": "assistant", "tool_calls": [{
      "id": "call_00_2cRXMgNKOlIkH2e7IysT1157",
      "type": "function",
      "function": {"name": "contar_posts", "arguments": "{\"tema\": \"Docker\"}"}
    }]},
    {"role": "tool", "tool_call_id": "call_00_2cRXMgNKOlIkH2e7IysT1157",
     "content": "Hay 8 posts sobre docker."}
  ],
  "tools": [ …el catálogo completo, otra vez… ]
}
Fíjate en lo que se repite: la pregunta y el catálogo entero. Lo nuevo son los dos últimos mensajes, la petición que hizo el modelo y el resultado de la herramienta, unidos por el mismo identificador. Con eso delante, el modelo ya contesta con texto, algo como «Tienes 8 posts sobre Docker».
Con una sola herramienta, la primera petición de la respuesta de arriba ocupó 301 tokens de entrada: es el valor de prompt_tokens. La segunda ocupó algo más, unos 380, porque además del catálogo lleva la petición del modelo y el resultado. En total, la pregunta completa costó 682 tokens de entrada. Con doscientas herramientas, que se repiten en las dos peticiones, 38.684. El cookbook de OpenAI tiene una comparación parecida con el ciclo completo, si prefieres leerla en código.
4. MCP: la descripción pasa a un servidor
Con MCP, la descripción de las herramientas cambia de sitio. En vez de que el agente la escriba, un servidor la publica y el agente pregunta qué herramientas hay. En la conversación participan tres piezas:
- el host, que es el nombre que da MCP al agente: la aplicación que habla con el modelo (Claude, Cursor o la tuya) y decide qué se aprueba;
- el cliente, una pieza dentro del agente que se encarga de la conexión con un servidor. El agente crea un cliente por cada servidor al que se conecta;
- y el servidor, que publica las herramientas y las ejecuta.
Los mensajes entre cliente y servidor van en JSON-RPC 2.0, un formato de 2010 para pedirle a otro programa que ejecute algo y recibir la respuesta, todo en JSON. Viajan por una de dos vías, que la especificación llama transportes: stdio, que usa la entrada y la salida estándar de un proceso cuando el servidor se ejecuta en tu propia máquina, o HTTP cuando está en otra. La especificación de MCP fija además un orden: primero el cliente y el servidor se presentan y acuerdan qué sabe hacer cada uno, y después piden herramientas. Anthropic lo presentó en noviembre de 2024 como estándar abierto.
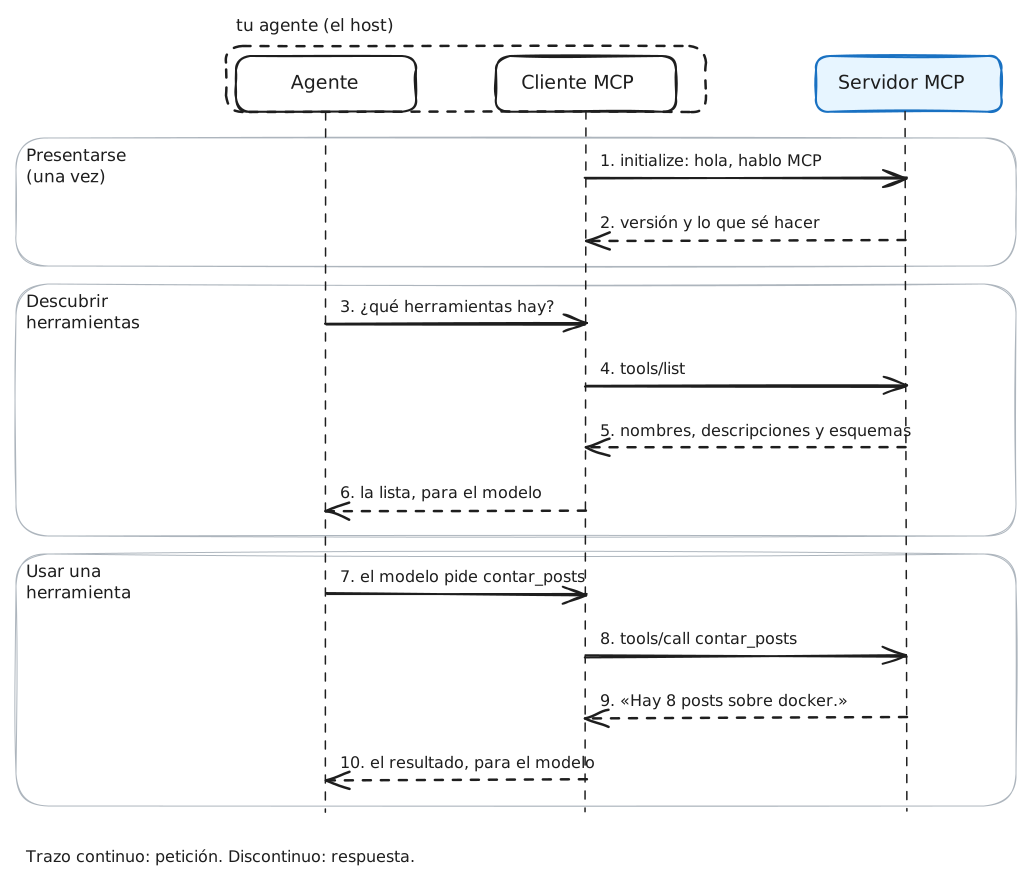
Un servidor puede ofrecer tres cosas distintas, y la distinción importa porque solo una se parece a function calling:
- Herramientas: funciones que hacen algo y piden datos de entrada. Es lo comparable.
- Recursos: datos que el host puede leer, como ficheros o filas de una tabla. El modelo no los «llama»; los consulta el host.
- Prompts: plantillas de instrucciones que el servidor ofrece al usuario.
Este es el mensaje real con el que un servidor de pruebas describe una de sus herramientas, en respuesta a tools/list:
1
2
3
4
5
6
7
{"jsonrpc":"2.0","id":2,"result":{"tools":[{
  "name":"contar_posts",
  "description":"Cuenta cuántos posts del blog tratan un tema concreto.",
  "inputSchema":{"type":"object",
    "properties":{"tema":{"type":"string","description":"Tema a contar"}},
    "required":["tema"]}
}]}}
Es casi el mismo objeto que en function calling. La diferencia de fondo es quién lo mantiene y para cuántos agentes. Un servidor MCP lo escribe una vez el dueño del sistema y lo usan Claude, Cursor, VS Code o tu agente, sin que cada uno repita la integración. Así, un problema de N aplicaciones por M herramientas pasa a ser N más M. Pero fíjate en lo que no cambia: para que el modelo pueda elegir, el host tiene que meter esa descripción en el contexto, igual que en function calling.
5. Montar la misma herramienta dos veces
Para comparar de verdad hay que construir las dos vías con la misma herramienta, y una tercera variante, el descubrimiento progresivo, que se explica en la sección 6. Uso una consulta sencilla sobre el blog, contar_posts(tema), que devuelve cuántos posts hay de un tema. El código completo está en el dossier del post y aquí van las piezas que importan. Para montarlo hace falta un entorno de Python aislado, y con uv, la herramienta de Astral, son dos comandos.
5.1 El catálogo, definido en un solo sitio
Para que la comparación sea justa, las dos vías tienen que ofrecer al modelo exactamente las mismas herramientas. Por eso el catálogo sale de una sola función, build(size), y tanto la vía de function calling como la de MCP la usan: así es imposible que una tenga una herramienta de más o una descripción distinta.
La función devuelve tantas herramientas como se le pidan: 1, 10, 50 o 200. Solo una sirve para la pregunta, contar_posts. El resto son distractores: herramientas inventadas que también tratan del blog y tienen nombres parecidos, como contar_visitas, contar_redirecciones o resumir_posts_etiqueta. Están ahí para comprobar que el modelo sigue eligiendo la correcta cuando la lista crece:
1
2
3
4
5
6
7
8
9
10
11
12
def build(size):
    tools = [{
        "name": "contar_posts",
        "description": "Cuenta cuántos posts del blog tratan un tema concreto.",
        "parameters": {
            "type": "object",
            "properties": {"tema": {"type": "string", "description": "Tema a contar"}},
            "required": ["tema"],
        },
    }]
    # ... size - 1 distractores con nombres y esquemas realistas
    return tools[:size]
5.2 La vía de function calling
Cuarenta líneas y ningún servidor: se envía el catálogo, se recibe la petición del modelo y la función se ejecuta dentro del propio agente.
1
2
3
4
5
6
7
8
9
10
11
tools = [{"type": "function", "function": entry} for entry in build(size)]
messages = [{"role": "user", "content": "¿Cuántos posts tengo sobre Docker? Usa una herramienta."}]

payload = chat(messages, tools)          # POST a /chat/completions
calls = payload["choices"][0]["message"]["tool_calls"]
if calls:
    result = catalog.call(calls[0]["function"]["name"],
                          json.loads(calls[0]["function"]["arguments"]))
    messages += [payload["choices"][0]["message"],
                 {"role": "tool", "tool_call_id": calls[0]["id"], "content": result}]
    chat(messages, tools)                # segunda vuelta con el resultado
5.3 La vía MCP
El servidor es un fichero con FastMCP, una biblioteca que se apoya en el SDK oficial de Python de MCP y ahorra escribir los mensajes del protocolo a mano. Registrar el catálogo tal cual no funciona: FastMCP rechaza las funciones con **kwargs, porque necesita conocer cada argumento para escribir la descripción de la herramienta. La solución es generar una función por herramienta y devolverle la descripción original.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
from fastmcp import FastMCP
from fastmcp.tools.base import Tool

mcp = FastMCP("banco-de-pruebas")

def make_function(entry):
    names = list(entry["parameters"]["properties"])
    signature = ", ".join(f"{name}=None" for name in names)
    body = ", ".join(f"'{name}': {name}" for name in names)
    source = f"def {entry['name']}({signature}):\n    return _call('{entry['name']}', {{{body}}})\n"
    namespace = {"_call": catalog.call}
    exec(source, namespace)
    return namespace[entry["name"]]

for entry in catalog.build(SIZE):
    tool = Tool.from_function(make_function(entry), name=entry["name"],
                              description=entry["description"])
    tool.parameters = entry["parameters"]   # conserva required y descripciones
    mcp.add_tool(tool)
Del lado del agente, el cliente de FastMCP pregunta y llama sin saber qué hay detrás:
1
2
3
4
5
6
from fastmcp import Client

async with Client({"mcpServers": {"bench": {
        "command": sys.executable, "args": ["server.py"], "env": env}}}) as client:
    listing = await client.list_tools()
    resultado = await client.call_tool("contar_posts", {"tema": "docker"})
Tres trampas que te hacen perder una tarde.
- FastMCP lanza
ValueError: Functions with **kwargs are not supported as toolssi intentas registrar una función genérica.- El
Clientde FastMCP 4 no acepta un argumentoenv. Las variables de entorno del servidor se pasan con la configuración estándarmcpServers, que sí lleva el campoenv.- En el SDK 2 de MCP, los campos pasaron a llamarse en
snake_case: leertool.inputSchemadaAttributeErrory hay que usartool.input_schema.
5.4 La variante del descubrimiento progresivo
Es la vía de function calling con un cambio: en lugar del catálogo, el modelo recibe un buscador. Así es en el banco, recortado. Primero, la descripción del buscador y la función que busca, que es del agente y se limita a contar cuántas palabras de la consulta aparecen en el nombre y la descripción de cada herramienta:
1
2
3
4
5
6
7
8
9
10
11
12
13
SEARCH_TOOL = {"type": "function", "function": {
    "name": "buscar_tools",
    "description": "Busca herramientas disponibles por descripción. Devuelve los esquemas que coinciden.",
    "parameters": {"type": "object",
                   "properties": {"consulta": {"type": "string", "description": "Qué necesitas hacer"}},
                   "required": ["consulta"]}}}

def search(entries, consulta, top=3):
    # Puntúa cada herramienta por las palabras que comparte con la consulta del modelo
    words = {w for w in re.findall(r"\w+", consulta.lower()) if len(w) > 2}
    scored = [(sum(w in f"{e['name']} {e['description']}".lower() for w in words), e)
              for e in entries]
    return [e for hits, e in sorted(scored, key=lambda pair: -pair[0]) if hits][:top]
Y las peticiones al modelo:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
entries = catalog.build(size)
messages = [{"role": "user", "content": "¿Cuántos posts tengo sobre Docker? Usa una herramienta."}]

# 1.ª petición: el modelo solo tiene el buscador, y lo usa
first = chat(messages, [SEARCH_TOOL])
call = first["choices"][0]["message"]["tool_calls"][0]
matches = search(entries, json.loads(call["function"]["arguments"])["consulta"])

# 2.ª petición: el buscador y las tres herramientas que mejor encajan
messages += [first["choices"][0]["message"],
             {"role": "tool", "tool_call_id": call["id"], "content": json.dumps(matches)}]
tools = [SEARCH_TOOL] + [{"type": "function", "function": e} for e in matches]
second = chat(messages, tools)          # aquí el modelo pide contar_posts

# 3.ª petición: el agente ejecuta contar_posts y el modelo redacta la respuesta,
# igual que en la vía de function calling
El catálogo de 200 herramientas no sale nunca del agente: al modelo solo le llegan el buscador y, en la segunda petición, tres descripciones.
Con las tres vías montadas, toca ver qué cambia al usarlas.
6. Cuatro caminos, la misma pregunta
El banco ejecuta la misma tarea con cuatro configuraciones y cuatro tamaños de catálogo: el mismo modelo (deepseek-chat), la misma pregunta y la misma herramienta. Las cuatro configuraciones son function calling, MCP por stdio, MCP por HTTP y el descubrimiento progresivo, que es la única que cambia la forma de trabajar del agente.
Qué es el descubrimiento progresivo. Es una forma de trabajar en la que el modelo no recibe la lista de herramientas, sino un buscador para encontrarlas: primero busca la que necesita y solo entonces recibe su descripción. Es lo que haces en una biblioteca grande: no te lees el catálogo entero antes de pedir un libro, sino que preguntas en el mostrador y te traen los tres que encajan con lo que buscas.
En las otras tres configuraciones, el agente envía el catálogo completo en cada petición. En el descubrimiento progresivo no lo envía nunca: le da al modelo una sola herramienta, un buscador llamado buscar_tools, y le pasa las demás solo cuando las pide. Con la pregunta de este post, eso son tres peticiones:
- Primera petición: la pregunta y una única herramienta,
buscar_tools. El modelo no ve las 200 herramientas; solo sabe que puede buscar. Así que contesta pidiendo una búsqueda, con algo como «contar posts sobre un tema». - Segunda petición: el agente hace esa búsqueda en su catálogo, comparando las palabras de la consulta con el nombre y la descripción de cada herramienta, y se queda con las tres que más coinciden. Se las envía al modelo junto con el buscador. Entre esas tres está
contar_posts, y el modelo la pide. - Tercera petición: el agente ejecuta
contar_postsy le envía el resultado al modelo, que redacta la respuesta.
El modelo nunca carga más de cuatro descripciones (el buscador y tres resultados), tenga el catálogo 10 herramientas o 200. A cambio, hace una petición más.
Cada combinación de camino y tamaño de catálogo se ejecutó tres veces, y la tabla da la mediana: el valor del medio de las tres. Los tokens son los de entrada de la pregunta completa (las dos peticiones, o las tres del descubrimiento progresivo), según la propia API, y la latencia es el tiempo hasta tener la respuesta. Es la misma pregunta que se hizo MCPBench, pero con function calling al lado y no solo con servidores de búsqueda.
| Herramientas | Camino | Tokens | Latencia | Acierto |
|---|---|---|---|---|
| 1 | Function calling | 682 | 2.017 ms | 3/3 |
| 1 | MCP stdio | 682 | 1.975 ms | 3/3 |
| 1 | MCP HTTP | 682 | 1.814 ms | 3/3 |
| 1 | Descubrimiento progresivo | 1.455 | 3.181 ms | 3/3 |
| 10 | Function calling | 2.402 | 1.889 ms | 3/3 |
| 10 | MCP stdio | 2.402 | 2.339 ms | 3/3 |
| 10 | MCP HTTP | 2.402 | 1.742 ms | 3/3 |
| 10 | Descubrimiento progresivo | 2.208 | 2.760 ms | 3/3 |
| 50 | Function calling | 10.038 | 2.111 ms | 3/3 |
| 50 | MCP stdio | 10.038 | 2.196 ms | 3/3 |
| 50 | MCP HTTP | 10.038 | 1.795 ms | 3/3 |
| 50 | Descubrimiento progresivo | 2.092 | 2.734 ms | 3/3 |
| 200 | Function calling | 38.684 | 2.178 ms | 3/3 |
| 200 | MCP stdio | 38.684 | 2.498 ms | 3/3 |
| 200 | MCP HTTP | 38.684 | 2.173 ms | 3/3 |
| 200 | Descubrimiento progresivo | 2.100 | 3.808 ms | 3/3 |
| Herramientas | Function calling | MCP | Progresivo |
|---|---|---|---|
| 1 | 682 | 682 | 1.455 |
| 10 | 2.402 | 2.402 | 2.208 |
| 50 | 10.038 | 10.038 | 2.092 |
| 200 | 38.684 | 38.684 | 2.100 |
Los cinco resultados, por orden de importancia:
- Function calling y MCP gastan exactamente los mismos tokens. Ni uno de diferencia, en ninguno de los cuatro tamaños. Se entiende al mirar el flujo: en los dos casos la descripción de todas las herramientas acaba dentro de la petición. Elegir uno u otro por el contexto que ocupan no tiene sentido.
- El coste lo pone el catálogo. Con 200 herramientas, una pregunta de una línea cuesta 38.684 tokens de entrada. Con el precio actual de DeepSeek para su modelo rápido, entre 0,14 y 0,27 € por millón de tokens de entrada según la hora, eso es alrededor de un céntimo por pregunta, y casi todo se va en enviar la lista de herramientas, no en la pregunta.1
- El descubrimiento progresivo apenas crece. Como solo hay un buscador en el contexto, cuesta casi lo mismo con 10 herramientas que con 200: 2.100 tokens con 200, 18 veces menos. Es la idea que Anthropic propone con ejecución de código, aplicada aquí a la lista de herramientas.
- El ahorro se paga con espera. Con 200 herramientas, 3.808 ms frente a 2.178: la petición extra y la búsqueda añaden 1,6 segundos. Y esa espera es solo una parte del total; si lo que tarda es generar la respuesta, las cuentas cambian, como conté en GGUF vs MLX y en FP16 vs BF16.
- La elección no empeoró. El modelo eligió la herramienta correcta en las 48 ejecuciones de la tabla, también con 200 herramientas, entre ellas distractores con nombres que se parecen mucho al de
contar_posts, comocontar_visitasocontar_redirecciones.
Lo que esta prueba no dice. Es una tarea de un solo paso, con una pregunta explícita y un único modelo. Demuestra que este modelo no se pierde con 200 herramientas en esta tarea; no demuestra que nunca se pierda, ni cubre conversaciones largas, ni herramientas que cambian datos. Las latencias incluyen la red y varían con el día. Y en el descubrimiento progresivo, si la búsqueda no encuentra nada, el banco le pasa al modelo la herramienta correcta: su acierto mide cómo elige el modelo, no lo bueno que es el buscador, que en un sistema real habría que medir aparte.
Conectar con un servidor MCP también tiene su coste, y es lo que separa los dos transportes. En el banco, arrancar el servidor como proceso local por stdio tardó entre 100 y 143 ms, mientras que el mismo servidor por HTTP, ya arrancado, respondió en 2 a 11 ms. Si el agente arranca muchas veces al día, esos cien milisegundos pesan; si el proceso sigue vivo, no.
7. Cuando el servidor miente
Llevar las herramientas a un servidor tiene una consecuencia que no se ve hasta que causa un problema: el modelo lee la descripción de cada herramienta como si fuera texto de confianza, y no tiene por qué serlo. Quien escribe esa descripción es el dueño del servidor, no tú.
La guía rápida de seguridad para MCP que publica OWASP recoge los ataques conocidos, y los tres primeros se aprovechan de esa confianza:
- Envenenamiento de herramientas (tool poisoning): instrucciones maliciosas escondidas en la descripción, en el esquema o en el resultado. El modelo las obedece porque para él son parte de las instrucciones.
- El cambiazo (rug pull): el servidor muestra una herramienta inofensiva, el usuario la aprueba y, después, el servidor cambia su definición por otra que no lo es.
- Tool shadowing: la descripción de un servidor malicioso le dice al modelo cómo usar las herramientas de otro servidor de confianza, por ejemplo, que copie a una dirección ajena los correos que envía.
A eso se suman dos problemas más corrientes. El primero es el confused deputy: el servidor actúa con sus propios permisos y no con los del usuario que pidió la acción, así que un servidor con acceso amplio se convierte en la puerta de entrada para todos. El segundo, los permisos de más: dar acceso completo a un buzón cuando bastaba con leerlo. OAuth, el sistema con el que una aplicación pide permiso para actuar en tu nombre sin conocer tu contraseña, permite limitar ese acceso, y la especificación de MCP lo adopta para los servidores remotos.
| Riesgo | Qué hacer |
|---|---|
| Descripción manipulada | Mostrar la descripción completa al aprobar, no solo el nombre |
| Definición que cambia | Guardar una huella (hash) de la definición y pedir revisión si cambia |
| Permisos del servidor | Ejecutar con los permisos del usuario que pide, no con los del servicio |
| Permisos de OAuth | Pedir el mínimo y poder revocarlo a mano |
| Servidores de terceros | Revisar el código o quedarse con los oficiales |
Hay dos trabajos que miden estos ataques en vez de enumerarlos. MCPSecBench reúne 17 ataques en un entorno que cualquiera puede reproducir. Y una comparación entre function calling y MCP con 3.250 escenarios de ataque y siete modelos encontró que con function calling tuvo éxito el 73,5 % de los ataques y con MCP el 62,6 %, que cada arquitectura falla por un sitio distinto y que, al encadenar varios ataques, el éxito subió al 91–96 %. Ningún protocolo es seguro por sí solo. Lo que protege es el host: mostrar lo que se aprueba, vigilar que no cambie y limitar lo que puede hacer después. Es el mismo trabajo que ya hacías con tus herramientas locales, pero ahora la descripción la escribe alguien a quien no conoces.
8. La decisión depende de quién usa la herramienta
En una frase: herramientas solo para tu programa, function calling; herramientas que comparten varias aplicaciones, MCP; más de veinte herramientas, descubrimiento progresivo encima de lo que elijas.
8.1 Los tres casos que deciden
Function calling, cuando las herramientas son tuyas y de nadie más. Escribes la función, la describes en la petición y la ejecutas en tu agente. Sin servidor, sin transporte, sin permisos que repartir. Es la opción sencilla y debería ser la de partida: si no tienes el problema que resuelve MCP, no lo necesitas.
MCP, cuando la herramienta deja de ser solo tuya. Da igual que la usen varias aplicaciones de tu equipo, una aplicación de terceros o el mismo servicio conectado desde Claude, Cursor y VS Code: la escribes una vez y la conectas en todas. Y tiene una ventaja difícil de conseguir por tu cuenta: cada usuario entra con su propia cuenta, da su consentimiento y puede revocarlo, en vez de compartir una clave escrita en el código.
Descubrimiento progresivo, cuando la lista no cabe. No es una alternativa a las dos anteriores, sino una capa encima: en el contexto deja solo un buscador y pide la descripción de cada herramienta cuando hace falta. Sirve con function calling y con MCP, y solo compensa si tienes muchas herramientas.
| Tu caso | Qué usar |
|---|---|
| Herramientas propias, un solo agente, pocas herramientas | Function calling |
| Varias aplicaciones o personas comparten las herramientas | MCP, con un servidor |
| Cada usuario con su propia cuenta | MCP con OAuth por usuario |
| El agente arranca muchas veces al día | MCP por HTTP; stdio arranca el proceso cada vez |
| Más de veinte herramientas, y creciendo | Descubrimiento progresivo, encima de lo que elijas |
| Necesitas controlar tú los permisos y el registro | Function calling, o MCP con un host que lo haga |
8.2 Lo que no cambia al elegir
El resultado de las pruebas cabe en una frase: MCP ocupa en el contexto lo mismo que function calling, ni un token más ni uno menos. Lo que cambia es quién escribe la descripción de las herramientas y, sobre todo, cuántas envías de golpe. Cambiar de protocolo no te va a ahorrar contexto; recortar la lista, sí.
Para no escribir lo que ya existe, el catálogo oficial de servidores MCP es el punto de partida. La lista de aplicaciones compatibles dice en qué aplicaciones funciona sin tocar nada, y los ejemplos oficiales muestran uno de cada tipo.
Si tu agente tiene más de veinte herramientas, mide los tokens del catálogo antes de cambiar de protocolo: en esta prueba, con 200 herramientas, una pregunta costaba 38.684 tokens de entrada, y descubrirlas sobre la marcha lo dejaba en 2.100.
9. Enlaces y vídeos de interés
9.1 Artículos
- MCP vs tool calls for AI agents — la guía práctica más completa que he encontrado sobre cuándo usar cada uno; sin medición propia.
- MCP vs OpenAPI tool calling: latency and token benchmarks — un benchmark de latencia y tokens que compara MCP con herramientas descritas en OpenAPI.
- FastMCP — la guía de inicio de la biblioteca con la que está escrito el servidor del banco de pruebas.
- De function calling a MCP — una explicación conceptual en español que sirve de contraste.
9.2 Vídeos
Clase de Stanford (CS329Z): el mismo recorrido del post —el modelo elige la herramienta y el agente la ejecuta— con function calling y MCP en la misma pizarra. En inglés.
Taller completo de AI Engineer sobre agentes con MCP: presentación entre cliente y servidor, servidores y clientes en vivo. Largo, pero es el que mejor muestra el protocolo funcionando. En inglés.
Montar un servidor MCP en Python y conectarlo a un cliente, paso a paso. Complementa la sección 5 con lo que el código no muestra: qué se ve al arrancarlo. En inglés.
Al cambio de referencia del BCE del 13 de noviembre de 2026, 1 dólar = 0,905 €. DeepSeek publica 0,15 dólares fuera de hora punta y 0,30 dólares en hora punta por millón de tokens de entrada sin caché. ↩︎